
可观测性与稳定性 / 系统课时
设计 Tail Sampling 与遥测成本预算
设计 Tail Sampling 与遥测成本预算
Tail Sampling 要解决的是 Head Sampling 看不到最终结果的问题:先暂存一条 Trace 的 Span,等错误、延迟和业务属性足够完整后再决定保留或丢弃。本篇给出一组可落地的规则,并把内存、等待时间、容量和后端费用放进同一个预算模型。
学习目标
- 根据错误、延迟和业务属性设计 Tail Sampling 保留规则
- 估算等待窗口对内存、吞吐和决策延迟的影响
- 设计 Trace 路由、决策缓存和后端费用的容量边界
Tail Sampling 为什么需要集中决策
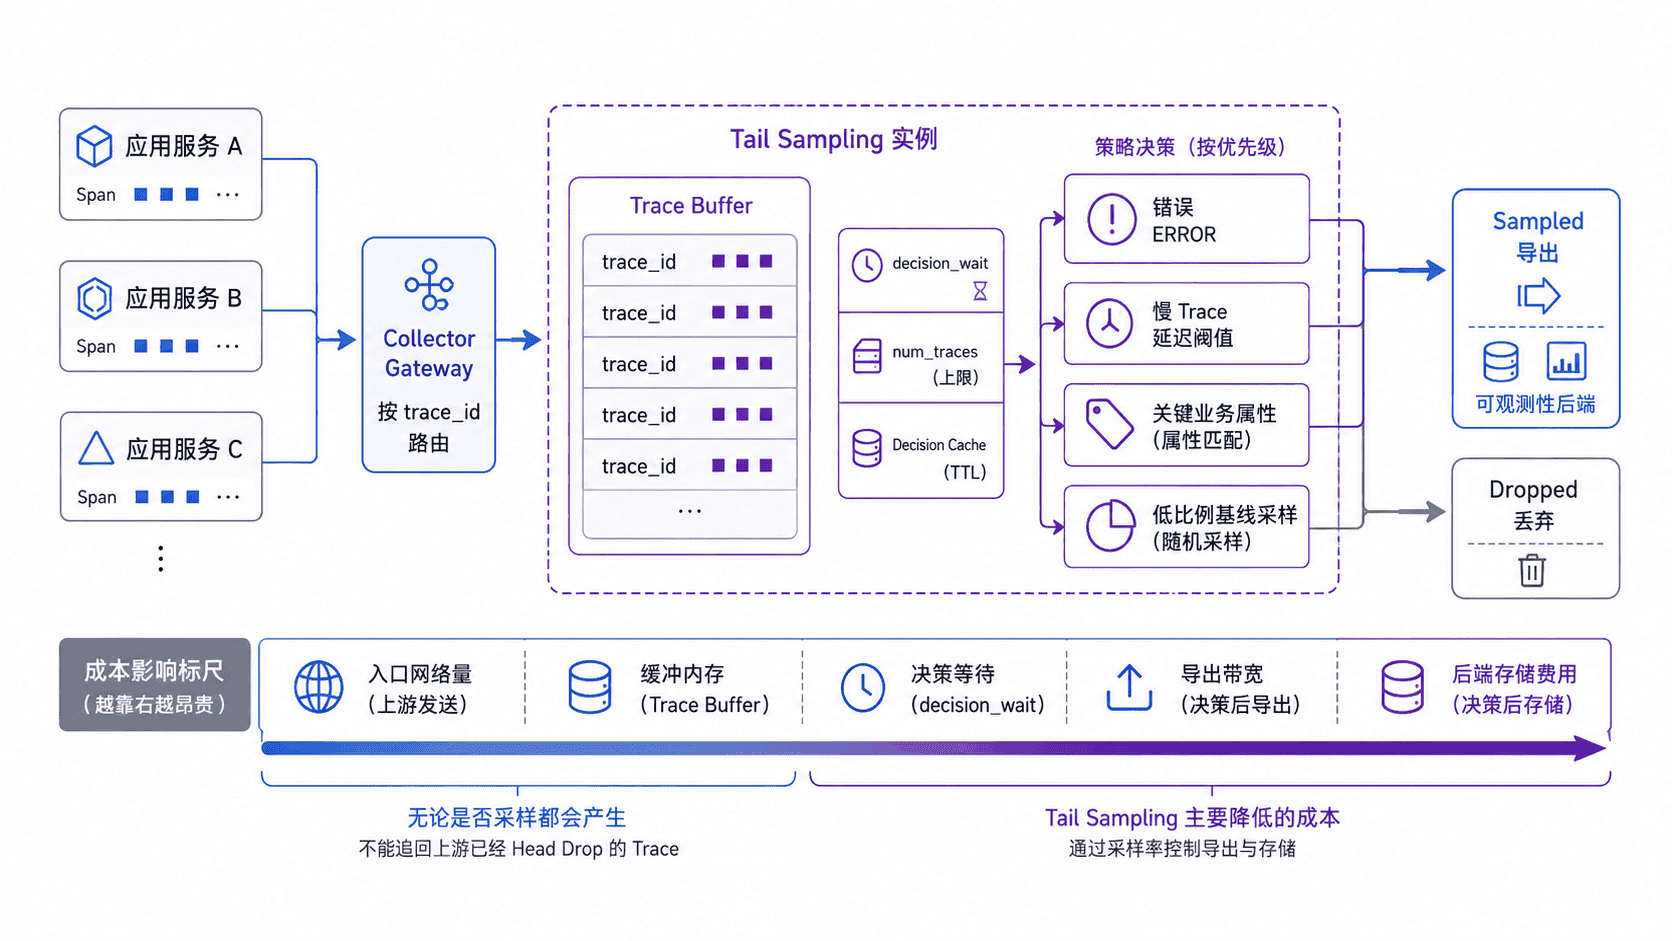
Tail Sampling 的判断发生在 Trace 已经产生之后,因此 Collector 必须按 trace_id 聚合同一条 Trace 的 Span,并等待一段时间再评估。这样它可以知道是否出现 ERROR、总耗时是否超过阈值,或者某个业务属性是否值得保留。
这种能力以状态为代价:同一条 Trace 的所有 Span 应进入同一个 Tail Sampling 实例,否则单个实例只看到残缺数据,错误、延迟和业务规则都可能误判。等待窗口越长,完整性通常越好,但内存占用和决策延迟也会同步增加。
用高价值规则覆盖低比例基线
一个实用策略通常不是只设“保留 5%”,而是先全量保留高价值 Trace,再用低比例策略覆盖普通流量。下面的 Collector Contrib 配置保留错误 Trace、超过 1.5 秒的慢 Trace、业务优先级为 critical 的 Trace,并对其余流量保留 5% 基线样本。
processors:
  batch:
  tail_sampling:
    decision_wait: 10s
    num_traces: 50000
    expected_new_traces_per_sec: 2000
    decision_cache:
      sampled_cache_size: 100000
      non_sampled_cache_size: 500000
    policies:
      - name: keep-errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: keep-slow
        type: latency
        latency:
          threshold_ms: 1500
      - name: keep-critical-business
        type: string_attribute
        string_attribute:
          key: business.priority
          values: [critical]
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 5

service:
  pipelines:
    traces:
      processors: [tail_sampling, batch]
预期结果:满足错误、慢 Trace 或关键业务属性任一条件的 Trace 会被保留;未命中这些高价值条件的普通 Trace 仍有约 5% 被保留作为基线样本。decision_cache 保存已经做出的 keep/drop 决策,帮助晚到 Span 延续同一结果,但它不替代等待期间保存完整 Trace 数据的缓冲区。
验证时应同时观察 Tail Sampling 处理器的接收量、采样后导出量、缓冲容量和丢弃指标,并用一组已知错误、已知慢请求和普通请求检查规则命中是否符合预期。属性规则只能依赖在决策前已经到达且命名稳定的遥测字段,避免把临时字段或高敏感业务数据直接作为采样条件。
把等待窗口换算成容量
Tail Sampling 最重要的容量关系可以先用近似值估算:待决策 Trace 数约等于“每秒新 Trace 数 × 等待秒数”。例如峰值每秒 2000 条新 Trace、decision_wait 为 10 秒,仅等待窗口就可能同时积压约 20000 条 Trace。
内存预算还要乘上单条 Trace 的平均字节数以及实现开销。若平均每条 Trace 暂存数据约 20 KB,仅原始 Trace 数据就接近 400 MB;实际运行还要给对象、索引、队列、决策缓存和突发流量留余量。因此 num_traces 不应只按平均流量设置,而应覆盖峰值窗口并保留安全空间。
expected_new_traces_per_sec 更接近容量规划提示,不应把它理解成硬限流器。真正的费用预算则要从采样后的字节量看:错误、慢请求和关键业务 Trace 的命中率越高,最终保留率就可能显著高于 5% 的基线比例。
延迟、缓存与费用之间的取舍
decision_wait 太短时,晚到 Span 可能在决策后才抵达,导致 Trace 不完整;太长时,则增加内存压力并推迟 Trace 进入后端的时间。应根据实际 P99 Trace 持续时间、异步任务特征和网络抖动选择窗口,而不是直接照搬固定秒数。
决策缓存用于记住已经完成的 keep/drop 结果。若系统绝大多数 Trace 都被丢弃,通常需要为 non-sampled 决策准备更大的缓存;缓存太小会让晚到 Span 在原决策失效后产生额外不一致风险,缓存太大则继续占用 Collector 内存。
还要区分“采样前成本”和“采样后成本”。Tail Sampling 之前,应用仍然生成 Span,Span 仍要经过网络进入做决策的 Collector,所以它主要减少后续导出带宽和后端存储,并不能消除前半段成本。若 SDK 在上游已经使用很低的 Head Sampling,Tail Sampling 也无法恢复那些从未被发送的错误 Trace。
部署时先保证 Trace 不被拆散
单实例时问题最简单;水平扩容后,随机负载均衡可能把同一 trace_id 的 Span 分散到多个 Tail Sampling 实例。生产部署应在 Tail Sampling 前增加按 Trace ID 保持亲和性的路由层,让同一条 Trace 稳定落到同一决策实例。
容量验收至少要覆盖峰值 Trace 速率、最大常见 Trace 大小、长尾延迟、Collector 重启和实例扩缩容场景。最终目标不是把采样率压到最低,而是在明确的内存与费用预算内,优先留下最能解释故障、性能和关键业务行为的 Trace。