
可观测性与稳定性 / 系统课时
理解 Trace、Span 与时序关系
理解 Trace、Span 与时序关系
本节把分布式追踪里最容易混淆的几个对象拆开:Trace 是一次端到端工作的整体,Span 是其中一个有时间边界的操作。读完后,你能根据 Trace ID、Span ID、父子关系、SpanKind 和时间轴判断一条调用链真正发生了什么。
学习目标
- 区分 Trace ID、Span ID 与 Parent Span ID 的职责
- 根据父子关系和 SpanKind 还原跨服务调用语义
- 从 Span 的开始与结束时间判断并行、串行和关键路径
先把标识符分清
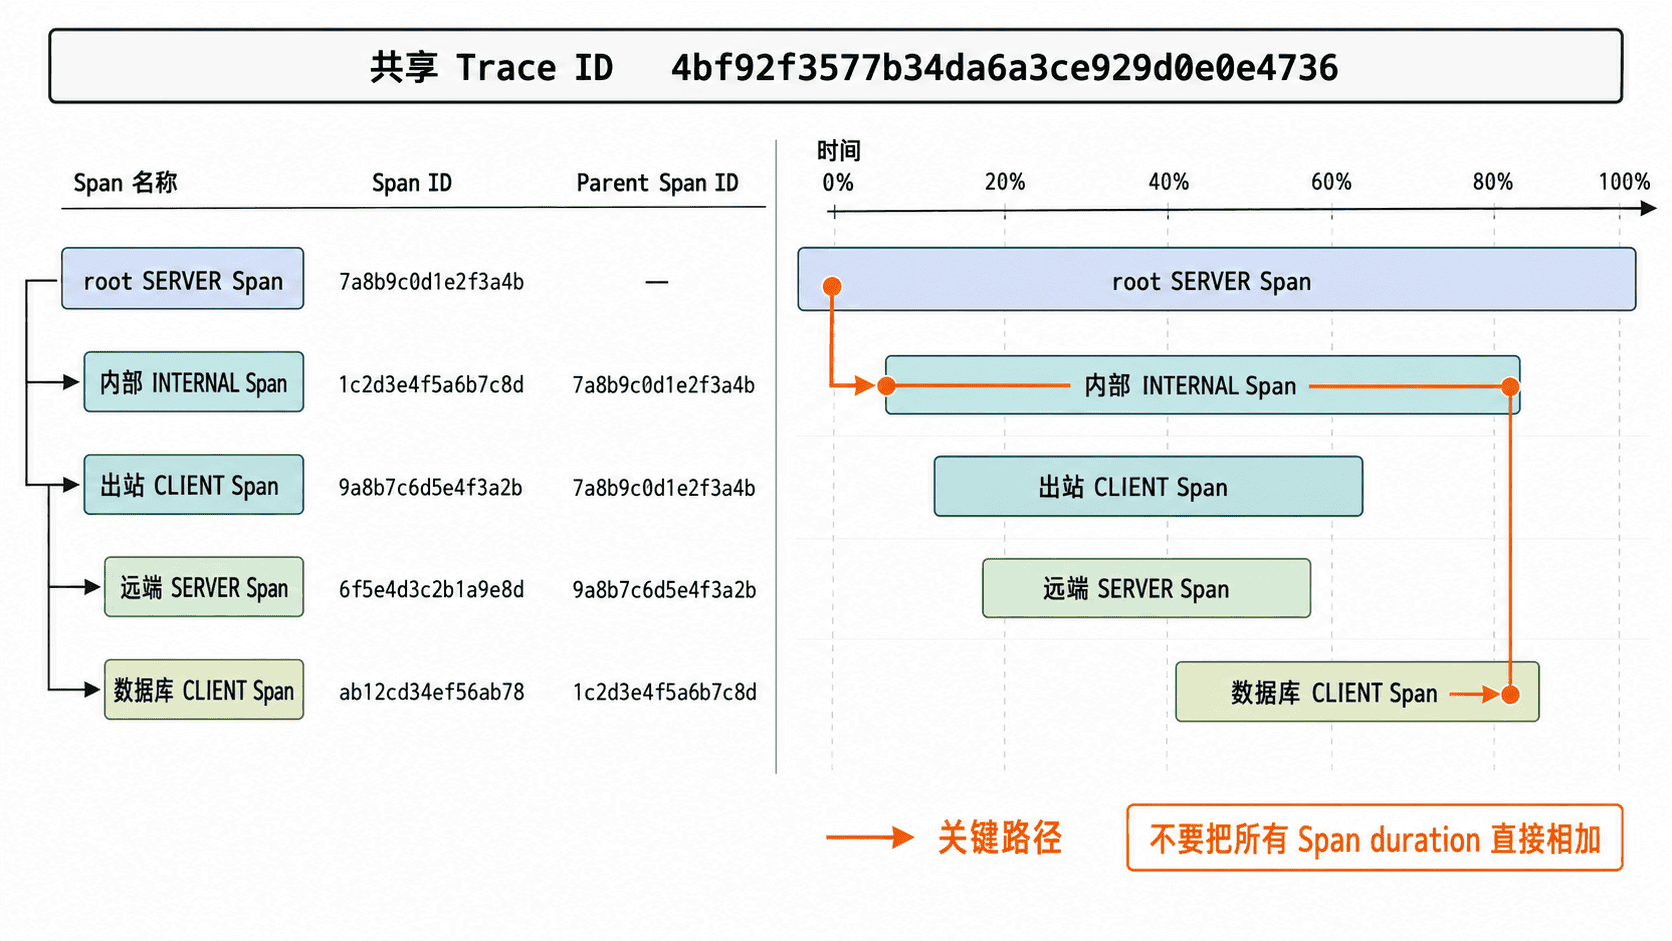
一个 Trace 由一个根 Span 和零个或多个后代 Span 组成。同一 Trace 中的 Span 共享同一个 Trace ID,但每个 Span 都有自己的 Span ID;子 Span 通过父 Span 的 Span ID 建立因果层级。根 Span 没有父 Span,因此它是整棵 Trace 树的入口。
OpenTelemetry 的有效 Trace ID 是 16 字节,通常显示为 32 个十六进制字符;Span ID 是 8 字节,通常显示为 16 个十六进制字符。排障时先用 Trace ID 聚合同一次端到端请求,再用 Span ID 与父标识定位具体操作,避免把“同一请求”和“同一操作”混为一谈。
SpanKind 描述的是操作角色
SpanKind 不是“父 Span 或子 Span”的同义词,而是说明这个 Span 在调用边界上的角色。父子关系回答“谁由谁触发”,SpanKind 回答“这个操作在边界两侧扮演什么角色”。
| SpanKind | 典型含义 |
|---|---|
INTERNAL |
进程内部工作,没有跨进程边界 |
SERVER |
处理从外部进入的同步请求 |
CLIENT |
发起到外部服务或数据库的同步请求 |
PRODUCER |
发送消息或创建延迟执行的工作 |
CONSUMER |
接收并处理消息或延迟工作 |
例如,服务 A 接收 HTTP 请求时通常记录 SERVER Span;它调用服务 B 前记录 CLIENT Span。服务 B 从传播上下文中取得远端父上下文,再创建自己的 SERVER Span。两边的 Span ID 不同,但仍共享同一个 Trace ID。
时间边界决定瀑布图怎么读
Span 的开始时间和结束时间描述该操作实际覆盖的时间窗口,持续时间就是两者之差。多数同步请求的瀑布图里,根 Span 往往覆盖主要子操作,但规范并不要求父 Span 的结束时间一定晚于所有子 Span;父子关系表达因果,不等于严格的时间包含关系。
两个子 Span 的时间区间可以重叠,这往往表示并发或异步工作。因此,看到三个各耗时 100 ms 的子 Span,不能直接推断根 Span 耗时 300 ms。如果它们同时开始并大幅重叠,根 Span 可能只增加约 100 ms;若它们存在严格依赖并依次执行,才更接近累加效果。
关键路径比最长 Span 更重要
关键路径是决定端到端完成时间的那条依赖链。它不一定等于“持续时间最长的单个 Span”,也不等于“所有 Span 时长之和”。一个很慢但与主流程并行、且在根 Span 结束前提前完成的子操作,可能不是当前请求延迟的决定因素。
实际阅读 Trace 时,可以先找到根 Span 的时间边界,再沿父子关系观察哪些操作必须等待前一步完成,最后标出从请求开始到请求完成之间无法被并行隐藏的连续等待链。这样得到的关键路径,才是优化端到端延迟时最值得优先处理的位置。