
React / 系统课时
接入日志与监控
接入日志与监控
线上故障通常只给你一个现象:请求变慢、接口报错或用户反馈失败。本节把 Next.js 请求日志、服务端异常和可聚合的运行指标串成一条最小证据链,让一次请求能够被定位、统计并触发后续告警。
学习目标
- 为 Route Handler 输出可检索、可聚合的结构化请求日志
- 使用
instrumentation.ts捕获 Next.js 服务端请求错误 - 从请求量、错误率和延迟字段建立最小监控与告警信号
先定义一条可关联的证据链
生产日志至少要回答“什么时候、哪个请求、什么结果、耗时多久”。不要只打印自然语言字符串;稳定字段更容易被日志平台解析,再聚合为请求量、错误率和延迟分位数。异常则应额外记录路由上下文和错误类型,但不要写入 Cookie、Authorization 或业务敏感载荷。
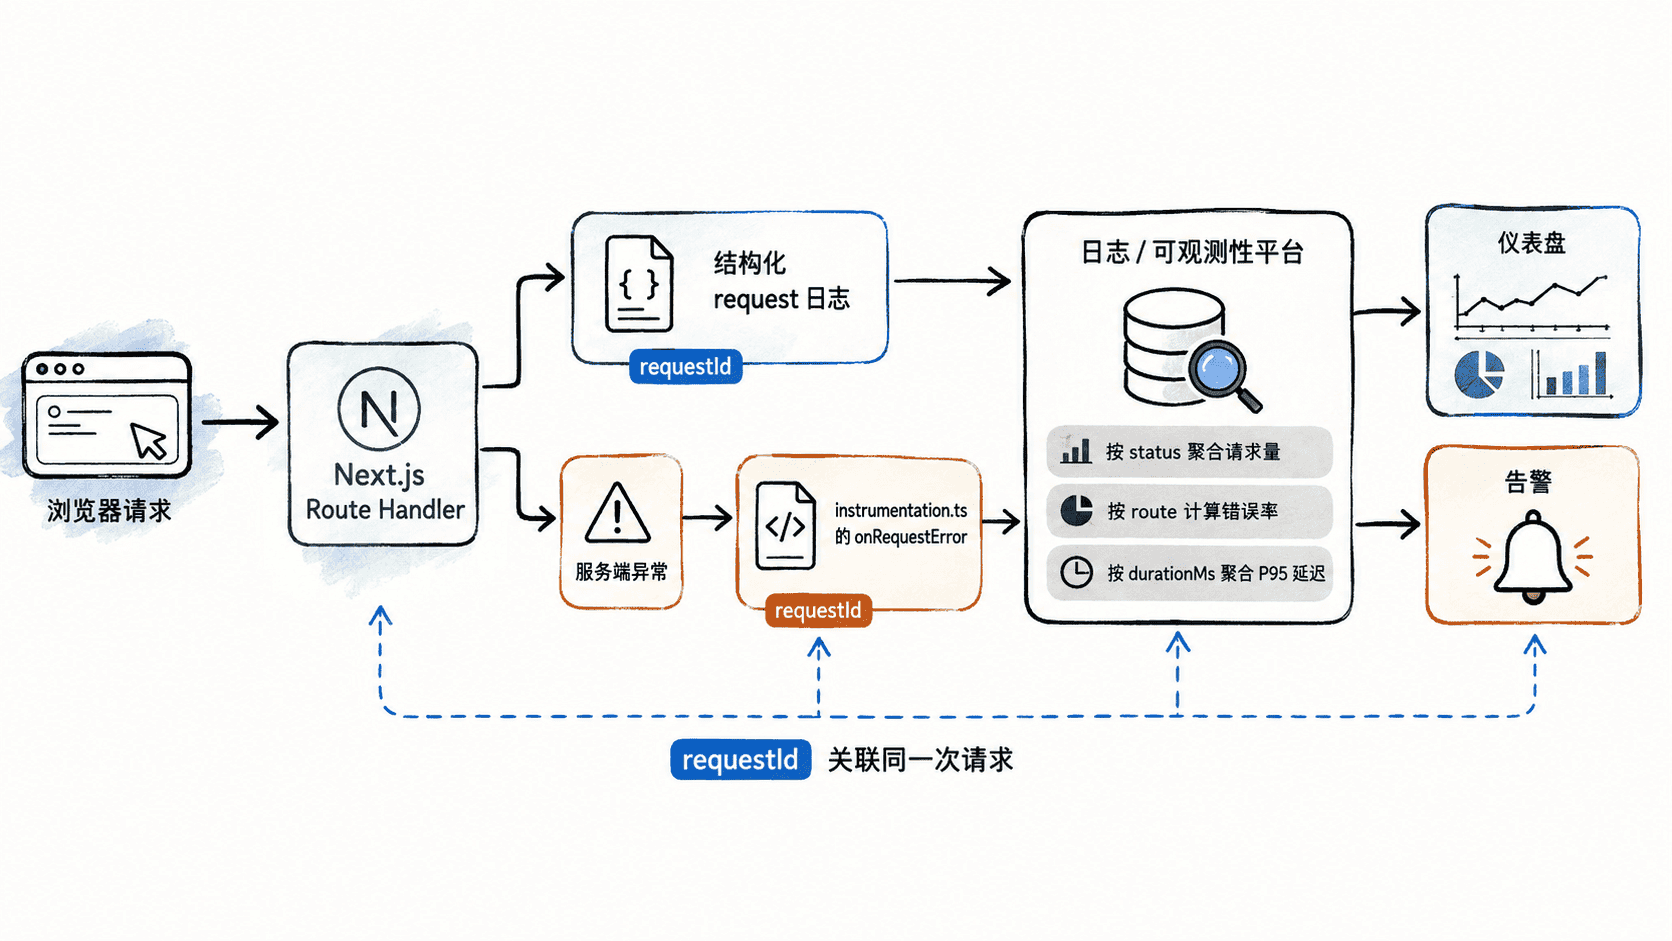
记录结构化请求日志
下面的 Route Handler 为每次请求生成 requestId,在完成时输出单行 JSON。字段保持低基数:路由、状态码、耗时和请求 ID 足够支撑第一轮排障。
import { randomUUID } from 'node:crypto'

export async function GET() {
  const startedAt = performance.now()
  const requestId = randomUUID()

  const body = { ok: true }

  console.info(JSON.stringify({
    level: 'info',
    event: 'request.complete',
    requestId,
    route: '/api/health',
    method: 'GET',
    status: 200,
    durationMs: Math.round(performance.now() - startedAt),
  }))

  return Response.json(body, {
    headers: { 'x-request-id': requestId },
  })
}
启动项目后请求接口:
curl -s http://localhost:3000/api/health预期输出:
{"ok":true}服务端终端还会出现一条结构化日志,动态值会因请求不同而变化:
{"level":"info","event":"request.complete","requestId":"<ID>","route":"/api/health","method":"GET","status":200,"durationMs":<VALUE>}requestId 用来串联同一次请求的日志;durationMs 可聚合成 P50、P95 或 P99 延迟。不要把用户 ID、完整 URL 查询串等高基数字段直接做成监控标签,否则成本和查询复杂度都会快速上升。
捕获框架级服务端异常
在项目根目录创建 instrumentation.ts。Next.js 会在服务实例启动时加载该文件,并在框架捕获服务端请求错误时调用 onRequestError。这里先输出结构化错误事件,生产环境可把同样字段发送到你的日志或错误监控平台。
import type { Instrumentation } from 'next'

export const onRequestError: Instrumentation.onRequestError = async (
  err,
  request,
  context,
) => {
  const message = err instanceof Error ? err.message : String(err)
  const digest =
    typeof err === 'object' && err !== null && 'digest' in err
      ? String(err.digest)
      : undefined

  console.error(JSON.stringify({
    level: 'error',
    event: 'request.error',
    message,
    digest,
    path: request.path,
    method: request.method,
    routePath: context.routePath,
    routeType: context.routeType,
  }))
}
这是配置型代码,生效验证方法是让一个测试 Route Handler 主动抛出异常,再确认服务端出现 request.error 事件。若后续改为异步上报错误平台,要在 onRequestError 中等待上报 Promise 完成,避免进程提前结束导致事件丢失。
从日志字段建立最小监控
有了稳定字段后,先监控三个最能反映用户体验的信号:请求量、错误率和延迟。日志平台可以按固定时间窗口统计 request.complete 数量,以 status >= 500 计算错误请求,并对 durationMs 求分位数。
告警阈值要与业务基线绑定,而不是看到单个 500 就报警。例如可以要求“连续多个窗口错误率超过阈值”或“P95 延迟持续恶化”再通知值班人员。这样既能发现真实事故,又能避免偶发错误造成告警风暴。
验收监控链路
上线前至少完成一次受控演练:正常请求应留下 request.complete;故意触发的服务端异常应留下 request.error;监控平台能按路由查看请求量、错误率和延迟趋势;告警消息中能给出时间窗口和路由,而不是只写“应用异常”。
当这些证据可以通过 requestId、路由和时间窗口互相印证时,排障就从“翻日志猜原因”变成了可重复的定位流程。之后再接入 OpenTelemetry、集中式日志或 APM,也应继续保留这套稳定字段和敏感数据边界。