
React / 系统课时
并行加载数据
并行加载数据
多个数据源彼此独立时,连续 await 会把等待时间叠加成请求瀑布。本节把独立任务同时启动,并用 Promise.all() 一次等待结果,让页面的总等待时间主要由最慢请求决定,而不是所有请求耗时之和。
学习目标
- 判断哪些数据请求可以并行、哪些存在前后依赖
- 在 Next.js Server Component 中使用
Promise.all()同时等待独立任务 - 根据失败策略、连接池和限流约束决定是否继续扩大并发
先识别请求瀑布
如果请求 B 不需要请求 A 的结果,却写成“等待 A 完成后再开始 B”,就产生了不必要的串行等待。三个分别耗时 600、900、700 ms 的独立任务若顺序执行,理论等待接近 2200 ms;同时启动时则主要等待最慢的 900 ms 任务。
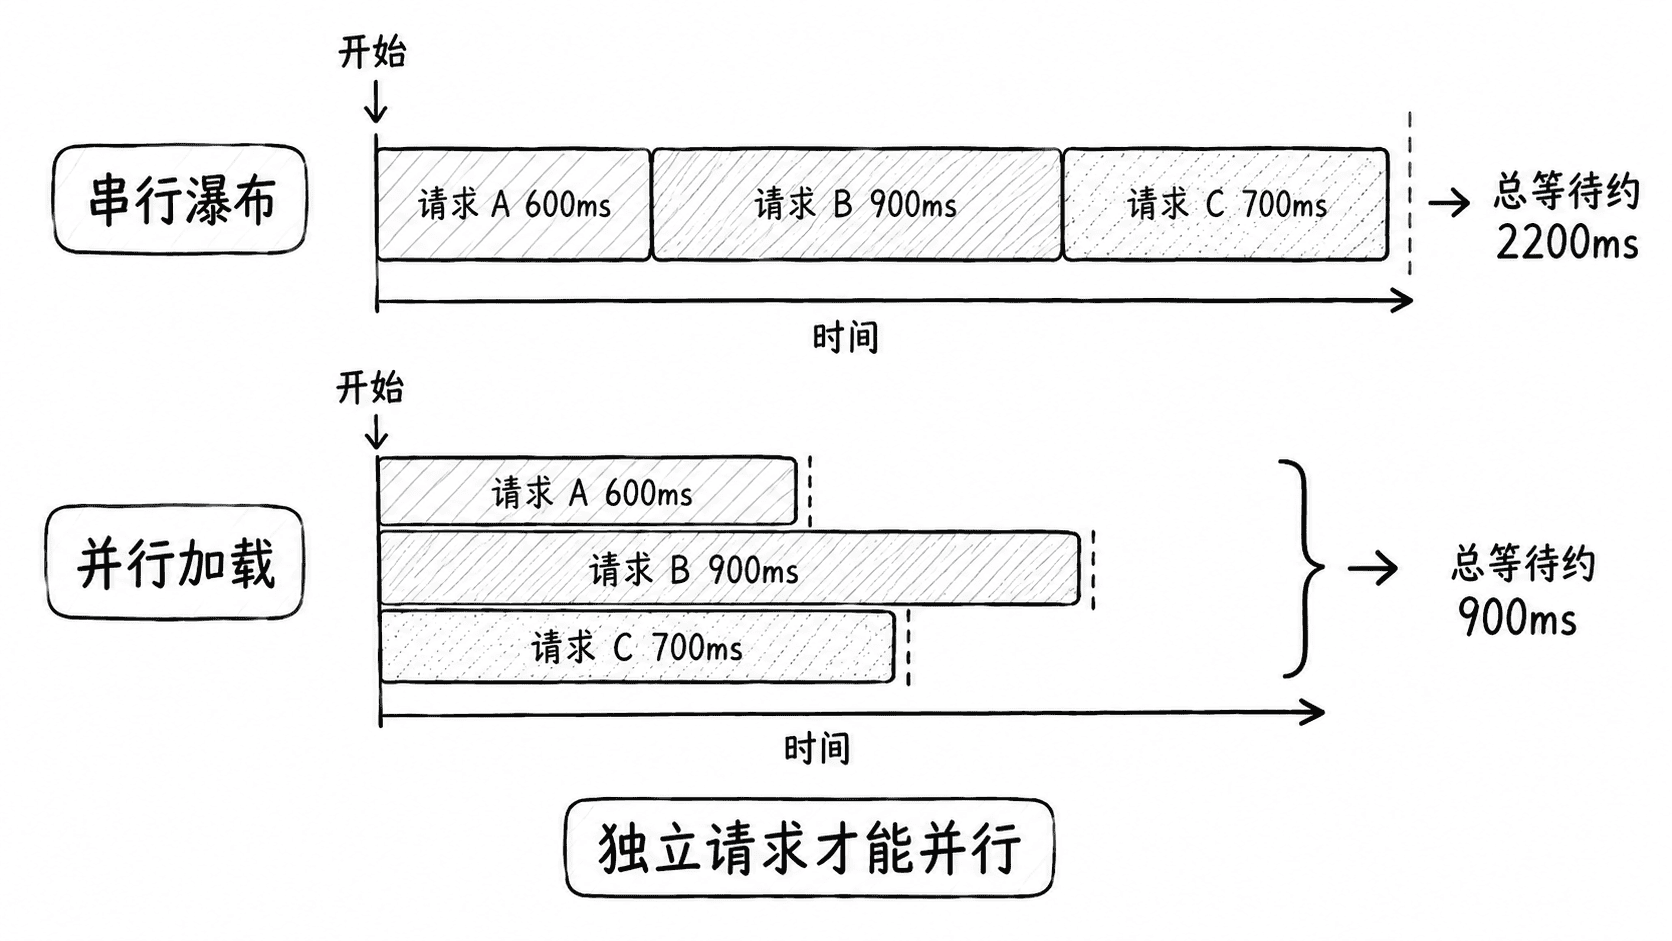
是否能并行只看数据依赖,不看代码位置。例如“先查用户 ID,再用 ID 查订单”必须保留依赖链;“查订单总数、用户总数、收入”互不依赖,就应尽量在同一层同时发起。
用 Promise.all 同时等待
下面的 app/page.tsx 用延迟函数模拟三个独立数据源。它是完整的 Server Component 示例,不依赖外部 API,因此可以直接观察并行等待的差异。
type Metric = {
  label: string
  value: number
}

async function loadMetric(
  label: string,
  value: number,
  delayMs: number,
): Promise<Metric> {
  // 用延迟模拟数据库或 HTTP 请求的响应时间。
  await new Promise<void>((resolve) => setTimeout(resolve, delayMs))
  return { label, value }
}

export default async function Page() {
  const startedAt = Date.now()

  // 三个 Promise 在同一阶段创建,不互相等待。
  const [orders, users, revenue] = await Promise.all([
    loadMetric('订单', 128, 600),
    loadMetric('用户', 42, 900),
    loadMetric('收入', 8600, 700),
  ])

  const elapsed = Date.now() - startedAt

  return (
    <main>
      <p>{orders.label}:{orders.value}</p>
      <p>{users.label}:{users.value}</p>
      <p>{revenue.label}:{revenue.value}</p>
      <p>服务端等待约 {elapsed} ms</p>
    </main>
  )
}
预期结果
订单:128
用户:42
收入:8600
服务端等待约 <TIME> ms
<TIME> 会受开发服务器负载影响,通常接近最慢任务的 900 ms,而不是三个延迟相加后的 2200 ms。这里的关键动作是先创建所有独立 Promise,再统一等待它们完成。
处理失败边界
Promise.all() 采用快速失败语义:任意一个 Promise 被拒绝,整体等待就会被拒绝。页面必须“全部数据齐全才成立”时这很合适;如果某块数据失败后其他区域仍应展示,可以改用 Promise.allSettled(),或者把独立区域拆到不同组件和错误边界中。
不要为了追求并行而打断真实依赖。第二个请求需要第一个请求返回的 ID、令牌或分页游标时,顺序等待就是正确模型;强行并行只会制造无效请求或额外分支。
控制并发规模
并行请求减少的是无意义的串行等待,不是让请求数量无限增长。数据库连接池、第三方 API 限流和服务端资源都可能成为新的瓶颈。几十或上百个同类请求时,应优先批量查询、合并接口或限制并发,而不是把所有任务直接塞进一个巨大的 Promise.all()。
验收时同时检查结果正确性与等待时间:独立任务应在同一阶段开始,页面仍要正确处理任一数据源失败的情况。做到“无依赖就并行,有依赖就串行”,才是可维护的数据加载策略。