
React / 系统课时
设计数据模型
设计数据模型
本节用一个最小内容系统把“用户、内容、业务关系”落到可执行的数据表上。完成后,你会得到一套能支持作者发布内容、用户点赞,并且能通过约束避免脏数据的 PostgreSQL 核心模型。
学习目标
- 从业务关系识别实体、主键和外键
- 用唯一约束与检查约束保护关键业务规则
- 为高频查询选择必要索引,避免过早堆索引
先从业务关系反推表
不要先想“需要几张表”,先写清事实:一个用户可以发布多篇内容;一篇内容只能有一个作者;用户可以给多篇内容点赞,同一用户对同一篇内容最多点赞一次。
这三个事实分别对应一对多和多对多关系。app_user 保存用户实体,post 通过 author_id 指向作者,post_like 则把用户与内容的多对多关系拆成独立关系表。关系表本身也是业务事实,因此应有自己的约束,而不是把点赞用户 ID 数组塞进 post。
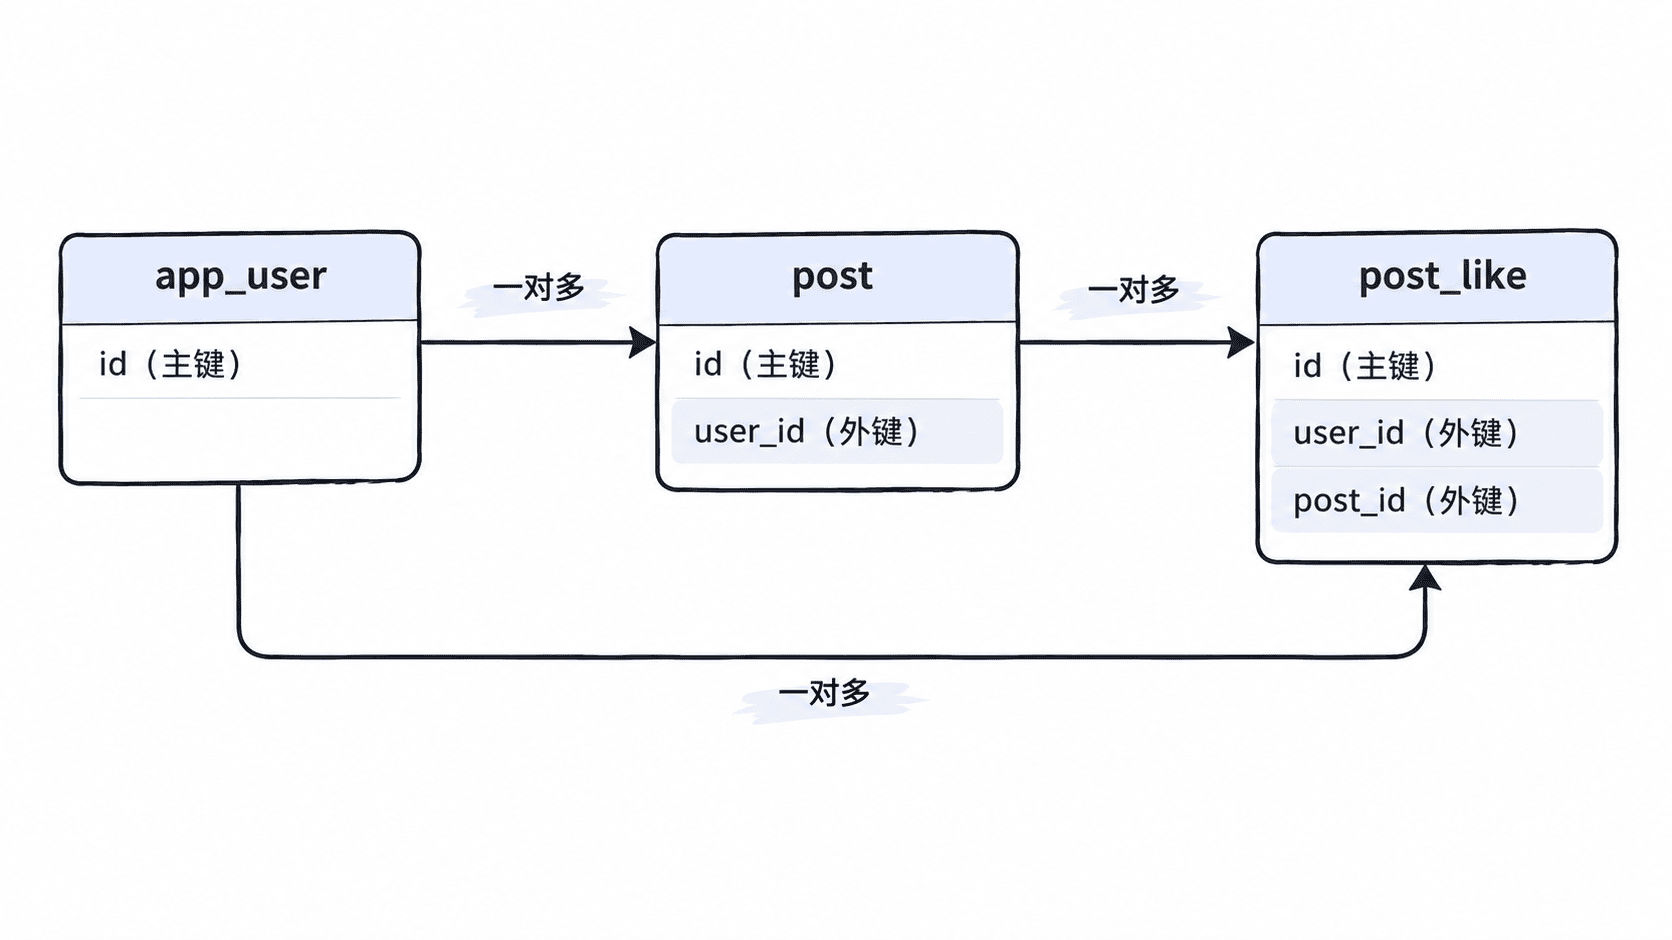
用约束把业务规则写进数据库
下面的 PostgreSQL 示例可以直接在空数据库执行。它使用数据库约束保证邮箱唯一、内容状态合法,以及同一用户不能重复点赞同一篇内容。
CREATE TABLE app_user (
  id BIGSERIAL PRIMARY KEY,
  email TEXT NOT NULL UNIQUE,
  display_name TEXT NOT NULL,
  created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE TABLE post (
  id BIGSERIAL PRIMARY KEY,
  author_id BIGINT NOT NULL REFERENCES app_user(id) ON DELETE RESTRICT,
  title TEXT NOT NULL,
  slug TEXT NOT NULL UNIQUE,
  status TEXT NOT NULL DEFAULT 'draft'
    CHECK (status IN ('draft', 'published')),
  created_at TIMESTAMPTZ NOT NULL DEFAULT NOW()
);

CREATE TABLE post_like (
  user_id BIGINT NOT NULL REFERENCES app_user(id) ON DELETE CASCADE,
  post_id BIGINT NOT NULL REFERENCES post(id) ON DELETE CASCADE,
  created_at TIMESTAMPTZ NOT NULL DEFAULT NOW(),
  PRIMARY KEY (user_id, post_id)
);

CREATE INDEX idx_post_author_id ON post(author_id);
CREATE INDEX idx_post_like_post_id ON post_like(post_id);

INSERT INTO app_user (email, display_name)
VALUES ('alice@example.com', 'Alice');

INSERT INTO post (author_id, title, slug, status)
VALUES (1, 'First Post', 'first-post', 'published');

INSERT INTO post_like (user_id, post_id)
VALUES (1, 1);

SELECT p.slug, u.display_name AS author, COUNT(pl.user_id) AS likes
FROM post AS p
JOIN app_user AS u ON u.id = p.author_id
LEFT JOIN post_like AS pl ON pl.post_id = p.id
GROUP BY p.id, p.slug, u.display_name;
预期结果
    slug    | author | likes
------------+--------+-------
 first-post | Alice  |     1
不同 PostgreSQL 客户端的表格边框可能略有差异,但结果应包含 first-post、Alice 和点赞数 1。
给查询路径建立索引
主键和唯一约束已经会创建索引,因此不要重复为 app_user.id、post.slug 或 post_like(user_id, post_id) 建同类索引。主示例额外创建的 idx_post_author_id 与 idx_post_like_post_id,分别服务“按作者查内容”和“按内容统计点赞”这类从外键反向查询。
可用 EXPLAIN 验证实际执行计划;小数据量下优化器仍可能选择顺序扫描,这是正常现象。索引是否值得保留,应由真实查询模式决定,而不是看到外键就机械添加。
在 Next.js 中保持边界清晰
数据模型应表达稳定业务规则,而不是页面组件结构。页面路由改名不应该迫使数据库表改名;相反,唯一性、引用完整性、删除行为等跨请求都必须成立的规则,应该尽量由数据库约束兜底。
设计完成时至少检查三件事:每张表是否代表明确事实、关系是否能由外键表达、重复或非法状态是否会被约束拒绝。满足这三点,后续无论使用 Prisma、Drizzle 还是直接 SQL,都有可靠的数据基础。