
操作系统 / 系统课时
怎样定位 IPC 延迟突然升高
怎样定位 IPC 延迟突然升高
IPC 延迟突然升高时,先判断时间花在系统调用等待、进程调度、锁竞争还是用户态处理,再把调用耗时、上下文切换和队列积压放到同一时间窗口里核对,才能避免凭单一指标误判。
学习目标
- 用
strace找出长时间阻塞的 IPC、锁和等待类系统调用 - 用
perf与 procfs 判断上下文切换、迁移和运行状态是否异常 - 结合消息队列状态建立从“现象”到“根因”的证据链
先把延迟拆成几个等待点
一次 IPC 请求可能同时经历发送方排队、内核同步、接收方被调度、用户态处理和返回路径。若只看总耗时,就无法判断是队列满导致发送阻塞,还是接收进程拿不到 CPU,或是某把锁让所有工作进程停在 futex 上。
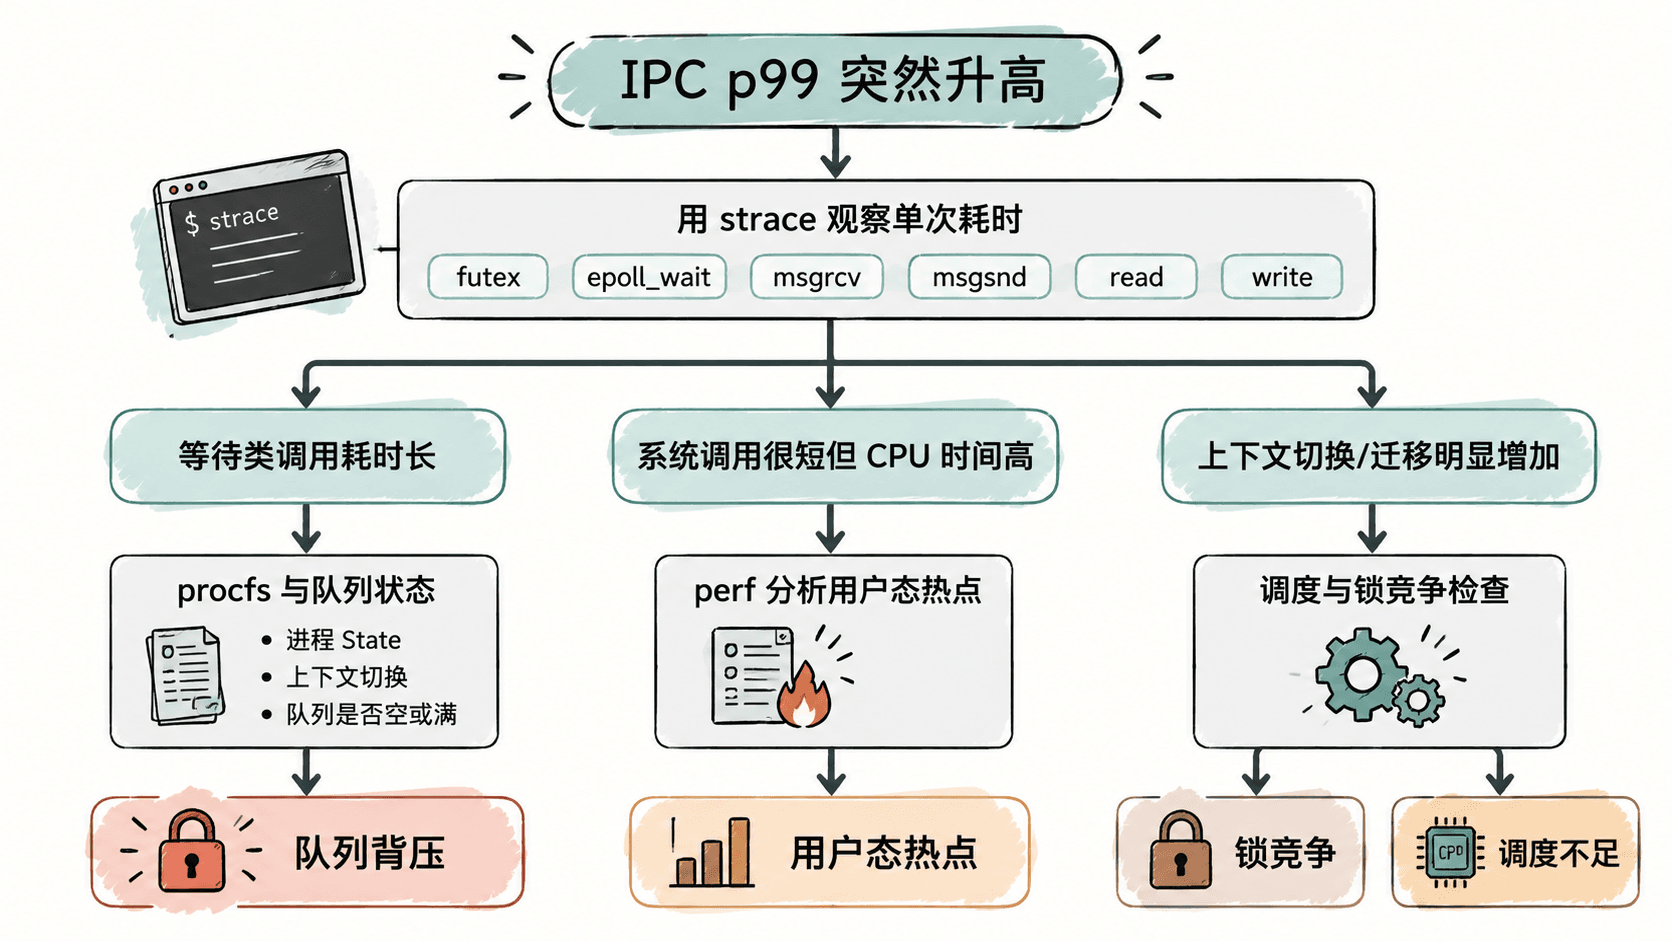
排查时要固定观察窗口,例如同一段 5 秒高延迟区间,同时采集系统调用、调度统计和队列状态。不同时间点的数据很容易把因果关系打乱。
用一组命令采集同一窗口
下面是片段示例,需要已知目标进程 PID,并具有读取目标进程与性能计数器的权限。运行前把 <ID> 替换成实际 PID;不同内核的权限策略可能要求 sudo。
PID="${1:?usage: sudo bash ipc-diag.sh <ID>}"
sudo timeout 5s strace -f -ttT -p "$PID" -e trace=futex,epoll_wait,ppoll,msgrcv,msgsnd,read,write
sudo perf stat -p "$PID" -e task-clock,context-switches,cpu-migrations,page-faults -- sleep 5
grep -E '^(State|voluntary_ctxt_switches|nonvoluntary_ctxt_switches):' "/proc/$PID/status"
ipcs -q
预期结果
strace: 每条被跟踪的系统调用带时间戳,并在行末给出该调用耗时
perf stat: 给出 5 秒窗口内的 task-clock、context-switches、cpu-migrations、page-faults 统计
procfs: 输出 State、voluntary_ctxt_switches、nonvoluntary_ctxt_switches
ipcs -q: 若使用 System V 消息队列,输出队列列表及 used-bytes、messages 等状态列这些值没有固定正确数值,应与服务平稳期基线比较。ipcs -q 只适用于 System V 消息队列;POSIX 消息队列应结合 /dev/mqueue、应用自身的队列深度指标和对应系统调用一起判断。
按证据链解释结果
若 msgsnd 明显变慢,同时队列消息数或已用字节持续接近上限,优先怀疑消费者处理不过来形成背压。若 msgrcv 或 epoll_wait 长时间等待,但队列始终为空,更可能是上游没有及时产生数据,而不是接收进程“性能差”。
若大量时间停在 futex,同时自愿上下文切换明显增加,应继续检查互斥锁、条件变量或进程共享同步原语是否出现竞争。相反,如果系统调用都很短,但 task-clock 很高,说明延迟更可能发生在用户态计算,此时再用 perf top 或 perf record 定位热点才有意义。
进程 State 也要结合现场解读:长时间处于睡眠状态不一定异常,关键是它在等什么;若 CPU 利用率不高却伴随大量切换和迁移,调度抖动、锁竞争或过多短任务往往比“CPU 不够”更值得先查。
用队列与调度数据验证根因
修复前先写下可证伪的判断。例如“发送端因队列满而阻塞”,就应同时看到 msgsnd 耗时增加、队列接近容量上限和消费者吞吐跟不上;缺少其中一环,就不要直接扩容队列。
修复后使用同样的负载、同样的采样窗口重新比较 IPC 延迟分位数、相关系统调用耗时、上下文切换和队列水位。只有这些指标同时朝预期方向变化,才能确认真正消除了瓶颈,而不是暂时把延迟转移到了别处。