
操作系统 / 系统课时
怎样从阻塞链里找到死锁
怎样从阻塞链里找到死锁
程序“卡住”并不一定就是死锁:也可能在等 I/O、条件变量或外部事件。定位死锁的关键不是先猜哪把锁有问题,而是先找出哪些线程阻塞、各自在等待什么,再把“持有者 → 等待者”连成闭环。下面用可复现的互斥锁死锁演示这条排查路径。
学习目标
- 能区分普通阻塞与相互等待形成的死锁。
- 能结合
strace、线程栈和锁顺序建立等待关系。 - 能用统一加锁顺序修复死锁并验证问题消失。
先确认程序是否形成闭环等待
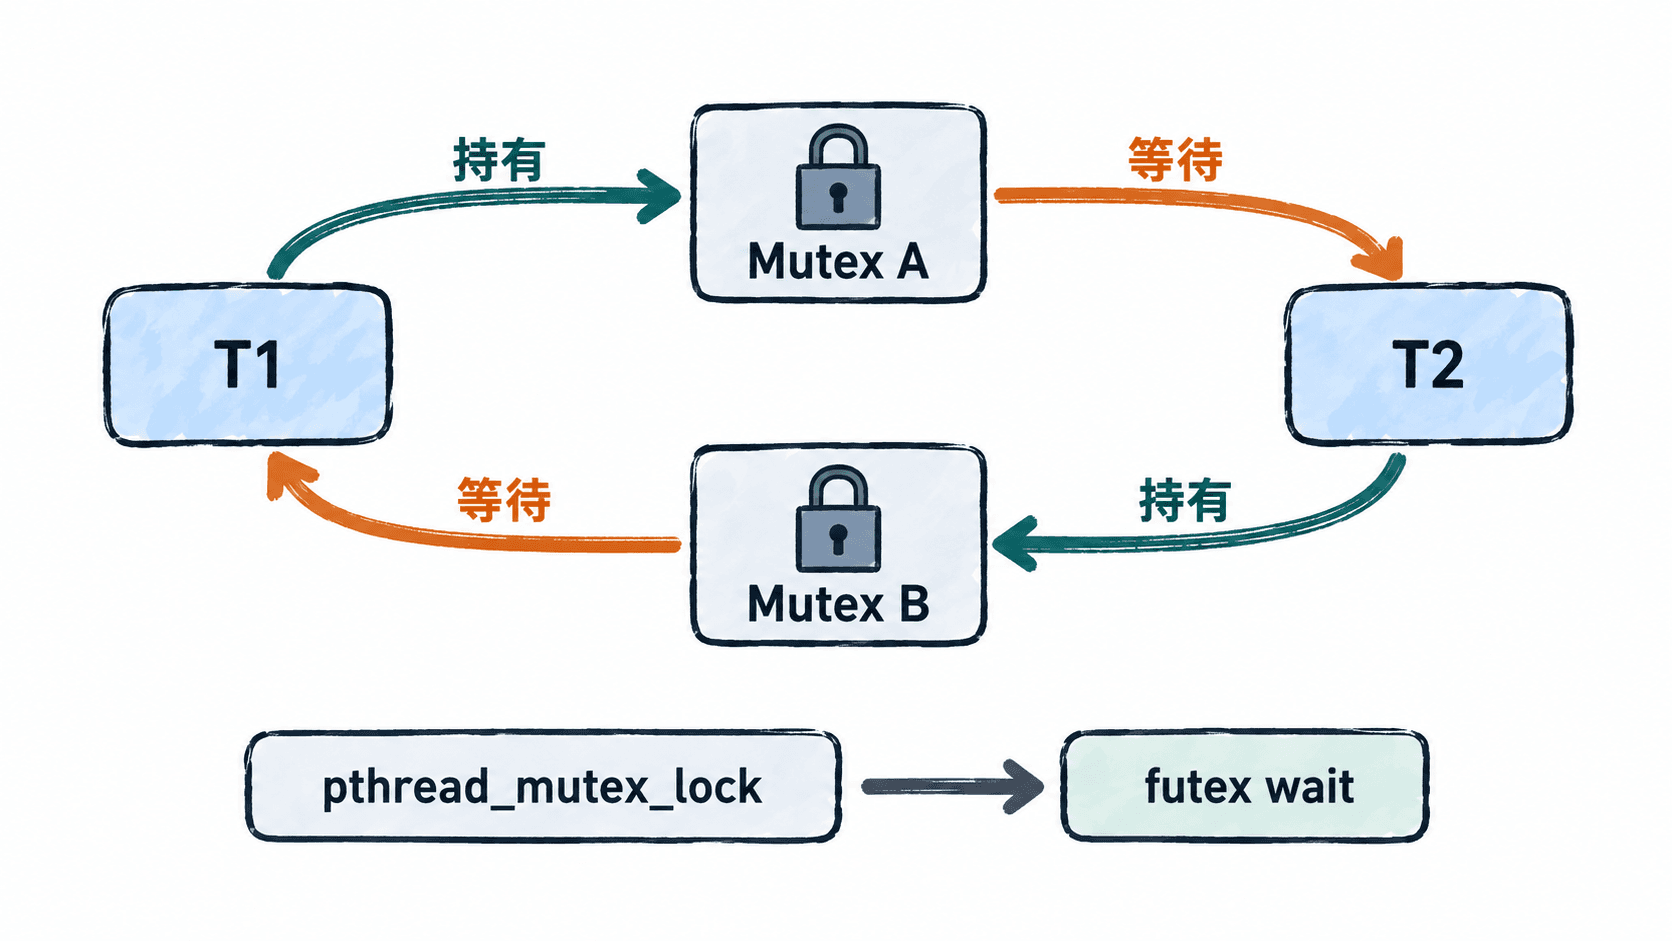
死锁至少需要出现一个等待环:线程 T1 持有 A、等待 B;线程 T2 持有 B、等待 A。单个线程长时间停在 futex 或 pthread_mutex_lock 并不能单独证明死锁,因为它可能只是等待一个仍会继续运行的持锁者。
排查时先回答三个问题:哪些线程不再前进、它们阻塞在哪个系统调用或同步函数、对应锁当前由谁持有。只有把等待关系闭合成环,才能把“卡住”定性为死锁。
制造一个可复现死锁
下面程序故意让两个线程以相反顺序获取 A、B 两把互斥锁。两个线程各拿到第一把锁后等待一秒,随后都会等待对方手里的第二把锁。
#include <pthread.h>
#include <stdio.h>
#include <unistd.h>

static pthread_mutex_t lock_a = PTHREAD_MUTEX_INITIALIZER;
static pthread_mutex_t lock_b = PTHREAD_MUTEX_INITIALIZER;

static void *worker1(void *arg) {
    (void)arg;
    pthread_mutex_lock(&lock_a);
    puts("T1 locked A");
    sleep(1);

    pthread_mutex_lock(&lock_b);
    puts("T1 locked B");
    return NULL;
}

static void *worker2(void *arg) {
    (void)arg;
    pthread_mutex_lock(&lock_b);
    puts("T2 locked B");
    sleep(1);

    pthread_mutex_lock(&lock_a);
    puts("T2 locked A");
    return NULL;
}

int main(void) {
    pthread_t t1, t2;
    setvbuf(stdout, NULL, _IONBF, 0);

    pthread_create(&t1, NULL, worker1, NULL);
    pthread_create(&t2, NULL, worker2, NULL);

    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    return 0;
}
编译后用 timeout 让演示自动结束:
gcc -Wall -Wextra -O0 -g -pthread deadlock_demo.c -o deadlock_demo
timeout 3s ./deadlock_demo
echo "exit=$?"
预期输出
T1 locked A
T2 locked B
exit=124前两行顺序可能互换;124 表示 timeout 到期终止了仍未退出的程序。正常程序如果只是短暂等待,通常会在超时前继续执行,而这个示例会稳定停在第二次加锁。
从系统调用看到阻塞点
pthread_mutex_lock 在发生竞争时通常会落到 Linux 的 futex 等待。可以用 strace 从外部确认多个线程都停在同步等待,而不是卡在磁盘、网络或睡眠调用。
strace -f -o deadlock.strace -e trace=futex timeout 3s ./deadlock_demo >/dev/null
grep FUTEX_WAIT deadlock.strace
预期输出
<ID>  futex(<ADDR>, FUTEX_WAIT_PRIVATE, 2, NULL <unfinished ...>
<ID>  futex(<ADDR>, FUTEX_WAIT_PRIVATE, 2, NULL <unfinished ...>
<ID> 和 <ADDR> 会随运行变化。两条 FUTEX_WAIT_PRIVATE 说明至少两个线程正在等待用户态同步对象,但还不能仅凭地址判断“谁拿着哪把锁”,下一步需要线程栈和源码位置把地址还原成锁关系。
用线程栈还原锁关系
有调试符号时,线程栈比单看系统调用更接近根因。让程序在后台运行,记下进程号,再附加 gdb:
./deadlock_demo >deadlock.out 2>&1 &
PID=$!
sleep 2
echo "pid=$PID"
gdb -q -p "$PID" -batch -ex "set pagination off" -ex "thread apply all bt"
kill "$PID"
wait "$PID" 2>/dev/null || true
预期结果
pid=<ID>
Thread <ID> ... pthread_mutex_lock ...
... worker1 ... deadlock_demo.c:<LINE>
Thread <ID> ... pthread_mutex_lock ...
... worker2 ... deadlock_demo.c:<LINE>
<ID> 与 <LINE> 取决于实际运行和源码行号;不同 glibc 版本的内部栈帧名称也可能不同。真正要找的是两个业务栈分别停在 worker1 与 worker2 的第二次 pthread_mutex_lock,再回看源码即可得到:T1 已持有 A 等 B,T2 已持有 B 等 A。
修复后验证等待环消失
最直接的修复是规定全局锁顺序:所有代码都必须先拿 A,再拿 B,释放时通常按相反顺序进行。只要不存在某条路径反向获取,就不会形成 A→B→A 的等待环。
修复 worker2 后再次运行同样的 timeout 3s ./deadlock_demo。预期现象是程序在超时前自行退出,echo $? 返回 0,同时 strace 中即使短暂出现 futex 等待,也不会长期留下两个互相等待的线程。
排查真实系统时,应把这套方法固定成顺序:先确认停滞线程,再看系统调用类型,然后用线程栈映射到具体锁,最后画出持有与等待关系。只要等待图出现闭环,根因就从“程序卡住”收敛成了可以修改和复验的锁顺序问题。