
操作系统 / 系统课时
共享内存崩溃后如何恢复
共享内存崩溃后如何恢复
进程异常退出后,共享内存对象可能仍然存在,但其中的数据未必处于可继续消费的状态。本篇把“对象残留”和“业务状态不一致”分开处理,并用可恢复头部演示重新连接时如何识别脏状态、回滚未提交进度并安全恢复服务。
学习目标
- 区分共享内存对象是否存在与其中数据是否一致这两个问题。
- 用状态、版本、世代号和提交点识别上一次写入是否完整。
- 设计消费者重新连接后的检查、修复和拒绝策略。
崩溃后真正需要恢复什么
POSIX 共享内存通过 shm_open 创建后,不会因为某个映射进程退出就自动删除;只有显式 shm_unlink 后名字才被移除。因此重启时看到同名对象并不代表它可以直接复用。
恢复至少要检查三层状态:对象尺寸是否符合预期,头部格式是否兼容,业务数据是否停在完整提交点。最后一层最容易被忽略,因为进程可能在“已经写入部分槽位、尚未发布提交序号”时崩溃。
用状态和提交点留下恢复线索
一种简单做法是在头部保存 state、epoch、write_seq 和 committed_seq。开始一批写入前把状态标记为 DIRTY,全部数据就绪后先推进 committed_seq,最后再恢复为 READY。重连者发现 DIRTY 时,就只信任提交点之前的数据。
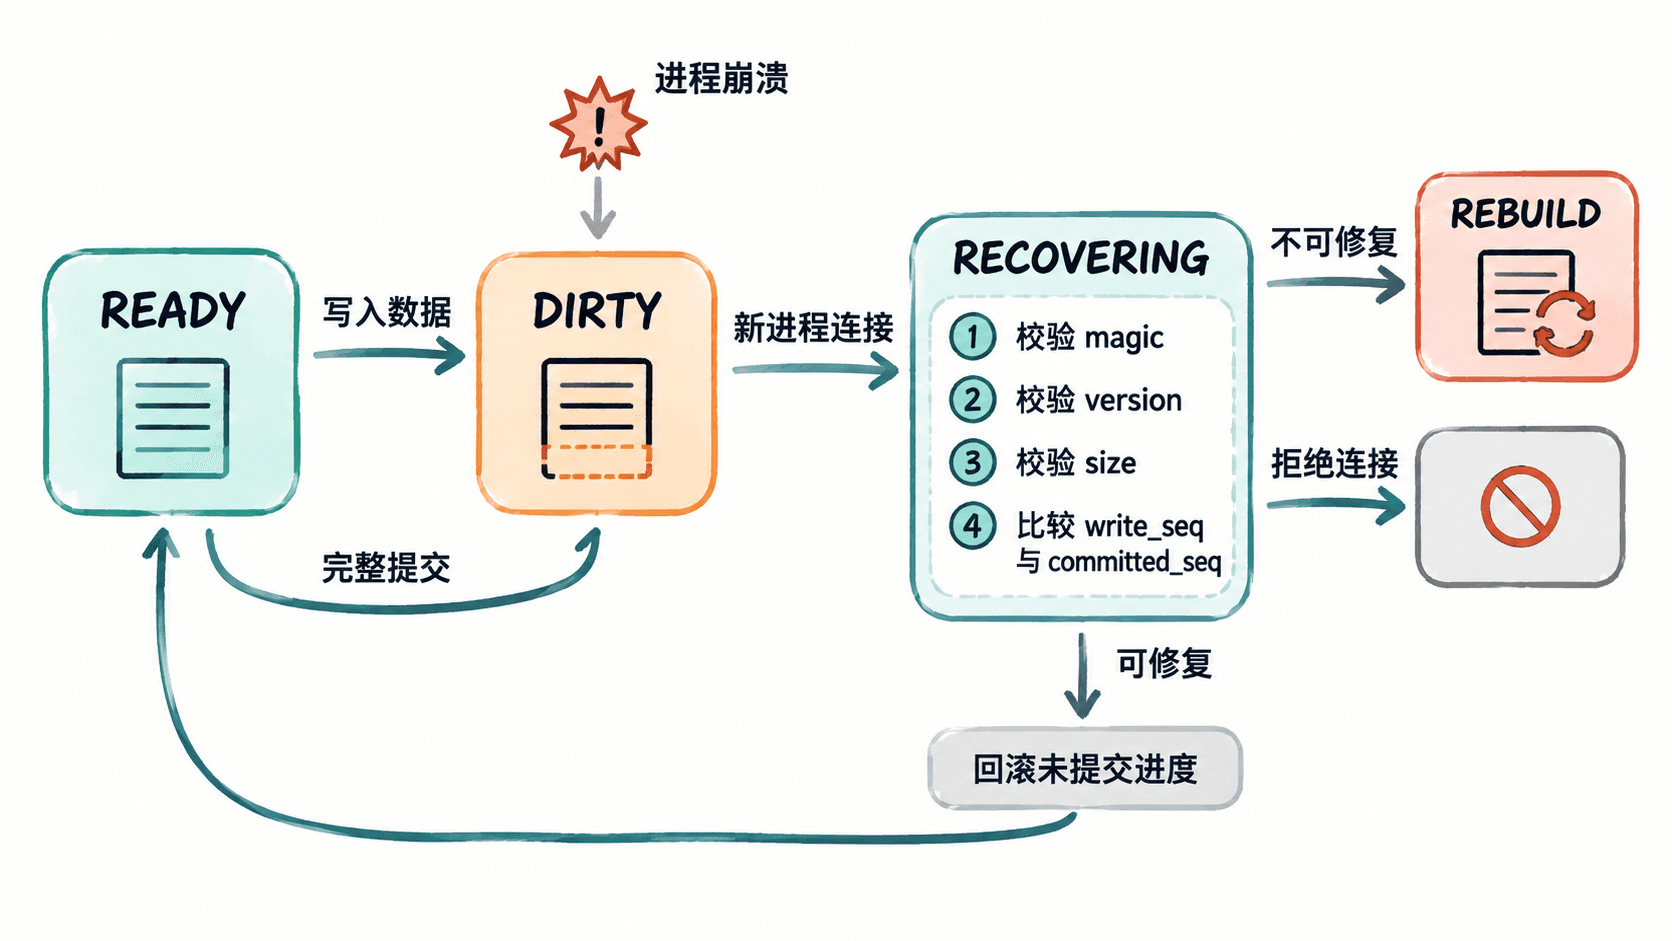
下面的完整程序用 POSIX 共享内存模拟一次“留下脏状态后退出”,随后由新进程把未提交写序号回滚到提交点。
#define _POSIX_C_SOURCE 200809L
#include <fcntl.h>
#include <stdint.h>
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/mman.h>
#include <sys/stat.h>
#include <unistd.h>

#define SHM_NAME "/anystack_ipc_recover_demo"
#define MAGIC 0x49504331u

enum {
    STATE_READY = 1,
    STATE_DIRTY = 2
};

typedef struct {
    uint32_t magic;
    uint32_t version;
    uint32_t state;
    uint32_t reserved;
    uint64_t epoch;
    uint64_t write_seq;
    uint64_t committed_seq;
} Header;

static Header *map_header(int create, int *fd_out) {
    int flags = create ? (O_CREAT | O_RDWR) : O_RDWR;
    int fd = shm_open(SHM_NAME, flags, 0600);
    if (fd == -1) {
        perror("shm_open");
        exit(EXIT_FAILURE);
    }

    if (create) {
        if (ftruncate(fd, (off_t)sizeof(Header)) == -1) {
            perror("ftruncate");
            exit(EXIT_FAILURE);
        }
    } else {
        struct stat st;
        if (fstat(fd, &st) == -1 || st.st_size != (off_t)sizeof(Header)) {
            fprintf(stderr, "unexpected shared memory size\n");
            exit(EXIT_FAILURE);
        }
    }

    Header *h = mmap(NULL, sizeof(Header), PROT_READ | PROT_WRITE,
                     MAP_SHARED, fd, 0);
    if (h == MAP_FAILED) {
        perror("mmap");
        exit(EXIT_FAILURE);
    }

    *fd_out = fd;
    return h;
}

int main(int argc, char **argv) {
    if (argc != 2) {
        fprintf(stderr, "usage: %s init|crash|recover|cleanup\n", argv[0]);
        return EXIT_FAILURE;
    }

    if (strcmp(argv[1], "cleanup") == 0) {
        if (shm_unlink(SHM_NAME) == -1) {
            perror("shm_unlink");
            return EXIT_FAILURE;
        }
        puts("removed");
        return EXIT_SUCCESS;
    }

    int create = strcmp(argv[1], "init") == 0;
    int fd;
    Header *h = map_header(create, &fd);

    if (create) {
        memset(h, 0, sizeof(*h));
        h->magic = MAGIC;
        h->version = 1;
        h->state = STATE_READY;
        h->epoch = 1;
        printf("initialized epoch=%llu committed=%llu\n",
               (unsigned long long)h->epoch,
               (unsigned long long)h->committed_seq);
    } else if (h->magic != MAGIC || h->version != 1) {
        fprintf(stderr, "incompatible shared memory\n");
        return EXIT_FAILURE;
    } else if (strcmp(argv[1], "crash") == 0) {
        h->state = STATE_DIRTY;
        h->epoch++;
        h->write_seq = 5;
        h->committed_seq = 3;
        printf("left dirty state epoch=%llu write=%llu committed=%llu\n",
               (unsigned long long)h->epoch,
               (unsigned long long)h->write_seq,
               (unsigned long long)h->committed_seq);
    } else if (strcmp(argv[1], "recover") == 0) {
        if (h->state == STATE_DIRTY) {
            if (h->write_seq < h->committed_seq) {
                fprintf(stderr, "corrupt sequence values\n");
                return EXIT_FAILURE;
            }
            h->write_seq = h->committed_seq;
            h->state = STATE_READY;
        }
        printf("recovered epoch=%llu write=%llu committed=%llu\n",
               (unsigned long long)h->epoch,
               (unsigned long long)h->write_seq,
               (unsigned long long)h->committed_seq);
    } else {
        fprintf(stderr, "unknown command\n");
        return EXIT_FAILURE;
    }

    munmap(h, sizeof(Header));
    close(fd);
    return EXIT_SUCCESS;
}
将程序保存为 shm_recover.c,再按顺序编译和运行:
cc -std=c11 -Wall -Wextra -O2 shm_recover.c -o shm_recover -lrt
./shm_recover init
./shm_recover crash
./shm_recover recover
./shm_recover cleanup
预期输出
initialized epoch=1 committed=0
left dirty state epoch=2 write=5 committed=3
recovered epoch=2 write=3 committed=3
removed
这里的 crash 子命令只是故意留下 DIRTY 状态来模拟崩溃残留;真实系统通常会在开始修改共享数据前写入脏标记,并在完成发布后清除。示例按顺序单进程执行,并发生产时仍需原子操作或进程间锁保证发布顺序。
重连时按固定顺序判断
消费者重新连接时应先做结构校验,再做状态修复。推荐顺序是:验证对象尺寸与 magic,检查版本和槽位参数,再判断状态是否为 DIRTY,最后只依据已提交序号恢复游标。任何一步发现无法证明数据完整,都应拒绝复用并重建共享区。
如果共享区中还放有进程共享互斥量,可以使用 robust mutex 检测持锁进程死亡。pthread_mutex_lock 返回 EOWNERDEAD 时,当前进程获得锁但数据仍可能不一致;必须先修复业务状态,再调用 pthread_mutex_consistent,不能把“锁已接管”误认为“数据已恢复”。
清理残留对象不能替代一致性恢复
开发环境里直接 shm_unlink 再重建很方便,但生产系统是否允许这样做取决于数据能否丢弃。可重建缓存可以删除后重新初始化;承载队列、进度或不可重复事件时,则应依赖提交点、校验和、世代号或外部持久化来源恢复。
还要避免仅凭 owner_pid 判断旧生产者是否仍存活,因为 PID 可能被系统复用。若需要所有权判定,可组合进程启动标识、世代号或外部协调机制。可靠恢复的核心不是“把残留对象删掉”,而是让新进程能够判断哪些字节已提交、哪些必须回滚,以及何时应该拒绝继续使用。