
操作系统 / 系统课时
为什么共享内存必须配合同步
为什么共享内存必须配合同步
共享内存的速度来自“多个进程直接访问同一片物理内存”,但这也意味着内核不会替你安排读写先后。本节用单槽生产者消费者模型说明:没有同步时,读者可能看到旧值或半成品;加入进程共享信号量后,数据写入和读取才形成明确时序。
学习目标
- 能解释共享内存中的数据竞争与读写时序问题
- 能用生产者消费者模型识别“可写”和“可读”两个状态
- 能使用进程共享信号量保护一次完整的数据交接
问题不在内存,而在时序
假设生产者把结果写到共享变量 value,消费者随后读取。共享内存只保证双方能访问同一地址对应的数据,不会自动保证“生产者已经写完”这一前提。消费者若过早读取,就可能拿到旧值;双方若同时更新更复杂的数据结构,还可能观察到不一致的中间状态。
单槽缓冲区至少需要两个条件:生产者只能在槽位为空时写,消费者只能在槽位有数据时读。同步原语的任务就是把这两个条件变成可等待、可唤醒的状态,而不是依靠 sleep 猜测时机。
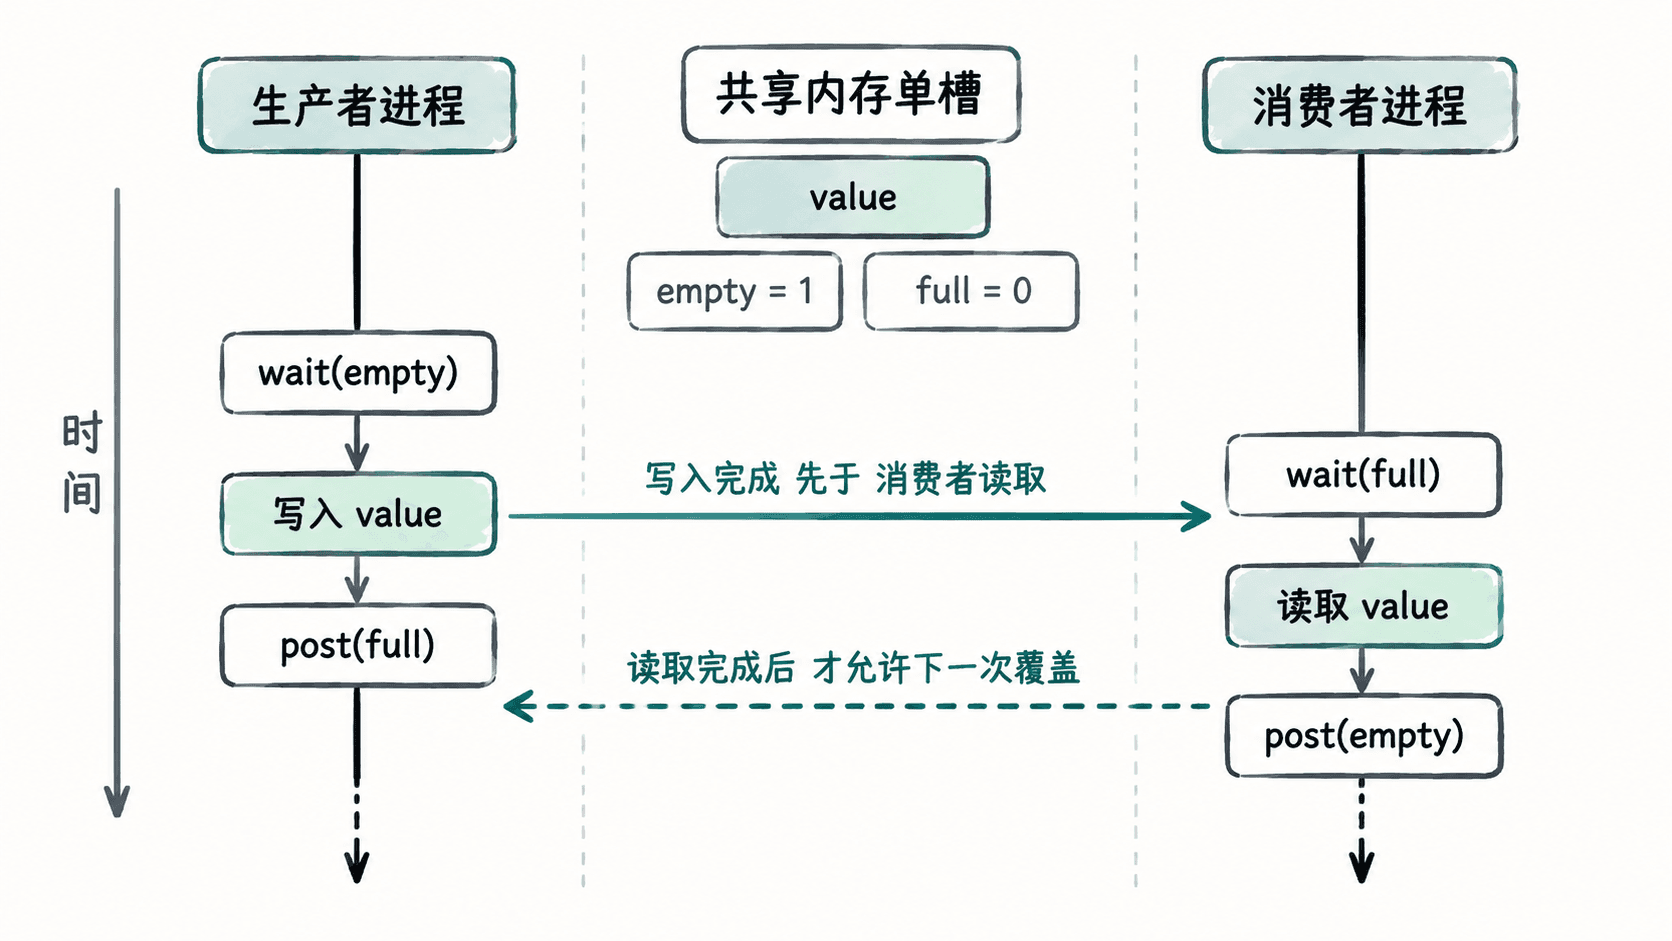
用信号量建立一次可靠交接
下面程序把两个 sem_t 和一个整数一起放进 POSIX 共享内存。sem_init 的第二个参数设为 1,表示信号量可在多个进程之间共享。父进程消费,子进程生产;empty 和 full 共同保证每个值只写一次、只读一次。
#include <fcntl.h>
#include <semaphore.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/mman.h>
#include <sys/wait.h>
#include <unistd.h>

typedef struct {
    sem_t empty;
    sem_t full;
    int value;
} Shared;

int main(void) {
    const char *name = "/anystack-sync-demo";
    int fd = shm_open(name, O_CREAT | O_EXCL | O_RDWR, 0600);
    if (fd == -1) {
        perror("shm_open");
        return EXIT_FAILURE;
    }

    if (ftruncate(fd, (off_t)sizeof(Shared)) == -1) {
        perror("ftruncate");
        close(fd);
        shm_unlink(name);
        return EXIT_FAILURE;
    }

    Shared *shared = mmap(NULL, sizeof(Shared),
                          PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);
    if (shared == MAP_FAILED) {
        perror("mmap");
        close(fd);
        shm_unlink(name);
        return EXIT_FAILURE;
    }

    if (sem_init(&shared->empty, 1, 1) == -1 ||
        sem_init(&shared->full, 1, 0) == -1) {
        perror("sem_init");
        munmap(shared, sizeof(Shared));
        close(fd);
        shm_unlink(name);
        return EXIT_FAILURE;
    }

    setvbuf(stdout, NULL, _IONBF, 0);

    pid_t pid = fork();
    if (pid == -1) {
        perror("fork");
        return EXIT_FAILURE;
    }

    if (pid == 0) {
        for (int i = 1; i <= 3; ++i) {
            sem_wait(&shared->empty);
            shared->value = i * 10;
            printf("producer: %d\n", shared->value);
            sem_post(&shared->full);
        }
        munmap(shared, sizeof(Shared));
        close(fd);
        _exit(EXIT_SUCCESS);
    }

    for (int i = 1; i <= 3; ++i) {
        sem_wait(&shared->full);
        printf("consumer: %d\n", shared->value);
        sem_post(&shared->empty);
    }

    waitpid(pid, NULL, 0);
    sem_destroy(&shared->empty);
    sem_destroy(&shared->full);
    munmap(shared, sizeof(Shared));
    close(fd);
    shm_unlink(name);
    return EXIT_SUCCESS;
}
预期结果:每次生产之后才允许对应消费,消费完成后才允许下一次覆盖槽位,因此数值按 10、20、30 完整交接。
producer: 10
consumer: 10
producer: 20
consumer: 20
producer: 30
consumer: 30
编译并运行:
gcc -Wall -Wextra -O2 shm_sync.c -o shm_sync -pthread -lrt
./shm_sync
预期输出:
producer: 10
consumer: 10
producer: 20
consumer: 20
producer: 30
consumer: 30
-pthread 负责启用线程/同步相关的编译与链接设置;在较新的 glibc 上 -lrt 可能不是必需,但保留可兼容更多 Linux 环境。
为什么 sleep 不是同步
把消费者写成“先睡 10 毫秒再读”并不能建立正确性。机器负载、调度延迟和生产者执行时间都可能变化,某次运行看似正常,只代表竞争窗口没有碰巧暴露。真正的同步需要由互斥锁、信号量、条件变量或原子协议表达先后关系。
在上面的单槽模型中,sem_wait(&shared->full) 明确表示“没有成品就等待”,而 sem_post(&shared->full) 表示“写入已经完成,可以读”。这比基于时间的猜测稳定,也能在系统繁忙时自然阻塞而不是反复轮询。
选择同步原语的边界
如果共享区只需要“有一个生产者写完后通知一个消费者”,信号量很直接。若需要保护多个字段的复合更新,可以使用放在共享内存中的进程共享 pthread_mutex_t,并通过 pthread_mutexattr_setpshared 设置 PTHREAD_PROCESS_SHARED。若是环形队列,还需要进一步管理读写索引、满空条件和内存顺序。
共享内存负责“把数据放在双方都能访问的位置”,同步负责“规定双方在什么条件下访问”。只有这两部分同时成立,生产者消费者协议才既快又正确。