
操作系统 / 系统课时
为什么共享内存吞吐更高
为什么共享内存吞吐更高
共享内存快的关键并不是一种更快的“发送”算法,而是通信双方把同一组物理页映射进各自地址空间。数据生产后可以直接被另一进程读取,从而减少在用户空间和内核缓冲区之间反复复制大块数据的成本。
学习目标
- 理解两个进程如何通过不同虚拟地址访问同一组物理页
- 区分共享内存与管道、Socket 在数据复制路径上的差异
- 判断共享内存适合的负载,以及它没有解决的同步问题
吞吐差异来自数据路径
使用管道或本地 Socket 时,应用通常把数据写入内核管理的缓冲区,接收进程再从内核读取。一次通信至少涉及系统调用、缓冲区管理以及用户空间与内核空间之间的数据搬运。
共享内存采用不同思路:内核先建立映射关系,让两个进程的虚拟地址最终指向同一组物理页。生产者把数据写入这些页后,消费者可以直接从自己的映射地址读取,因此不需要为每条消息重新完成一次“发送缓冲区到接收缓冲区”的大块复制。
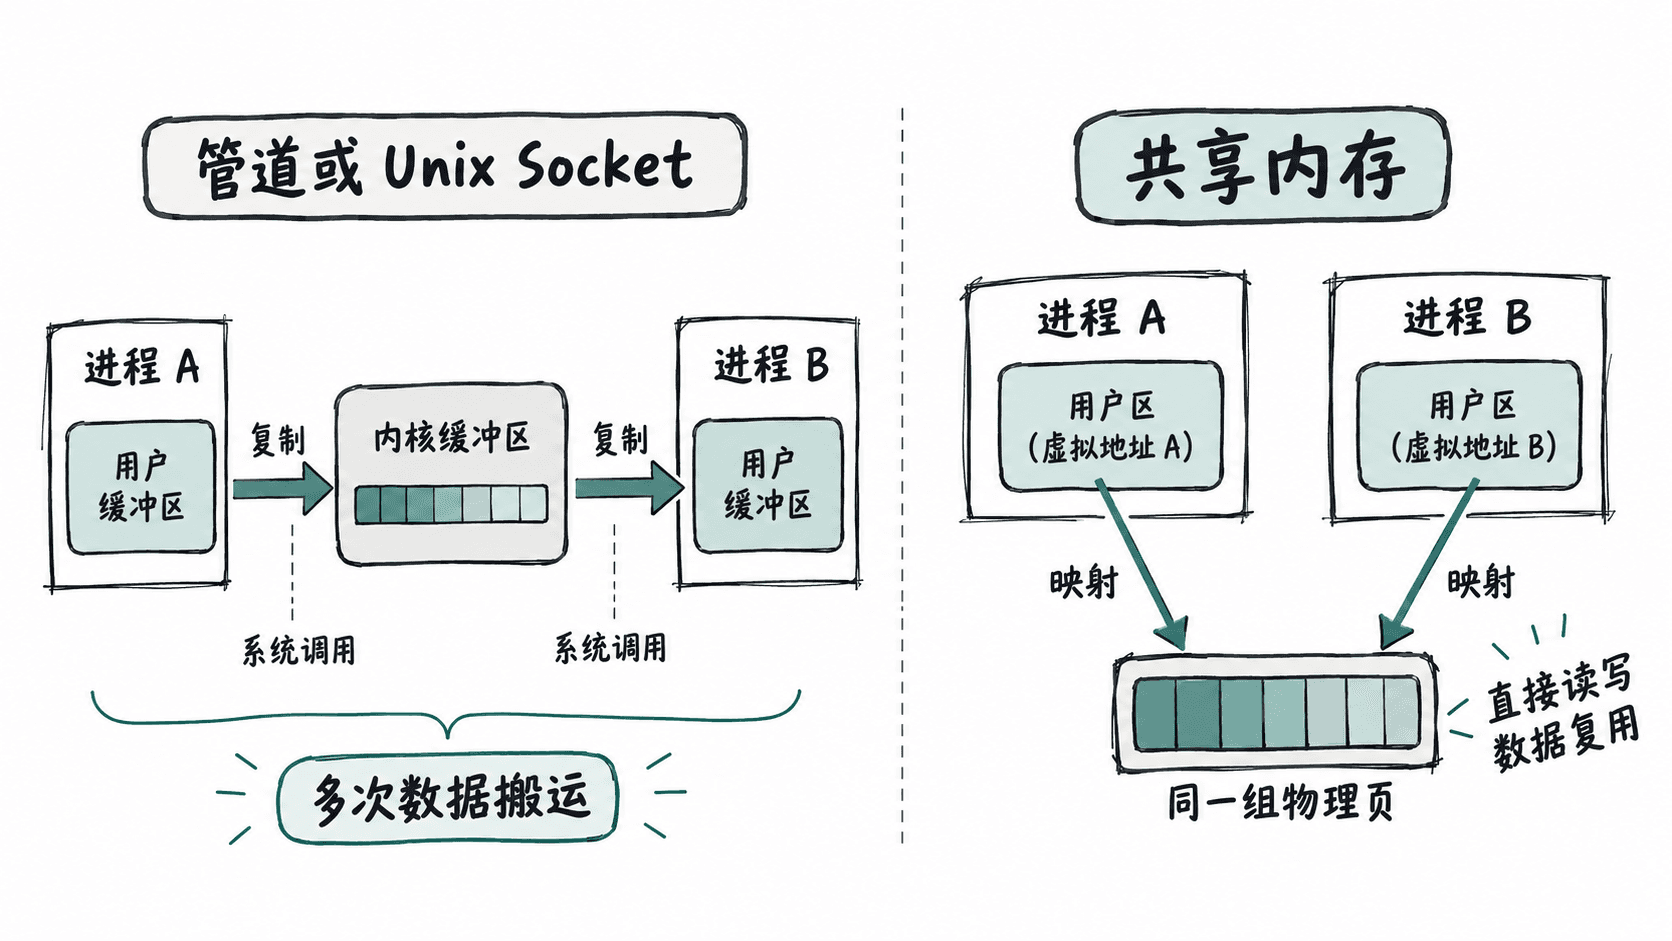
这里的“零拷贝”需要谨慎理解。建立映射、处理缺页异常以及缓存一致性仍有成本,应用第一次把源数据写进共享区域时也仍然发生内存写入。真正减少的是 IPC 过程中重复把同一批数据复制到另一个通信缓冲区的动作。
映射的是物理页而不是相同指针
两个进程拥有彼此独立的虚拟地址空间,因此共享区域在进程 A 中可能位于一个地址,在进程 B 中位于完全不同的地址。真正共享的是这些虚拟地址背后的物理页,而不是某个固定的指针值。
这也意味着共享数据结构不能随意保存只对当前进程有效的普通指针。若共享区域中存放链表、树或可变长对象,更稳妥的做法通常是保存相对于共享区域起点的偏移量,再由每个进程根据自己的映射基址计算实际地址。
与管道和 Socket 怎么选
| 方式 | 主要数据路径 | 边界与同步 | 更适合的场景 |
|---|---|---|---|
| 管道 | 经内核缓冲区传递 | 内核提供字节流读写语义 | 父子进程、简单流水线 |
| Unix Socket | 经 Socket 缓冲区传递 | 自带收发、阻塞和连接语义 | 本机服务间消息通信 |
| 共享内存 | 多进程直接访问同一物理页 | 需要应用自行协调访问 | 大块数据、高频交换、低复制开销 |
当每条消息只有几十字节时,共享内存节省的数据复制可能并不足以抵消协议设计、同步和生命周期管理的复杂度。图像帧、音视频块、大数组、模型中间结果等体积较大的数据,才更容易体现它的吞吐优势。
高吞吐不等于无锁
共享地址空间只解决“数据放在哪里”,没有解决“谁先读写”。两个进程同时修改同一字段仍然可能出现竞态,消费者也可能在生产者只写完一半时读到不完整数据。
实际系统通常还需要配合进程共享互斥量、信号量、原子变量或基于序号的环形缓冲区协议。同步策略如果设计不当,锁竞争、缓存行抖动和忙等反而会成为新的性能瓶颈。
共享内存真正擅长的是把“大量数据的搬运”转换成“对同一份数据的协调访问”。因此评估它是否值得使用时,应同时观察单次数据量、交换频率、复制成本以及同步复杂度,而不是只看 IPC 名称本身。