
操作系统 / 系统课时
完成一次进程线程调度体检
完成一次进程线程调度体检
这次体检把 CPU 竞争、锁等待和内存压力放进同一个实验负载,按“系统指标→进程与线程→调度轨迹→根因验证”的顺序定位问题,并用一次受控调优验证判断是否正确,最终形成可复用的调度诊断证据链。
学习目标
- 用
pidstat、vmstat、PSI 和线程状态区分 CPU 竞争、锁等待与内存压力 - 从进程级症状继续定位到具体线程,并用
perf sched检查等待、调度延迟和运行时间 - 通过调优前后对照验证根因,而不是只凭单个指标下结论
建立可重复的实验负载
本实验使用 stress-ng 同时制造三类压力:CPU worker 形成 runnable 竞争,mutex worker 制造锁等待,VM worker 分配并持续访问内存。采集侧需要 pidstat、vmstat 和 perf;其中 perf sched 通常需要 root 权限或允许访问调度事件。
先启动负载,再连续采集进程、线程和系统层指标。不要先看到 CPU 高就直接认定“CPU 不够”,因为锁竞争导致的频繁唤醒、内存回收引起的阻塞也可能同时存在。
stress-ng --cpu 2 --mutex 4 --vm 1 --vm-bytes 40% --vm-keep --timeout 90s --metrics-brief &
LOAD_PID=$!
sleep 2

echo "LOAD_PID=$LOAD_PID"
pidstat -u -w -r -t -p ALL 1 5 | tee /tmp/sched-baseline-pidstat.txt
vmstat 1 5 | tee /tmp/sched-baseline-vmstat.txt
cat /proc/pressure/cpu
cat /proc/pressure/memory
ps -eLo pid,tid,psr,pcpu,stat,wchan:24,comm --sort=-pcpu | grep -E 'PID|stress-ng' | head -n 20
sudo perf sched record -- sleep 5
sudo perf sched timehist | grep stress-ng | head -n 20
wait "$LOAD_PID"预期输出(<PID>、<TID>、时间和百分比会因机器而异):
LOAD_PID=<PID>

CPU worker:%CPU 较高,线程可出现 STAT=R,非自愿上下文切换增加
mutex worker:部分线程处于睡眠状态,wchan 常可看到 futex 相关等待
VM worker:RSS 与缺页活动增加;内存紧张时 vmstat 的 si/so、等待或 memory PSI 会抬升
/proc/pressure/cpu:some avg10=<VALUE> ...
/proc/pressure/memory:some avg10=<VALUE> ... full avg10=<VALUE> ...
perf sched timehist:stress-ng 任务出现 wait time、sch delay 与 runtime 记录如果机器内存充足,si、so 仍可能保持 0。这不能单独证明没有内存压力,应同时看 memory PSI、缺页、RSS 和系统是否发生回收或阻塞。
按系统、任务和线程逐层定位
调度体检最容易出错的地方,是把不同层级的指标混在一起解释。先看系统是否真的存在资源争用,再确定由哪些任务贡献,最后观察线程为什么没有得到 CPU 或为什么主动睡眠。
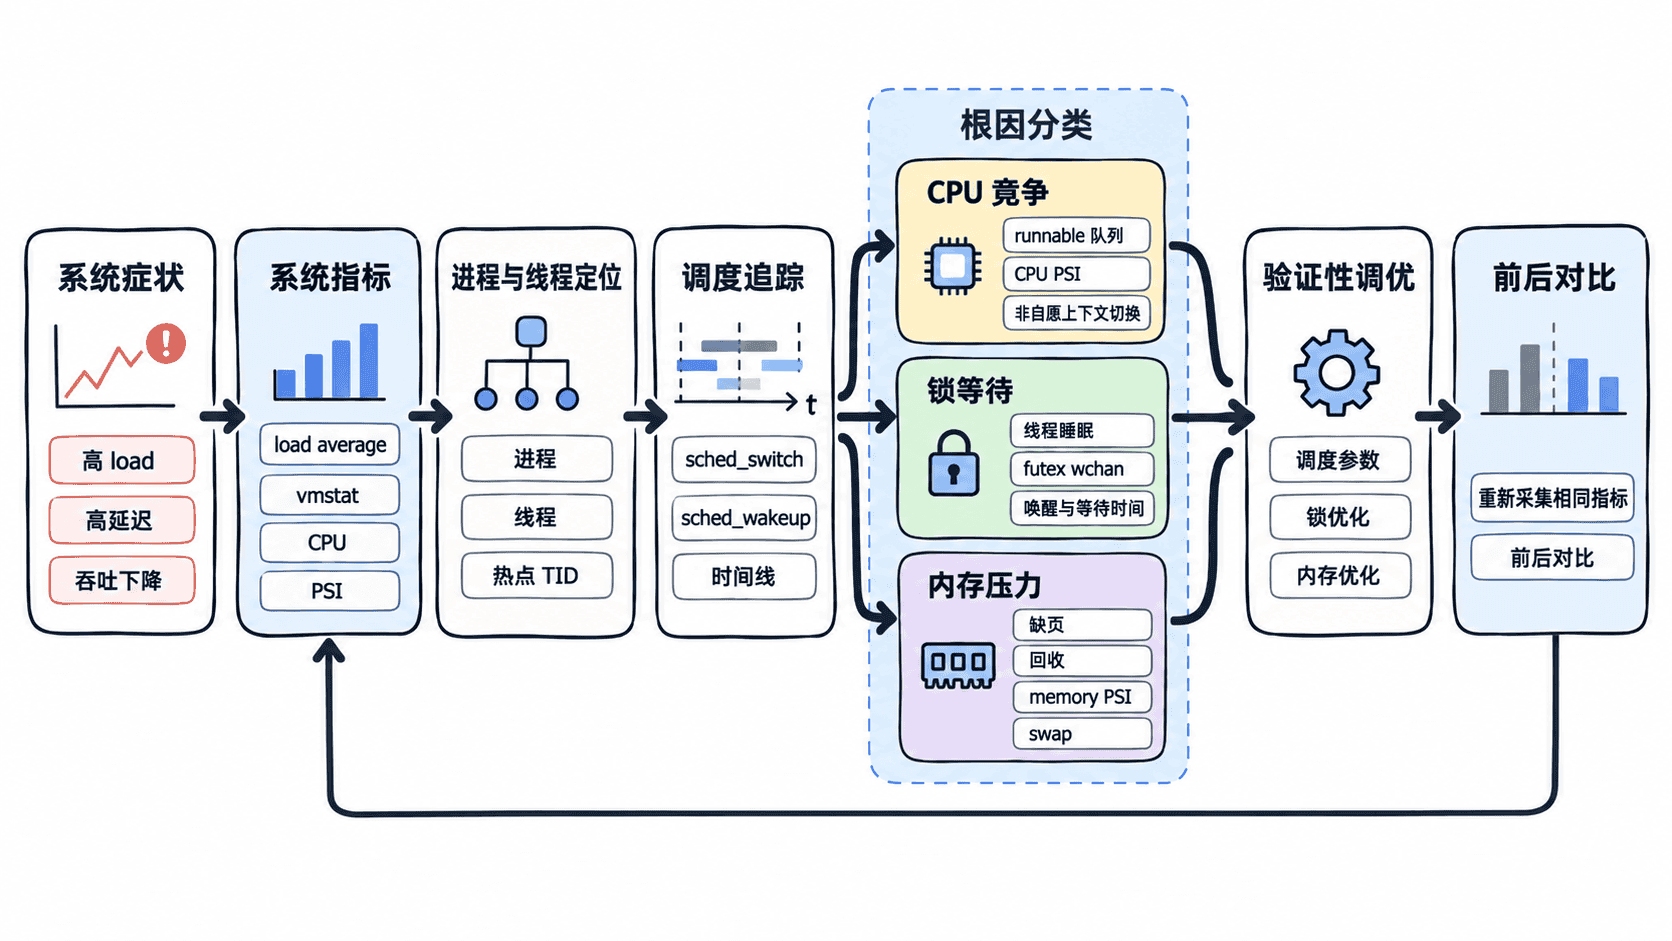
CPU 竞争首先看 vmstat 的运行队列 r、CPU 使用率和 /proc/pressure/cpu。如果 runnable 任务长期多于可运行 CPU,并且目标线程的非自愿上下文切换明显增加,说明任务正在相互争夺 CPU 时间片。
锁等待则看线程状态和等待点。CPU 不高并不代表调度正常:多个线程可能长期处于 S 状态,并在 wchan 中停在 futex 等等待函数。此时增加线程数通常不会提高吞吐,反而会扩大竞争和唤醒开销。
内存压力需要把 RSS、缺页、vmstat 和 memory PSI 放在一起。若系统开始频繁回收甚至交换,任务可能因为内存路径阻塞而表现出调度延迟;这类延迟不能通过单纯提高 CPU 配额解决。
用调度轨迹验证推断
perf sched timehist 的价值在于补上“线程为什么此刻没有运行”的时间证据。重点观察三个量:等待运行的时间、被唤醒后到真正获得 CPU 的调度延迟,以及实际运行时间。
如果 CPU worker 已经 runnable,但反复出现较长的 scheduling delay,且 CPU PSI 同时升高,可以把根因指向 CPU 竞争。若 mutex worker 大部分时间并不 runnable,而是在 futex 等待后被唤醒,则瓶颈主要位于同步路径,而不是调度器没有分配 CPU。
若 perf sched record 报权限错误,应先检查当前用户是否允许读取 perf 事件;生产环境也应遵循现有权限和变更流程,不要为了采样长期放宽系统安全策略。
做一次验证性调优
实验中的调优目的不是寻找一组“最佳参数”,而是主动改变三个怀疑因素,看指标是否按预测方向变化。这里减少 CPU worker、mutex 并发和内存占用,然后重新采集同一组指标。
stress-ng --cpu 1 --mutex 2 --vm 1 --vm-bytes 25% --vm-keep --timeout 30s --metrics-brief &
LOAD_PID=$!
sleep 2

pidstat -u -w -r -t -p ALL 1 5 | tee /tmp/sched-tuned-pidstat.txt
vmstat 1 5 | tee /tmp/sched-tuned-vmstat.txt
cat /proc/pressure/cpu
cat /proc/pressure/memory
sudo perf sched record -- sleep 5
sudo perf sched timehist | grep stress-ng | head -n 20
wait "$LOAD_PID"
预期结果:
与基线相比,应重点验证这些方向,而不是要求固定数值:
- runnable 竞争下降,CPU PSI 或 scheduling delay 降低
- mutex 等待线程减少,futex 等待和上下文切换压力减轻
- RSS 与内存压力下降,memory PSI、回收或 swap 活动不再继续恶化
- perf sched 中任务的等待时间与调度延迟整体趋于下降
如果只减少 CPU worker 后调度延迟明显改善,而锁等待仍然突出,说明原负载同时存在两个瓶颈;如果降低 mutex 并发后吞吐改善而 CPU 利用率反而上升,这通常意味着线程过去主要耗在锁等待,现在才真正获得执行机会。
用前后对照完成验收
一次合格的调度体检不以“发现 CPU 很高”结束,而应保存可复核的基线、线程定位结果、调度轨迹和验证性变更。比较 /tmp/sched-baseline-pidstat.txt 与 /tmp/sched-tuned-pidstat.txt 时,至少确认 CPU 竞争、上下文切换、RSS 或缺页中的目标指标是否按假设变化。
最终结论应明确区分主因和伴随症状。例如:“CPU runnable 竞争是主要调度瓶颈,mutex 等待放大了线程切换,内存压力存在但尚未进入持续 swap;降低并发后 CPU PSI 和调度延迟同步下降,因此根因判断得到验证。”只有指标、线程状态、调度轨迹和调优结果形成闭环,这次体检才真正完成。