
操作系统 / 系统课时
排查高负载却低 CPU 利用率
排查高负载却低 CPU 利用率
系统的 load average 持续升高,但 CPU 的 user 与 system 利用率并不高时,问题通常不是“CPU 指标失真”,而是有大量任务处于可运行或不可中断睡眠状态。本课用 uptime、vmstat、ps 与 I/O 指标把这类症状拆开,并给出可验证的定位顺序。
学习目标
- 区分 load average、运行队列与 CPU 利用率分别在描述什么。
- 用
vmstat和进程状态判断负载主要来自 runnable 任务还是 D 状态任务。 - 继续追踪 I/O 或内核等待点,并用修复后的指标变化验证结论。
先确认“高负载”和“低 CPU”同时存在
Linux 的 load average 不是 CPU 使用率。它近似反映一段时间内处于可运行状态以及不可中断睡眠状态的任务数量,因此 D 状态任务堆积时,即使 CPU 大部分时间空闲,load 仍然可以很高。
先连续采样,而不是只看某一个瞬时值:
uptime
vmstat 1 5
预期输出
<TIME> up <TIME>, <VALUE> users, load average: 18.20, 17.80, 15.40
procs -----------memory---------- ---swap-- -----io---- -system-- ------cpu-----
 r  b   swpd   free   buff  cache   si   so    bi    bo   in   cs us sy id wa st
1 24 <VALUE> <VALUE> <VALUE> <VALUE> 0 0 <VALUE> <VALUE> <VALUE> <VALUE> 2 3 70 25 0实际数值会不同;vmstat 1 5 的第一行通常是自启动以来的平均值,判断当前状态时重点看后续间隔采样。示例中 id 较高说明 CPU 仍有空闲,而 b 很高提示大量任务处于不可中断等待。
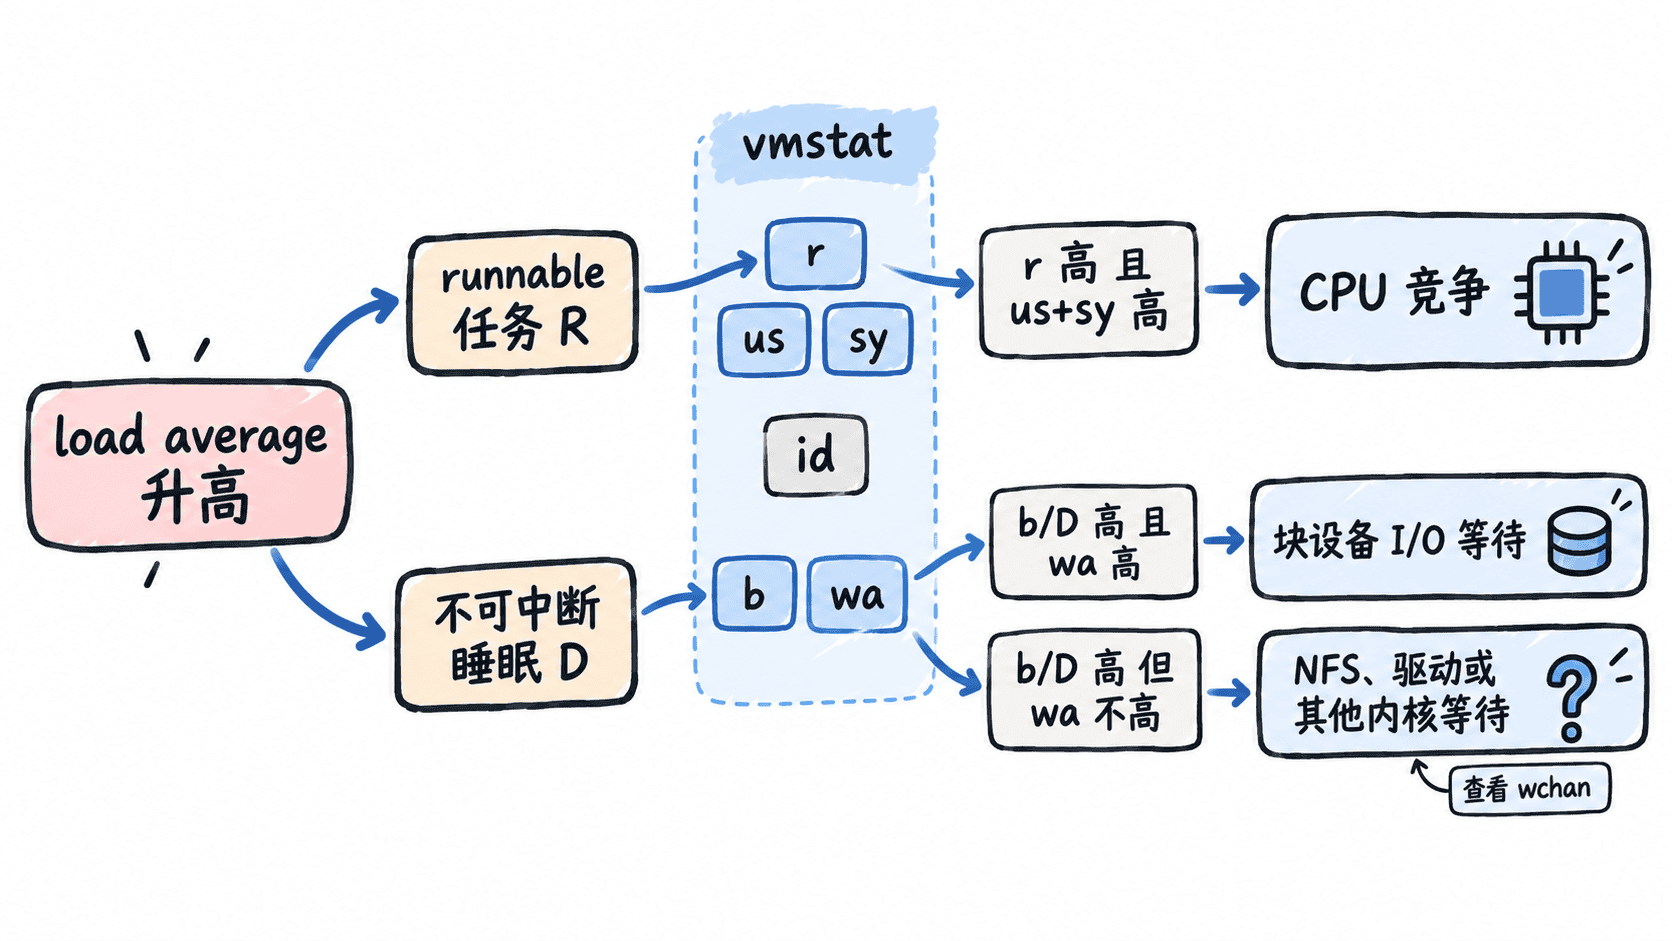
用运行队列和 D 状态拆分负载
vmstat 中最关键的是 r 与 b。r 表示正在运行或等待 CPU 的任务数,b 表示处于不可中断睡眠的任务数。若 r 长期明显超过可用 CPU 数,同时 us + sy 很高,才更像传统 CPU 饱和;若 b 很高而 id 仍明显不低,则优先查等待链路。
直接列出 R 与 D 状态任务,可以把系统级症状落到具体进程:
ps -eo state,pid,ppid,comm,wchan:32 --sort=state | awk 'NR==1 || $1=="R" || $1=="D"'预期输出
S     PID    PPID COMMAND         WCHAN
D    <ID>    <ID> worker          io_schedule
D    <ID>    <ID> nfs-worker      rpc_wait_bit_killable
R    <ID>    <ID> ps              -
这里的 PID 与等待函数会随现场变化。D 状态进程不能靠普通信号立即唤醒,它必须等内核等待条件满足;因此大量 D 状态任务既能推高 load,又不会持续消耗 CPU。wchan 则给出任务正在等待的内核位置,是继续判断块设备、网络文件系统或驱动问题的重要线索。
追到具体 I/O 等待点
如果 wa、b 与 D 状态同时升高,再检查设备延迟与进程 I/O。安装了 sysstat 时可执行:
iostat -xz 1 3
pidstat -d 1 3
预期输出
Device          r/s    w/s   await  aqu-sz  %util
<DEVICE>      <VALUE> <VALUE> <VALUE> <VALUE> <VALUE>

<TIME> UID       PID   kB_rd/s   kB_wr/s Command
<TIME> <ID>      <ID>   <VALUE>    <VALUE> <COMMAND>
实际设备名、吞吐与延迟取决于主机。不要只凭 %util 一列下结论,尤其是并行度较高的 SSD/NVMe;应结合 await、队列长度、吞吐变化以及具体进程的读写速率判断。若 D 状态很多但块设备并不忙,则返回 wchan,继续检查 NFS、FUSE、驱动或卡住的内核路径。
修复后按时间尺度验证
修复后先看即时指标:b 与 D 状态任务应下降,设备 await 或相关等待链路恢复,业务延迟也应回落。load average 是平滑后的历史值,不会像瞬时 CPU 指标一样立刻归零,因此 1 分钟 load 往往先下降,5 分钟和 15 分钟值随后才逐步回落。
当 CPU 仍然空闲、r 不高,而 b 或 D 状态持续堆积时,就不要继续把问题当作“CPU 不够”。正确的诊断主线是:先证实低 CPU,再用 r/b 拆分负载来源,最后把 D 状态落实到具体等待点并验证等待链路是否恢复。