
操作系统 / 系统课时
用 SCHED_RR 观察时间片轮转
用 SCHED_RR 观察时间片轮转
SCHED_RR 在固定实时优先级上增加了同优先级时间片轮转。本课让两个同优先级任务争用同一个 CPU,观察它们都能获得运行机会,再与同优先级的 SCHED_FIFO 结果对比。
学习目标
- 能创建同优先级的
SCHED_RR任务并读取系统时间片参数。 - 能解释同优先级 RR 任务为什么会轮流获得 CPU。
- 能根据任务是否需要同级公平轮转选择 RR 或 FIFO。
查看 RR 时间片
SCHED_RR 可以看作“带时间片的 SCHED_FIFO”。更高实时优先级仍然具有抢占权;只有多个同优先级且同时可运行的 RR 任务之间,才会在时间片用完后轮到队列中的下一个任务。
现代 Linux 可通过 /proc/sys/kernel/sched_rr_timeslice_ms 查看 RR 基准时间片。实际观察到的连续运行时间还会受阻塞、唤醒和更高优先级任务抢占影响,因此不要把它理解成绝对不变的执行时长。
运行同优先级 RR 对照实验
下面的脚本先运行两个 priority 30 的 RR 任务,再用相同工作负载运行两个 priority 30 的 FIFO 任务。四个任务都固定到同一个 CPU,并使用共同截止时间,便于直接比较。
set -euo pipefail

python3 - <<'PY'
import os
if len(os.sched_getaffinity(0)) < 2:
    raise SystemExit("本实验至少需要 2 个允许使用的 CPU")
PY

cat >/tmp/rt_worker.py <<'PY'
import os
import sys
import time

name = sys.argv[1]
deadline = float(sys.argv[2])
count = 0

while time.monotonic() < deadline:
    count += 1

policy = os.sched_getscheduler(0)
priority = os.sched_getparam(0).sched_priority
policy_name = {
    os.SCHED_FIFO: "SCHED_FIFO",
    os.SCHED_RR: "SCHED_RR",
}.get(policy, str(policy))

print(
    f"{name} policy={policy_name} priority={priority} "
    f"cpu={next(iter(os.sched_getaffinity(0)))} count={count}"
)
PY

sudo -v
CPU=$(python3 -c 'import os; print(max(os.sched_getaffinity(0)))')
RR_MS=$(cat /proc/sys/kernel/sched_rr_timeslice_ms)
echo "sched_rr_timeslice_ms=$RR_MS"

RR_DEADLINE=$(python3 -c 'import time; print(time.monotonic() + 4.0)')
sudo chrt -r 30 taskset -c "$CPU"   python3 /tmp/rt_worker.py rr-a "$RR_DEADLINE" &
RR_A=$!
sudo chrt -r 30 taskset -c "$CPU"   python3 /tmp/rt_worker.py rr-b "$RR_DEADLINE" &
RR_B=$!
wait "$RR_A"
wait "$RR_B"

FIFO_DEADLINE=$(python3 -c 'import time; print(time.monotonic() + 4.0)')
sudo chrt -f 30 taskset -c "$CPU"   python3 /tmp/rt_worker.py fifo-a "$FIFO_DEADLINE" &
FIFO_A=$!
sleep 0.1
sudo chrt -f 30 taskset -c "$CPU"   python3 /tmp/rt_worker.py fifo-b "$FIFO_DEADLINE" &
FIFO_B=$!
wait "$FIFO_A"
wait "$FIFO_B"
预期输出
sched_rr_timeslice_ms=<MS>
rr-a policy=SCHED_RR priority=30 cpu=<CPU> count=<COUNT_A>
rr-b policy=SCHED_RR priority=30 cpu=<CPU> count=<COUNT_B>
fifo-a policy=SCHED_FIFO priority=30 cpu=<CPU> count=<COUNT_C>
fifo-b policy=SCHED_FIFO priority=30 cpu=<CPU> count=<COUNT_D><MS>、<CPU> 和计数会因内核与硬件不同而变化。RR 阶段的 COUNT_A 与 COUNT_B 通常处于相近数量级,说明两个同优先级任务都持续取得 CPU;FIFO 阶段则通常由先启动的 fifo-a 占据绝大多数运行机会,fifo-b 可能接近零。
从时间线理解轮转
RR 任务的时间片只解决同优先级实时任务之间的轮转,并不会削弱实时优先级本身。若 priority 40 的 FIFO 或 RR 任务变为可运行,它仍会立即抢占正在执行的 priority 30 RR 任务。
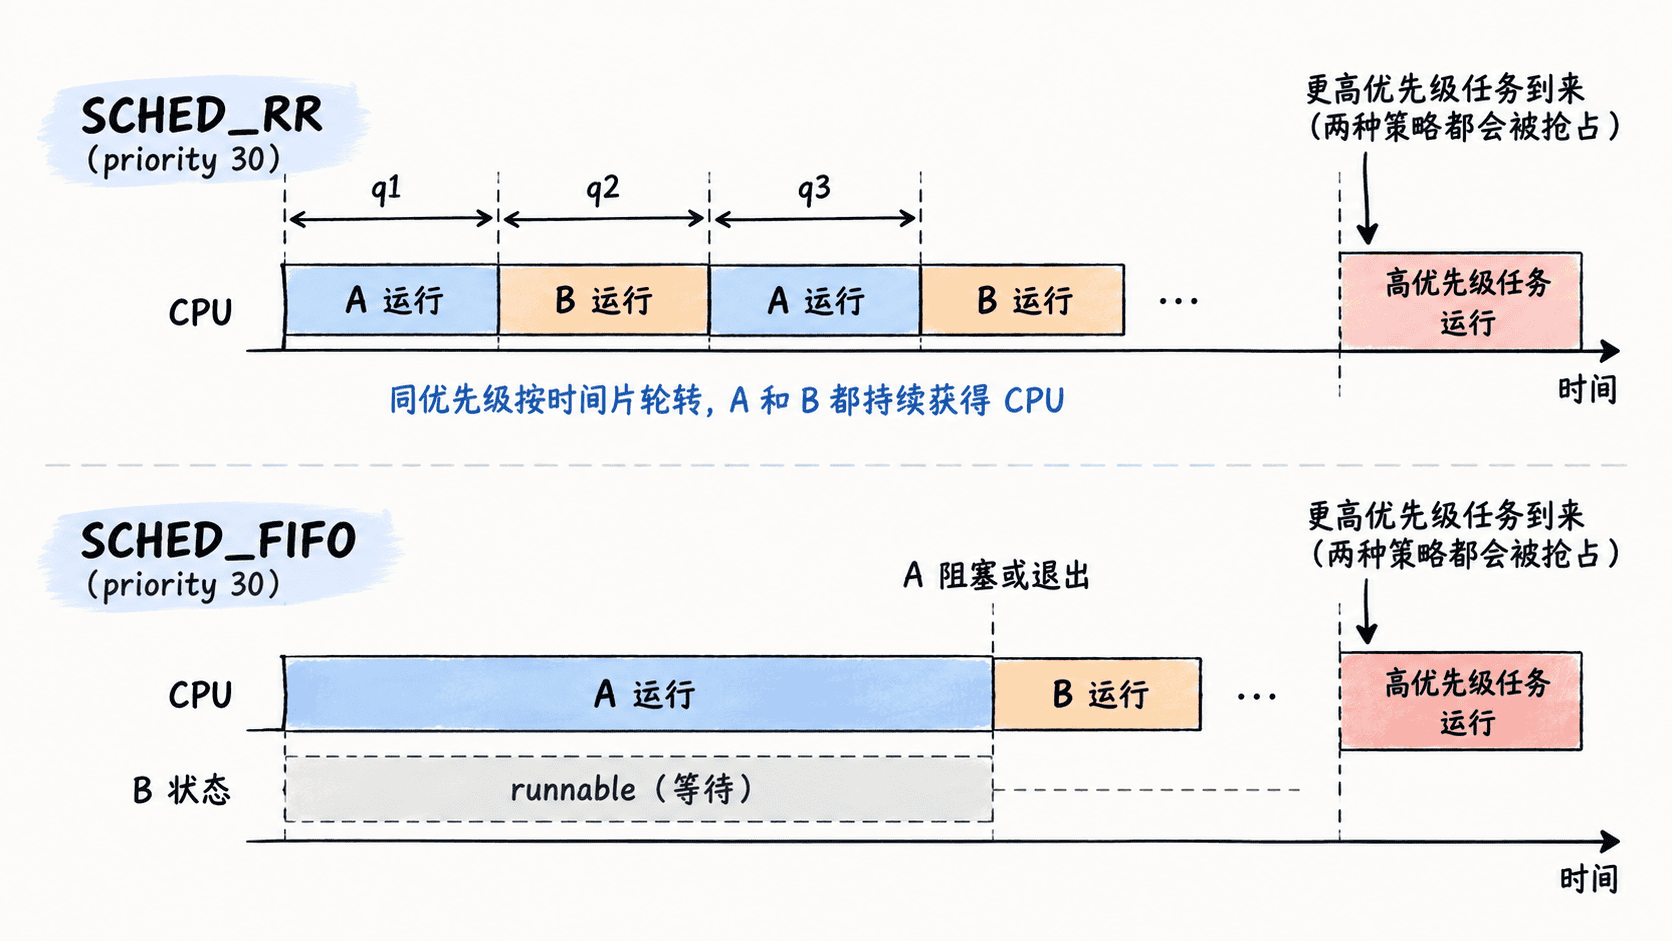
时间片到期并不等于任务一定“停满一个时间片”。如果任务提前阻塞,例如等待网络、锁或设备,它会立刻离开 CPU;之后被唤醒时再按实时队列规则参与调度。因此 RR 提供的是同级 runnable 任务之间的轮转机制,而不是应用层的精确定时器。
选择 RR 还是 FIFO
当一个实时优先级上存在多个长期可运行任务,并且希望它们都周期性获得 CPU 时,SCHED_RR 更容易提供同级公平性。典型例子是多个相似处理线程共享一个固定实时优先级。
SCHED_FIFO 更适合“当前任务应持续运行直到完成、阻塞或主动让出”的短关键路径,但必须严格控制最长执行时间。无论选择哪一种策略,都应先确定优先级层次,再测量最坏执行时间和阻塞行为;仅靠提高实时优先级无法解决设计上的过载问题。
如果 RR 两个计数相差悬殊,优先检查 CPU 亲和性、两者优先级是否一致,以及系统中是否存在更高优先级实时任务。验证 RR 的关键不是追求两个计数完全相等,而是确认两个同级 runnable 任务都能在测试窗口内反复获得 CPU。