
操作系统 / 系统课时
用 CPU 亲和性减少任务迁移
用 CPU 亲和性减少任务迁移
本节用 taskset 和 Linux 亲和性接口把任务限制在指定 CPU 上,并说明这种约束为什么可能减少迁移和缓存失效。目标不是绑定就一定更快,而是能验证设置是否生效,并根据迁移、缓存局部性与负载分布判断绑核是否值得。
学习目标
- 使用
taskset查询和设置任务的 CPU 亲和性 - 用程序接口读取并修改当前线程的 CPU 集合
- 判断绑核带来的缓存收益与负载不均风险
亲和性限制调度器的可选 CPU
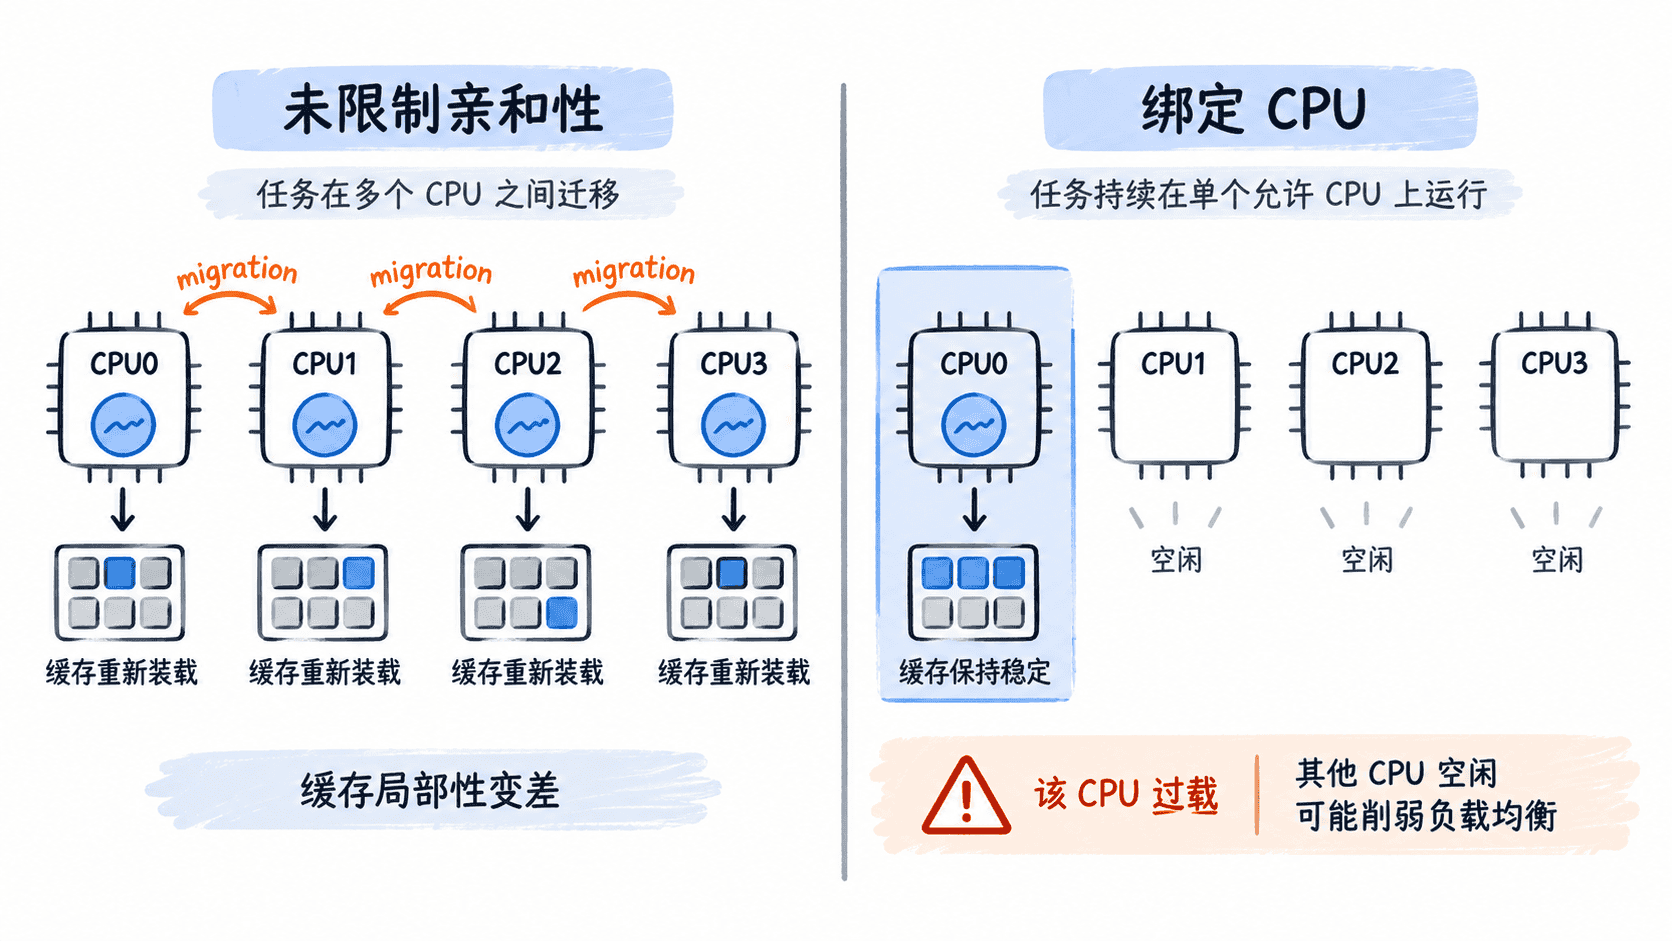
CPU 亲和性是一个允许集合。未绑定任务可能在多个可运行 CPU 之间迁移;设置亲和性后,调度器仍决定何时运行任务,但只能从允许集合中选 CPU。集合只有一个 CPU 时才是严格的单核绑定。
减少迁移有机会保留更好的 L1/L2/LLC 缓存局部性,也能降低某些低延迟线程的抖动。但代价是调度器可用于均衡负载的空间变小,选错 CPU 可能形成热点,甚至与同一物理核上的 SMT 兄弟线程争抢执行资源。
用 taskset 绑定并验证
为了避免假设 CPU 0 一定可用,下面先从当前进程允许的 CPU 中动态取最小编号,再启动一个只允许在该 CPU 上运行的 sleep 进程。容器或 cpuset 环境中,这种写法也能避开被上层限制掉的 CPU。
cpu=$(python3 -c 'import os; print(min(os.sched_getaffinity(0)))')
taskset -c "$cpu" sleep 30 &
pid=$!
taskset -pc "$pid"
ps -o pid,psr,comm -p "$pid"
kill "$pid"
预期输出:
pid <ID>'s current affinity list: <CPU>
    PID PSR COMMAND
   <ID> <CPU> sleep
<ID> 和 <CPU> 会随环境变化。taskset -pc 显示允许集合,PSR 是采样时任务正在运行或最近运行的 CPU;当允许集合只有一个 CPU 时,它应落在同一个 <CPU> 上。
在程序里直接使用亲和性接口
Linux 亲和性是线程级属性。Python 的 os.sched_getaffinity 与 os.sched_setaffinity 可以直接访问这类 Linux 接口,适合在应用启动时由程序自己完成绑定。
import os

allowed = os.sched_getaffinity(0)
cpu = min(allowed)

# PID 0 表示调用线程自身。
os.sched_setaffinity(0, {cpu})
print(sorted(os.sched_getaffinity(0)))
预期输出:
[<CPU>]<CPU> 是当前环境允许集合中的某个实际编号。多线程程序应针对真正需要稳定 CPU 局部性的工作线程设置亲和性;只设置某一个线程后再假设整个程序都固定在同一核上,容易得到错误结论。
用性能结果决定是否绑核
绑核前后至少比较三类证据:CPU migration 次数、缓存未命中或 LLC miss,以及任务真正关心的吞吐或尾延迟。如果迁移减少,但 P99 延迟没有改善,甚至因为目标 CPU 饱和而恶化,就没有必要保留更窄的亲和性。
更适合绑核的场景通常是长时间运行、缓存工作集稳定、对尾延迟敏感的线程,例如专用轮询线程或明确做过 CPU/NUMA 规划的服务。普通短任务、CPU 使用波动大的工作池,以及需要调度器主动填平负载的服务,通常应保留更宽的 CPU 集合。
还要把 cgroup/cpuset、容器 CPU 限制和中断分布一起考虑。用户设置的 affinity 不能突破上层允许的 CPU 集合;如果把应用线程、关键中断和其他高负载任务都挤到同一核,减少迁移反而会换来更严重的排队和资源竞争。