
操作系统 / 系统课时
判断内存压力何时触发 OOM
判断内存压力何时触发 OOM
进程被 OOM Killer 杀掉之前,系统通常已经经历工作集增长、回收加剧、交换活动或内存停顿。判断问题不能只看最后一条 Killed process 日志,而要把 RSS、回收、Swap、memory PSI 与 OOM 记录按时间串起来,确认是泄漏、正常工作集膨胀,还是系统容量本身不够。
学习目标
- 用 RSS、回收、Swap 和 memory PSI 还原 OOM 前的压力过程。
- 区分主机级 OOM 与 cgroup 内存上限触发的 OOM。
- 根据内存曲线和回收效果判断泄漏、工作集膨胀或容量不足。
先建立 OOM 前后的时间线
先确定被杀进程或疑似进程的 <PID>,在问题仍可复现时采集当前 RSS、Swap、全局回收计数、memory PSI 和内核日志。下面命令适用于常见 Linux 主机;dmesg 可能需要 root 权限。
PID="<PID>"
grep -E 'VmRSS|VmSwap|RssAnon|RssFile' "/proc/$PID/status"
grep -E 'pgscan_kswapd|pgscan_direct|pgsteal|pswpin|pswpout' /proc/vmstat
cat /proc/pressure/memory
free -h
sudo dmesg --ctime | grep -Ei 'out of memory|oom-kill|killed process'
预期输出:
VmRSS:      <ID> kB
VmSwap:     <ID> kB
pgscan_kswapd <ID>
pgscan_direct <ID>
pgsteal_anon <ID>
pswpout <ID>
some avg10=<ID> avg60=<ID> avg300=<ID> total=<ID>
full avg10=<ID> avg60=<ID> avg300=<ID> total=<ID>
Mem:        <ID>Gi  <ID>Gi  <ID>Gi
Swap:       <ID>Gi  <ID>Gi  <ID>Gi
<TIME> kernel: Out of memory: Killed process <PID> (<COMM>) ...
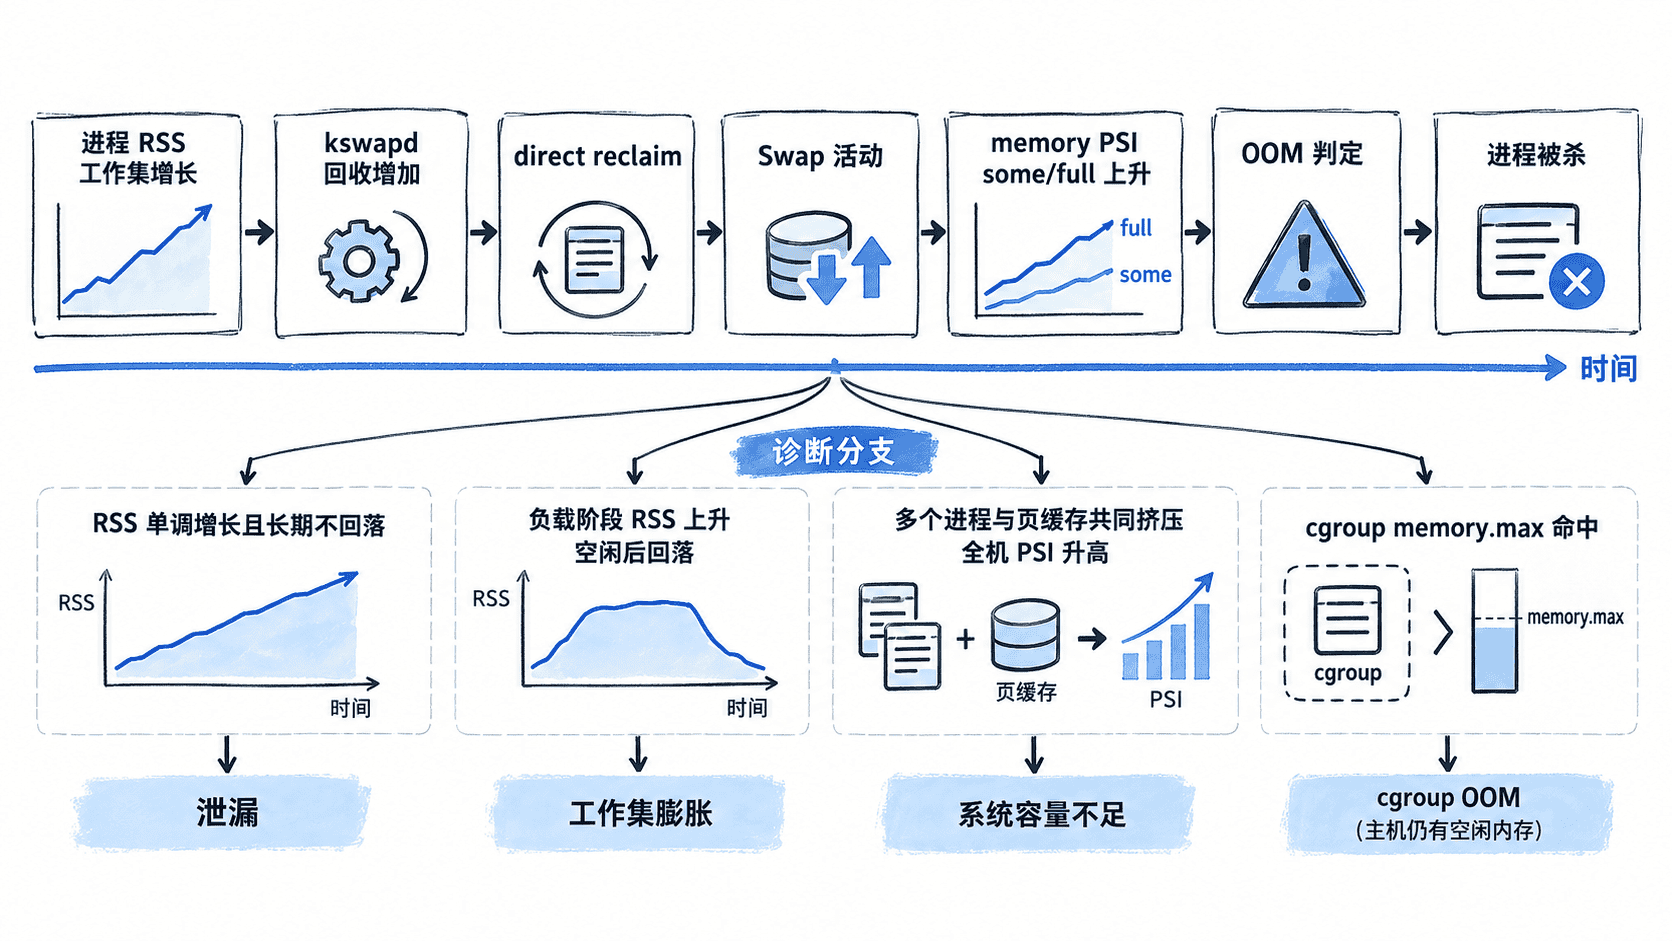
这里最重要的不是单次值,而是趋势。RSS 连续抬升说明驻留工作集变大;pgscan_* 和 pgsteal_* 快速增加说明内核正在积极回收;pswpout 增长说明匿名页开始被换出;memory PSI 的 some/full 上升说明任务已经因为内存资源等待而停顿。
判断回收是否已经失效
内存紧张时,内核会先尝试回收可回收页。正常情况下,扫描页数增加后应能换回足够可用内存;如果扫描量持续很高但可用内存没有恢复,说明回收效率正在下降。
观察时把几个信号放在一起:pgscan_kswapd 增长代表后台回收活跃,pgscan_direct 增长代表分配线程已经被迫自己做回收;后者通常比前者更容易直接制造应用延迟。若同时出现持续 pswpout、高 memory PSI full,说明部分任务已经在内存压力下无法继续执行。
RSS 也不能单独代表“总内存占用”。文件页缓存、共享页、内核内存和 cgroup 计费都会影响系统是否接近极限,因此“某个进程 RSS 不是最大”并不能排除它参与了 OOM。OOM 选择受 oom_score_adj 等因素影响,最终被杀者也不一定是内存占用最大的进程。
区分主机 OOM 与 cgroup OOM
容器或 systemd 服务常运行在 cgroup v2 下。此时即使主机还有可用内存,某个 cgroup 达到 memory.max 也可能在该控制组内触发 OOM。定位时应同时检查限制和事件计数。
CG="/sys/fs/cgroup/<PATH>"
cat "$CG/memory.current"
cat "$CG/memory.max"
cat "$CG/memory.events"
预期输出:
<ID>
<ID>
low 0
high <ID>
max <ID>
oom <ID>
oom_kill <ID>
如果 oom_kill 在故障时增加,而 memory.current 又长期贴近 memory.max,应优先按 cgroup 容量问题处理。若 cgroup 没有限额或事件计数没有变化,而内核日志显示系统级 Out of memory,才继续按主机整体容量与回收问题分析。
区分泄漏、工作集膨胀和容量不足
泄漏的典型特征是同类负载下 RSS 或匿名内存长期单调增长,流量下降后也不明显回落,并且多轮 GC、缓存淘汰或业务周期结束都无法释放。此时应继续向堆快照、分配栈或对象生命周期追踪。
正常工作集膨胀则与业务阶段相关:高峰期 RSS 上升,处理完批次、缓存过期或连接减少后能够回落。如果增长本身符合业务模型,但每到峰值都伴随 direct reclaim、Swap 和高 PSI,问题更像容量余量不足,而不是泄漏。
系统容量不足通常表现为多个进程或页缓存共同挤压内存,单个进程并没有异常单调增长,但全机回收、Swap 与 PSI 一起恶化。此时增加单个服务的内存上限可能只是把压力转移给其他进程,应评估总工作集、并发规模、缓存策略和物理内存余量。
用证据确认真正的触发点
最终判断应能回答一条完整因果链:哪个工作集先增长,回收何时明显加强,direct reclaim 或 Swap 是否出现,memory PSI 从什么时候开始升高,最后是主机级还是 cgroup OOM 触发了杀进程。
只看 Killed process 会错过性能退化阶段,只看 RSS 又会忽略回收与系统级竞争。把这些信号按同一时间轴对齐,才能判断该修的是内存泄漏、峰值工作集、cgroup 限额,还是整机容量。