
操作系统 / 系统课时
用 schedstat 判断调度延迟
用 schedstat 判断调度延迟
CPU 使用率高只能说明处理器忙,不能回答线程究竟在 CPU 上运行了多久、又在运行队列里等了多久。本节直接读取任务和 CPU 的 schedstat 累计值,计算采样窗口内的运行、等待与调度次数增量,再判断是否存在真正的 CPU 排队。
学习目标
- 读懂任务与 CPU
schedstat的运行、等待和调度次数 - 用差分而不是单次绝对值衡量调度等待
- 通过等待占比与平均每次等待识别 CPU 竞争
先明确三个计数器
对任务读取 /proc/<PID>/task/<TID>/schedstat,前三个值分别表示累计 CPU 运行时间、累计 run queue 等待时间和获得 CPU 的次数;前两个时间值以纳秒计。CPU 级 /proc/schedstat 也提供累计调度统计,但格式带版本号,解析时必须先确认 version。
单次绝对值受进程已运行多久影响,诊断时更有意义的是两个采样点之差。设采样窗口内增量分别为 、 和 ,可以计算:
以及平均每次获得 CPU 前的排队时间:
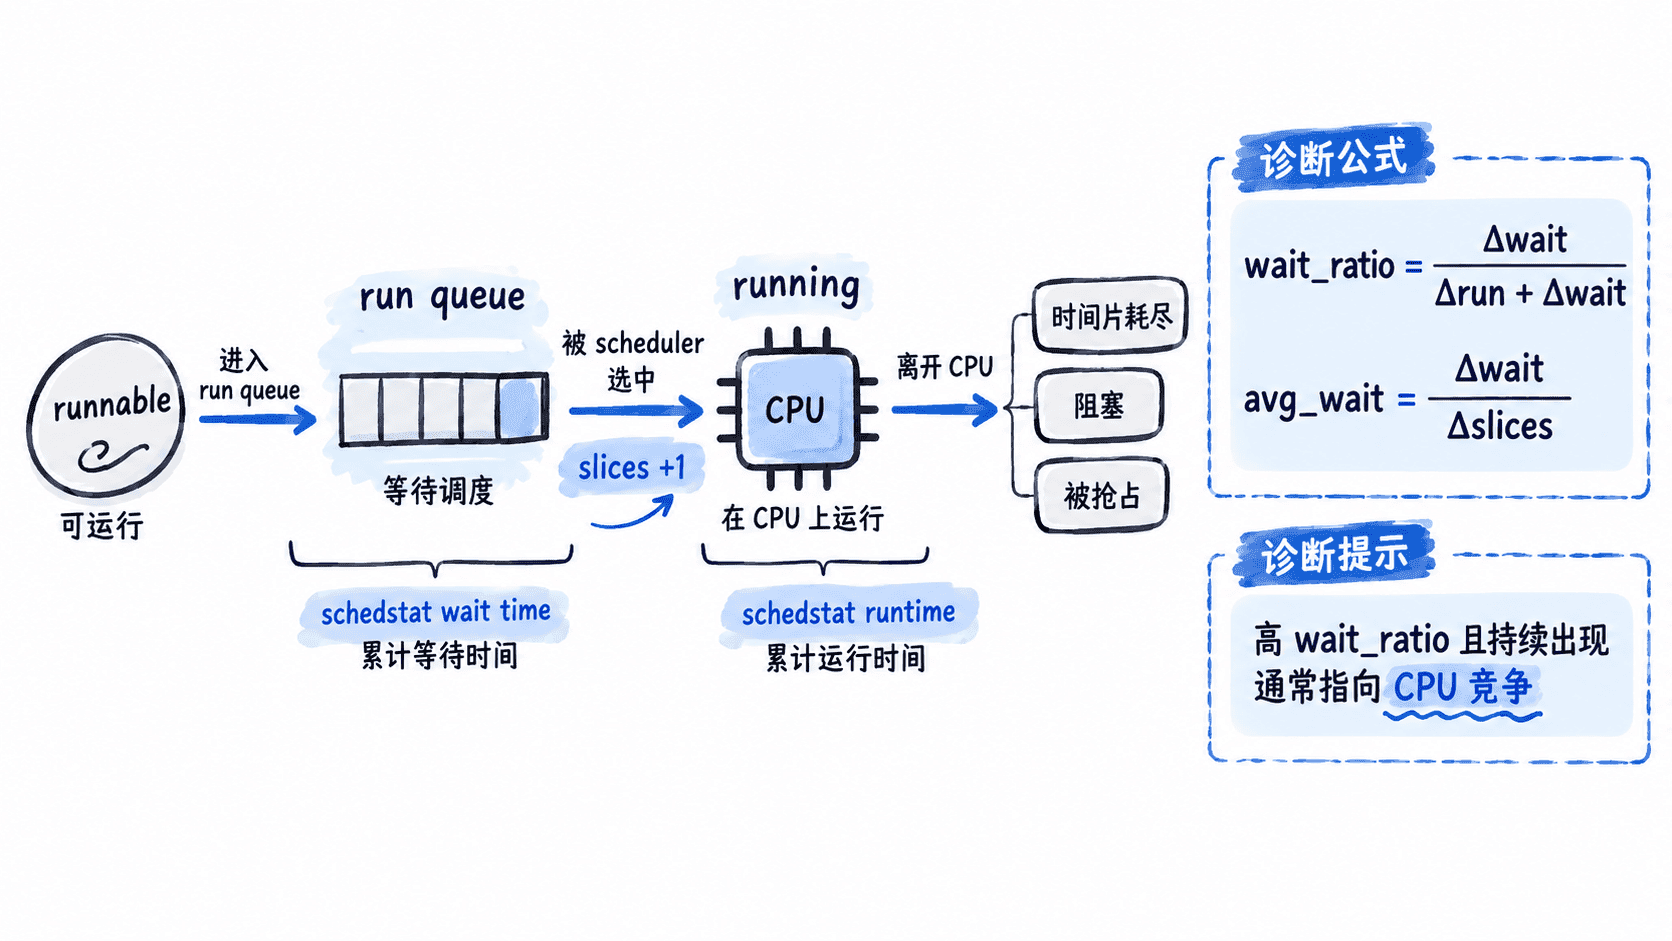
同时采样线程与 CPU 增量
下面的脚本默认采样 5 秒。它统计目标进程中两个采样点都存在的线程,并读取 /proc/schedstat 的 CPU 行。示例只自动解析 schedstat version 15 及以上,因为这些版本的 CPU 行尾部三个字段可用于运行时间、等待时间和 timeslices;更老版本应按对应内核文档调整解析器。把 <ID> 替换为实际 PID。
cat > /tmp/schedstat-delta.sh <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

PID="${1:?usage: $0 PID [seconds]}"
INTERVAL="${2:-5}"
VERSION="$(awk '$1 == "version" {print $2}' /proc/schedstat)"

if [[ -z "$VERSION" || "$VERSION" -lt 15 ]]; then
  echo "unsupported schedstat version: ${VERSION:-unknown}" >&2
  exit 2
fi

declare -A trun0 twait0 tslices0 tname0
declare -A crun0 cwait0 cslices0

for f in /proc/"$PID"/task/*/schedstat; do
  tid="${f%/schedstat}"
  tid="${tid##*/}"
  read -r run wait slices < "$f"
  trun0["$tid"]="$run"
  twait0["$tid"]="$wait"
  tslices0["$tid"]="$slices"
  tname0["$tid"]="$(cat /proc/"$PID"/task/"$tid"/comm)"
done

while read -r cpu run wait slices; do
  crun0["$cpu"]="$run"
  cwait0["$cpu"]="$wait"
  cslices0["$cpu"]="$slices"
done < <(awk '/^cpu[0-9]+ / {print $1, $(NF-2), $(NF-1), $NF}' /proc/schedstat)

sleep "$INTERVAL"

printf 'schedstat_version=%s interval=%ss\n' "$VERSION" "$INTERVAL"
printf '%-7s %-8s %-18s %10s %10s %8s %10s %12s\n' SCOPE ID COMM RUN_MS WAIT_MS SLICES WAIT_PCT AVG_WAIT_MS

for f in /proc/"$PID"/task/*/schedstat; do
  tid="${f%/schedstat}"
  tid="${tid##*/}"
  [[ -n "${trun0[$tid]+x}" ]] || continue
  read -r run wait slices < "$f"
  drun=$((run - ${trun0[$tid]}))
  dwait=$((wait - ${twait0[$tid]}))
  dslices=$((slices - ${tslices0[$tid]}))

  awk -v id="$tid" -v comm="${tname0[$tid]}" -v r="$drun" -v w="$dwait" -v s="$dslices" '
    BEGIN {
      total = r + w
      pct = total > 0 ? 100 * w / total : 0
      avg = s > 0 ? w / s / 1000000 : 0
      printf "%-7s %-8s %-18s %10.2f %10.2f %8d %10.2f %12.3f\n",
             "thread", id, comm, r/1000000, w/1000000, s, pct, avg
    }'
done

while read -r cpu run wait slices; do
  [[ -n "${crun0[$cpu]+x}" ]] || continue
  drun=$((run - ${crun0[$cpu]}))
  dwait=$((wait - ${cwait0[$cpu]}))
  dslices=$((slices - ${cslices0[$cpu]}))

  awk -v id="$cpu" -v r="$drun" -v w="$dwait" -v s="$dslices" '
    BEGIN {
      total = r + w
      pct = total > 0 ? 100 * w / total : 0
      avg = s > 0 ? w / s / 1000000 : 0
      printf "%-7s %-8s %-18s %10.2f %10.2f %8d %10.2f %12.3f\n",
             "cpu", id, "-", r/1000000, w/1000000, s, pct, avg
    }'
done < <(awk '/^cpu[0-9]+ / {print $1, $(NF-2), $(NF-1), $NF}' /proc/schedstat)
EOF

chmod +x /tmp/schedstat-delta.sh
sudo /tmp/schedstat-delta.sh "<ID>" 5
预期输出
schedstat_version=<VERSION> interval=5s
SCOPE   ID       COMM                   RUN_MS    WAIT_MS   SLICES   WAIT_PCT  AVG_WAIT_MS
thread  <ID>     app-worker             <MSEC>     <MSEC>  <COUNT>      <PCT>       <MSEC>
thread  <ID>     app-worker             <MSEC>     <MSEC>  <COUNT>      <PCT>       <MSEC>
cpu     cpu0     -                      <MSEC>     <MSEC>  <COUNT>      <PCT>       <MSEC>
cpu cpu1 - <MSEC> <MSEC> <COUNT> <PCT> <MSEC><VERSION>、<ID>、<MSEC>、<COUNT> 与 <PCT> 都是动态值,实际结果会随内核和负载变化。线程在采样期间创建或退出时,脚本只比较两个采样点都存在的 TID,避免把生命周期变化误算成调度延迟。
用等待比例识别 CPU 竞争
线程的 RUN_MS 高而 WAIT_MS 低,说明它大部分可运行时间都及时拿到了 CPU;WAIT_PCT 持续很高,则说明线程已经 runnable,却长时间排在 run queue 中。如果多个活跃线程都出现类似现象,并且某些 CPU 行也显示较高等待占比,CPU 竞争的证据会明显增强。
AVG_WAIT_MS 是每次被调度前平均等待多久,可用来区分“频繁但短暂地等”与“每次都等很久”。它仍然只是平均值,不能代替尾延迟分布;对延迟敏感的服务,确认排队后还应继续用调度 tracepoint、perf 或 eBPF 查看等待分布和抢占来源。
CPU 行适合确认热点是否集中在少数处理器。例如线程都绑在同一个 CPU、cpuset 配置过窄或 IRQ 负载偏斜时,单个 CPU 的等待可能很高,而全机平均 CPU 使用率并不夸张。此时应同时检查 CPU affinity、cgroup/cpuset 限制和中断分布。
处理常见误判
短采样窗口容易被瞬时突发放大,建议在稳定负载下连续采样多次;线程长期睡眠并不等于调度等待,因为阻塞睡眠时间不会计入 run queue wait。若某线程几乎没有 Δrun 和 Δslices,即使历史累计值很大,也不应据此判断当前存在竞争。
判断调度延迟的关键不是看到“CPU 很高”就下结论,而是证明线程在 runnable 状态下确实花了大量时间等待 CPU。Δwait、Δrun 与 Δslices 提供了这条证据链,再用 CPU 级增量确认热点落在哪些处理器上,就能把“慢”收敛为可验证的调度竞争问题。