
操作系统 / 系统课时
用 bpftrace 抓取调度热点
用 bpftrace 抓取调度热点
静态命令只能看到某一时刻的状态;当线程频繁切换、被反复唤醒或运行时间集中在少数任务上时,需要直接观察调度事件。本节用一个短小的 bpftrace 脚本同时统计切换、唤醒和 CPU 运行时间,并把结果整理成可定位的热点。
学习目标
- 用
sched_switch与sched_wakeup追踪调度事件 - 按线程聚合切换次数、唤醒次数与运行时间
- 根据三类指标区分高切换、高唤醒和真正占用 CPU 的热点
从调度事件建立观测口径
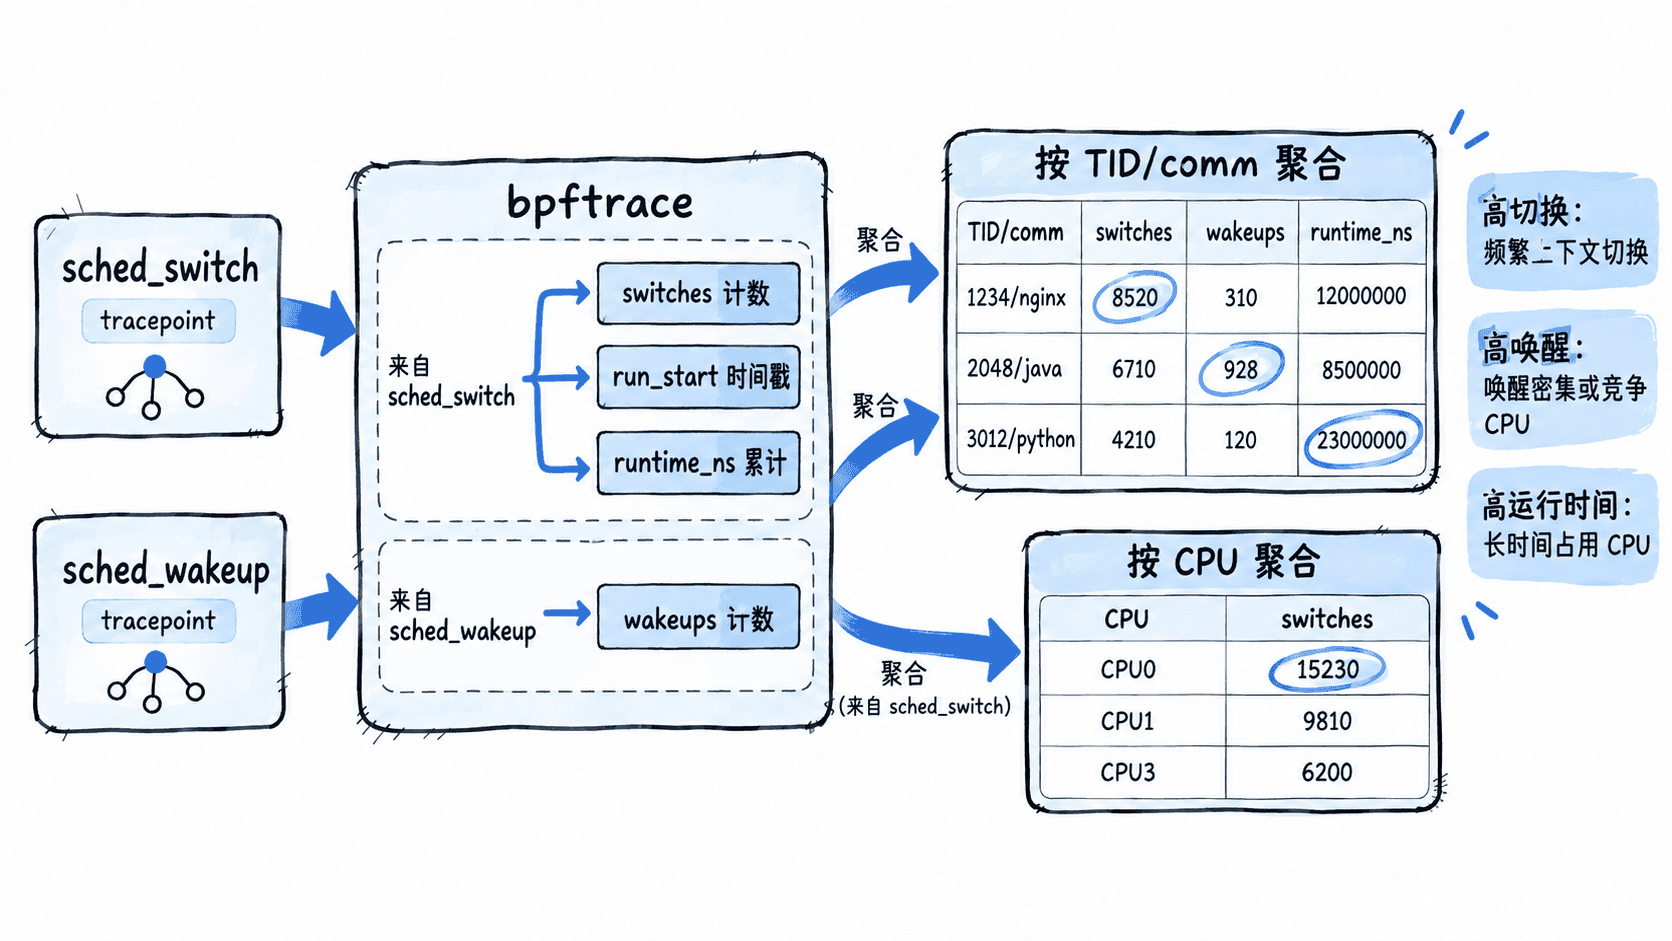
sched_switch 发生在 CPU 从一个线程切换到另一个线程时。把 next_pid 作为键计数,可以得到线程被调度上 CPU 的次数;同时记录它开始运行的时间戳,在下一次作为 prev_pid 被切出时计算时间差,就能累计实际运行时间。
sched_wakeup 则描述一个睡眠线程被唤醒并进入可运行状态。唤醒很多但运行时间不高,常见于锁竞争、短周期轮询或大量细粒度事件;切换很多且运行时间也高,则更像 CPU 密集线程被频繁抢占。
编写并运行热点脚本
下面的脚本每 5 秒打印一次 Top 10。运行需要 root 权限,以及已经安装并可用的 bpftrace;运行前应确认内核暴露 sched_switch、sched_wakeup 与 sched_wakeup_new 这几个调度 tracepoint。
cat > /tmp/sched-hot.bt <<'EOF'
tracepoint:sched:sched_switch
{
  if (args->prev_pid != 0 && @run_start[args->prev_pid]) {
    @runtime_ns[str(args->prev_comm), args->prev_pid] =
        sum(nsecs - @run_start[args->prev_pid]);
    delete(@run_start, args->prev_pid);
  }

  if (args->next_pid != 0) {
    @switches[str(args->next_comm), args->next_pid] = count();
    @run_start[args->next_pid] = nsecs;
  }
  @cpu_switches[cpu] = count();
}

tracepoint:sched:sched_wakeup,
tracepoint:sched:sched_wakeup_new
{
  @wakeups[str(args->comm), args->pid] = count();
}

interval:s:5
{
  printf("\n=== switches: scheduled-in count ===\n");
  print(@switches, 10);
  printf("=== switches by CPU ===\n");
  print(@cpu_switches, 10);
  printf("=== wakeups ===\n");
  print(@wakeups, 10);
  printf("=== runtime_ns ===\n");
  print(@runtime_ns, 10);

  clear(@switches);
  clear(@cpu_switches);
  clear(@wakeups);
  clear(@runtime_ns);
}
EOF

sudo bpftrace /tmp/sched-hot.bt
预期输出
Attaching 4 probes...

=== switches: scheduled-in count ===
@[worker, <ID>]: <COUNT>
@[java, <ID>]: <COUNT>
=== switches by CPU ===
@[<CPU>]: <COUNT>
@[<CPU>]: <COUNT>
=== wakeups ===
@[worker, <ID>]: <COUNT>
@[kworker/0:1, <ID>]: <COUNT>
=== runtime_ns ===
@[java, <ID>]: <NSEC>
@[worker, <ID>]: <NSEC><ID>、<CPU>、<COUNT> 与 <NSEC> 都是运行时动态值,实际数字会不同;runtime_ns 的单位是纳秒。脚本刚启动时,已经在 CPU 上运行的线程还没有对应的 run_start,因此第一个采样窗口可能少算一小段运行时间;跨越打印边界的运行片段也会在切出时计入后一个窗口,所以应连续观察多个窗口。
把三个热点放在一起判断
不要只盯某一张表。切换次数高说明线程频繁获得 CPU,但不等于它消耗了最多 CPU;唤醒次数高说明它或其工作负载频繁从睡眠转为 runnable;运行时间高才直接说明采样窗口内占用了较多 CPU 时间。
如果某线程 wakeups 很高、runtime 很低,应继续检查锁、条件变量、定时器或短轮询;如果 switches 与 runtime 都高,而系统整体 run queue 也长,更像 CPU 竞争。脚本中的 cpu_switches 可以直接暴露切换最密集的 CPU;若需要按进程汇总多个线程,应该再引入稳定的进程标识做聚合,而不要仅按 comm,因为线程名并不保证唯一。
缩小范围并复核热点
全机采样适合找“谁最热”,确认嫌疑对象后应缩小范围,例如只观察目标 CPU 或目标线程,避免其他负载淹没信号。复核时至少连续看几个窗口:一次突发峰值可能只是瞬时任务,持续出现的高 wakeups、高 switches 或高 runtime 才更值得沿锁竞争、CPU 饱和和线程模型继续追查。
bpftrace 的价值不在于替代 top、pidstat,而是把“线程何时被唤醒、何时真正运行、多久后又被切走”变成可聚合的事件证据。先用静态工具发现异常,再用这些调度事件解释异常,定位会比只看平均 CPU 使用率更可靠。