
操作系统 / 系统课时
定位锁竞争造成的延迟尖峰
定位锁竞争造成的延迟尖峰
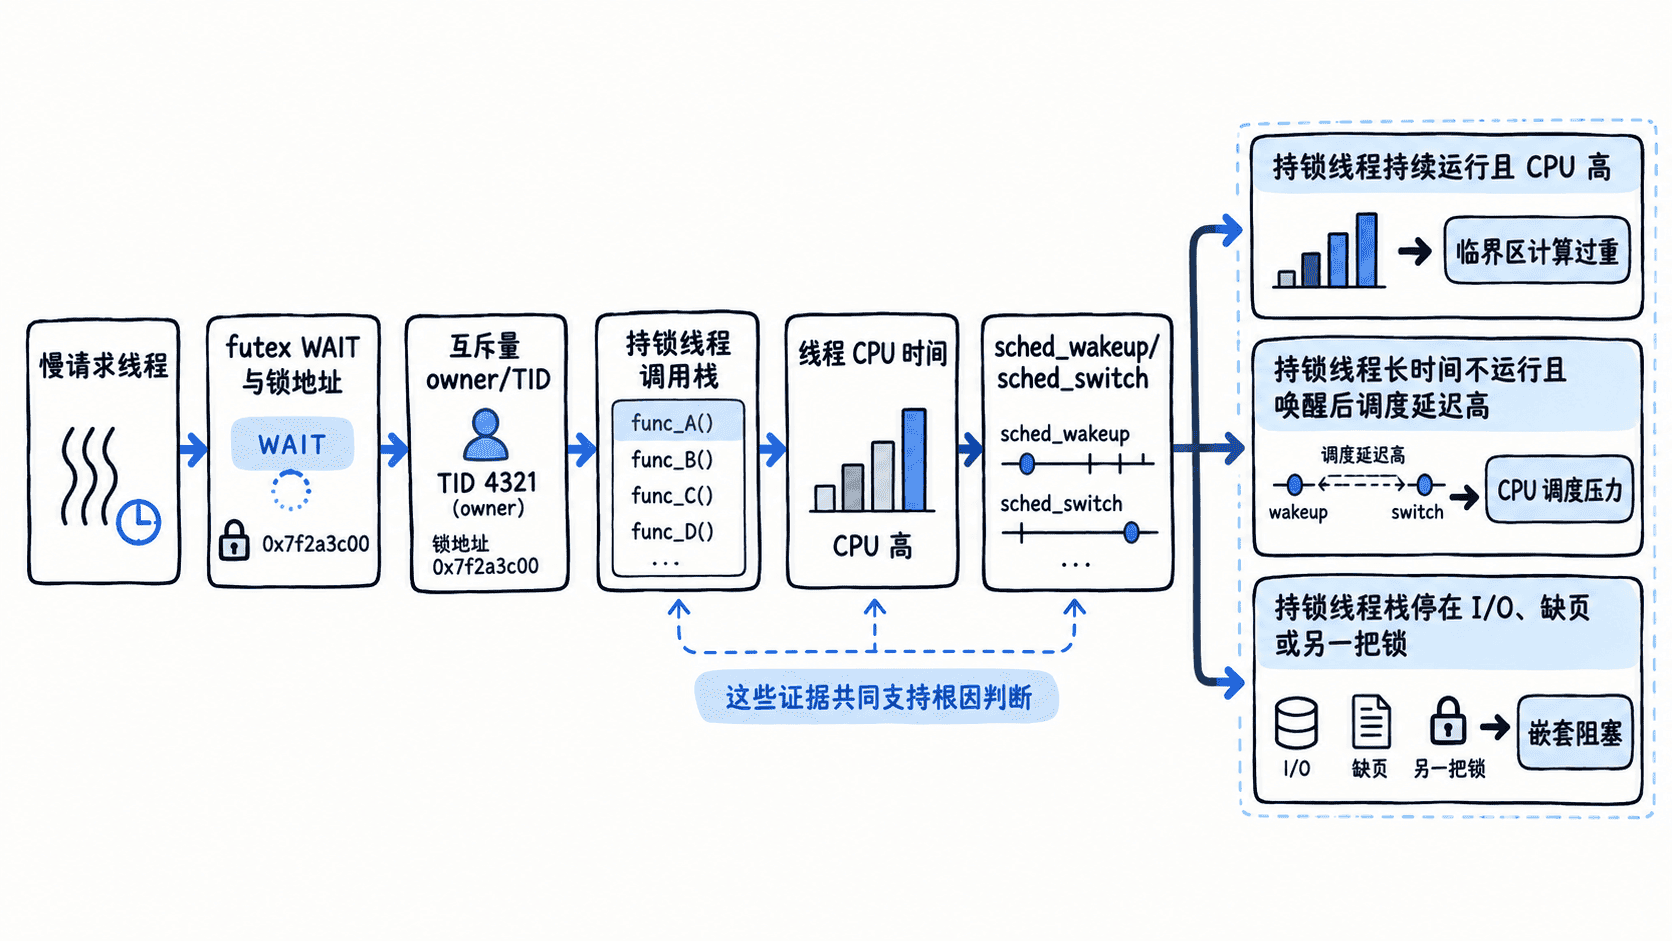
当请求尾延迟突然抬高,而 CPU 利用率并不一定异常时,真正的瓶颈可能是某个线程长时间持锁。定位时要从等待线程的 futex 证据出发,反查锁对象和持锁者,再用 CPU 时间与唤醒事件判断持锁者究竟是在计算、被抢占,还是又阻塞在别处。
学习目标
- 从
futex等待识别发生锁竞争的线程和锁地址。 - 反查持锁线程,并用线程栈确认临界区中的实际工作。
- 结合线程 CPU 时间与调度唤醒事件区分“锁慢”和“调度慢”。
从延迟线程确认 futex 等待
Linux 的 pthread_mutex、条件变量等用户态同步原语在发生竞争时通常会落到 futex。因此,先盯住延迟请求对应的线程,而不是先看整个进程的平均 CPU。
对目标进程执行下面的跟踪。<PID> 替换为真实进程号,输出中的线程号、地址和耗时会随现场变化。
sudo strace -f -ttT -e trace=futex -p "<PID>"预期输出:
[pid <ID>] <TIME> futex(0x<ADDR>, FUTEX_WAIT_PRIVATE, 2, NULL) = 0 <0.083421>
[pid <ID>] <TIME> futex(0x<ADDR>, FUTEX_WAKE_PRIVATE, 1) = 1 <0.000041>
如果同一批慢请求对应的线程反复在同一 0x<ADDR> 上执行 FUTEX_WAIT,而单次等待与延迟尖峰量级接近,就已经拿到“等待发生在某把锁上”的直接证据。单独看到一次 futex 不能证明瓶颈;条件变量、线程池等待也会使用它,所以还要继续确认持锁者和调用栈。
从锁地址找到持锁者
在 glibc 的普通 pthread_mutex_t 上,futex 使用的锁字通常位于互斥量内部。若进程保留了可用符号,可以把上一步得到的地址交给 GDB,读取 glibc 的 owner 字段并同时抓取全部线程栈。该字段属于 glibc 实现细节,只适合诊断,不应写进业务逻辑。
sudo gdb -q -batch -p "<PID>" \
  -ex 'p ((pthread_mutex_t*)0x<ADDR>)->__data.__owner' \
  -ex 'thread apply all bt'
预期输出:
$1 = <ID>
Thread <ID> (LWP <ID>):
#0  <critical_function> (...)
#1  <caller_function> (...)
...
Thread <ID> (LWP <ID>):
#0  __futex_abstimed_wait_common64 (...)
#1  ___pthread_mutex_lock (...)
...
__owner 给出的 LWP/TID 就是首要持锁嫌疑者。随后在 thread apply all bt 中找到同一 TID:如果它停在业务临界区、内存分配、日志写入、磁盘 I/O 或另一个同步原语上,就能解释为什么锁长期不释放。
若二进制完全剥离符号,或互斥量不是 glibc 普通 mutex,不要强行依赖 __owner。这时应改用应用级锁埋点、带 off-CPU 能力的 profiler,或 eBPF 的 futex/调度跟踪,把等待地址、TID 与用户栈关联起来。
用 CPU 时间判断持锁者在做什么
确认 TID 后,再观察各线程的用户态和内核态 CPU。下面命令连续采样 5 次,每秒一次。
pidstat -t -p "<PID>" 1 5预期输出:
Time        UID      TGID       TID    %usr %system  %CPU  Command
<TIME>     <ID>      <PID>      <ID>   78.0     2.0  80.0  app
<TIME>     <ID>      <PID>      <ID>    0.0     0.0   0.0  app
如果持锁 TID 在尖峰期间持续占用较高 CPU,优先检查临界区是否包含大循环、序列化、压缩、正则匹配或大对象处理。此时“锁竞争”是表象,根因是临界区工作量过大。
如果持锁 TID 的 CPU 很低,却迟迟不释放锁,则要检查它是否被抢占、发生主缺页、进入系统调用、等待 I/O,或又卡在另一把锁上。低 CPU 并不代表线程健康,只说明它没有在 CPU 上执行。
用唤醒事件排除调度延迟
最后要回答一个关键问题:持锁线程已经可以运行之后,是否还因为 CPU 饱和而排队。perf sched 会记录 sched_wakeup 与 sched_switch 等事件,再用时间线查看线程从被唤醒到真正获得 CPU 的间隔。
sudo perf sched record -a -- sleep 5
sudo perf sched timehist --pid "<PID>"
预期输出:
time    cpu  task name      wait time  sch delay  run time
<TIME>  <ID> app[<ID>]        0.002      0.041      0.006
<TIME>  <ID> app[<ID>]        0.001      0.000      0.004
重点看持锁 TID 的 sch delay。如果它经常被唤醒却要几十毫秒后才运行,锁等待里混入了明显的调度排队,此时继续缩短等待线程代码几乎没有意义,应进一步检查 run queue、CPU 绑核、优先级和同机高负载任务。
相反,如果 sch delay 很小,而持锁线程持续运行或停在明确的阻塞调用上,就应回到临界区本身。可靠的结论必须同时满足三条证据:等待线程确实在同一锁上睡眠、持锁者身份可解释、持锁者的 CPU 或唤醒时间线能解释持锁时长。