
操作系统 / 系统课时
验证写时复制何时真正发生
验证写时复制何时真正发生
本节用一个可重复的 Linux 实验把 COW 从概念变成可观察证据:先在 fork 前预热匿名页,再让子进程只写一半页面,对比共享/私有脏页与 minor fault,定位物理页真正复制的时刻。
学习目标
- 解释
fork后页表复制与物理页复制为什么不是同一时刻。 - 用
/proc/self/smaps和 minor fault 识别 COW 写入成本。 - 避免用 RSS 直接判断物理内存是否已经复制。
COW 推迟的是物理页复制
fork 创建子进程时,Linux 会建立新的进程地址空间与页表,但可把父子页表项暂时指向同一批物理页,并把这些页设置成需要写时复制的状态。只读访问继续共享;任一进程第一次写某个页时,CPU 触发页错误,内核才为写入方准备独立物理页并更新页表。
这个页错误通常是 minor fault:原数据已经在内存里,不需要从磁盘读取。真正的成本来自页错误处理、物理页分配和内容复制,而不是 fork 调用一次性复制全部用户内存。
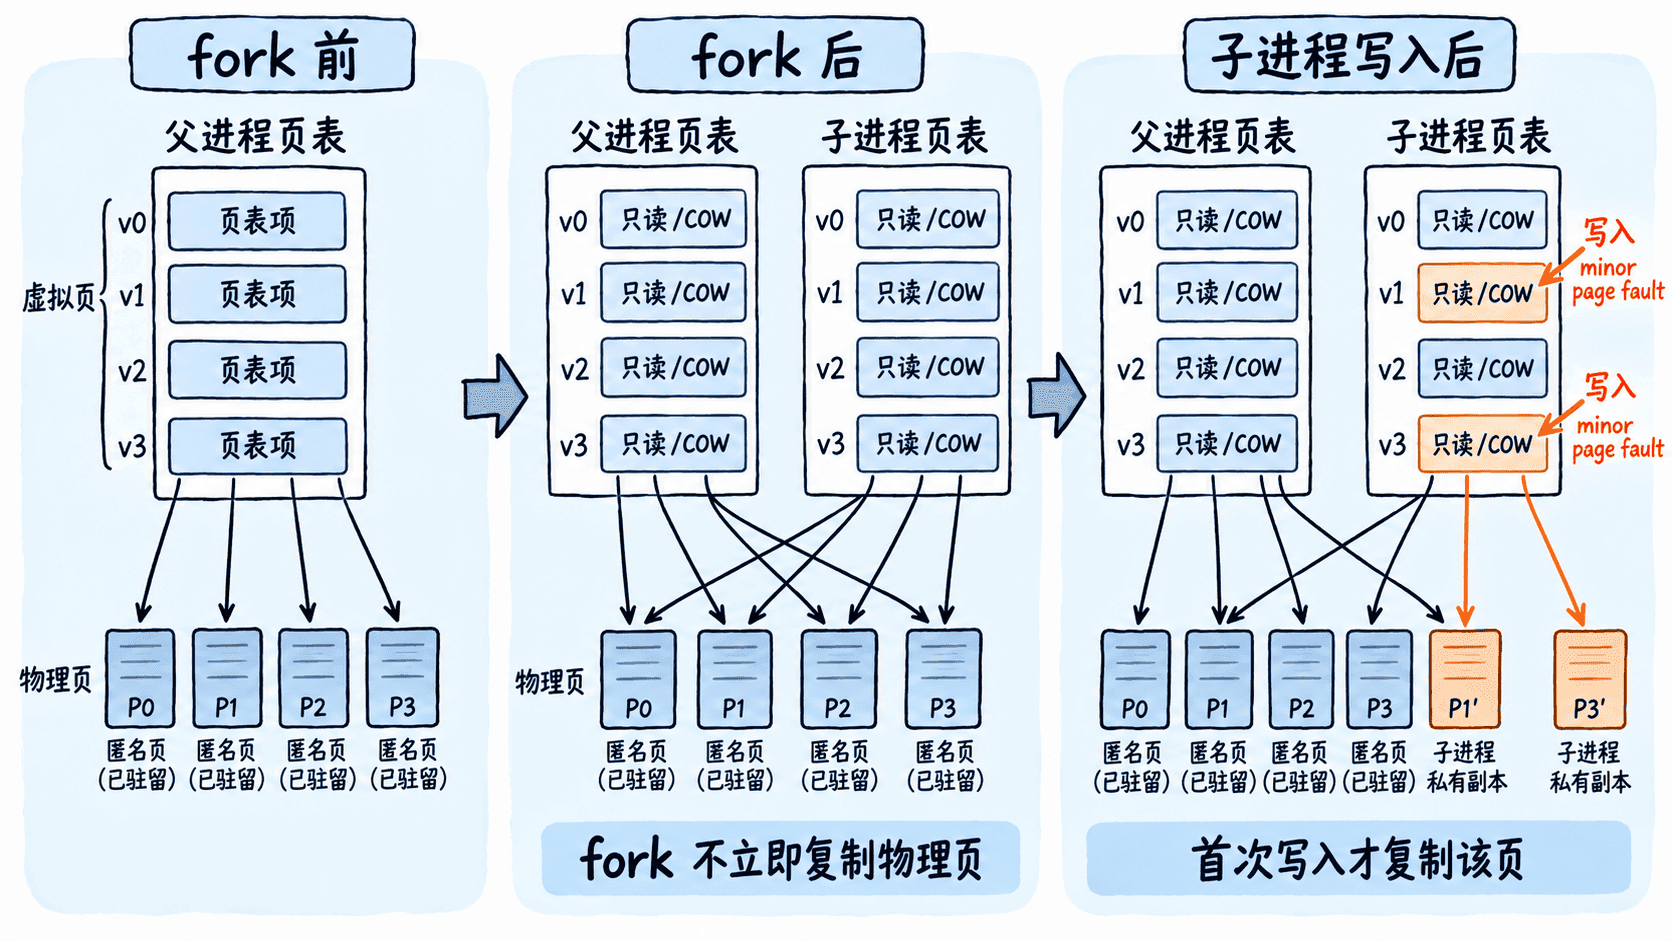
RSS 只表示当前驻留了多少页,同一共享物理页可同时计入父进程和子进程 RSS,因此把两个 RSS 相加会高估独占内存。观察 COW 更适合同时看 Shared_Dirty、Private_Dirty、PSS 与 minor fault。
用页级指标抓住复制时刻
下面程序映射 64 MiB 匿名私有内存并在 fork 前写满,使页面先真正驻留;子进程随后只修改前一半页面。程序按映射地址解析 /proc/self/smaps,避免把其他 VMA 的统计混进来,并用 MADV_NOHUGEPAGE 尽量减少透明大页对页级观察的干扰。
在 Linux + glibc 环境中保存为 cow.c,用 GCC 编译后运行。
#define _GNU_SOURCE
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/mman.h>
#include <sys/resource.h>
#include <sys/types.h>
#include <sys/wait.h>
#include <unistd.h>

typedef struct {
    long rss_kb;
    long pss_kb;
    long private_dirty_kb;
    long shared_dirty_kb;
} Stats;

static int read_mapping_stats(void *addr, Stats *s) {
    FILE *fp = fopen("/proc/self/smaps", "r");
    if (fp == NULL) return -1;

    memset(s, 0, sizeof(*s));
    char line[512];
    unsigned long target = (unsigned long)addr;
    int in_target = 0;

    while (fgets(line, sizeof(line), fp) != NULL) {
        unsigned long start, end;
        if (sscanf(line, "%lx-%lx", &start, &end) == 2) {
            in_target = (target >= start && target < end);
            continue;
        }
        if (!in_target) continue;

        long value;
        if (sscanf(line, "Rss: %ld kB", &value) == 1) s->rss_kb = value;
        else if (sscanf(line, "Pss: %ld kB", &value) == 1) s->pss_kb = value;
        else if (sscanf(line, "Private_Dirty: %ld kB", &value) == 1) s->private_dirty_kb = value;
        else if (sscanf(line, "Shared_Dirty: %ld kB", &value) == 1) s->shared_dirty_kb = value;
    }

    fclose(fp);
    return 0;
}

static long minor_faults(void) {
    struct rusage usage;
    if (getrusage(RUSAGE_SELF, &usage) != 0) return -1;
    return usage.ru_minflt;
}

static void report(const char *label, void *addr) {
    Stats s;
    if (read_mapping_stats(addr, &s) != 0) {
        perror("read /proc/self/smaps");
        exit(EXIT_FAILURE);
    }
    printf("%s rss_kb=%ld pss_kb=%ld private_dirty_kb=%ld shared_dirty_kb=%ld minflt=%ld\n",
           label, s.rss_kb, s.pss_kb, s.private_dirty_kb,
           s.shared_dirty_kb, minor_faults());
}

int main(void) {
    const size_t bytes = 64UL * 1024 * 1024;
    const long page_size = sysconf(_SC_PAGESIZE);
    unsigned char *buf = mmap(NULL, bytes, PROT_READ | PROT_WRITE,
                              MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
    if (buf == MAP_FAILED) {
        perror("mmap");
        return EXIT_FAILURE;
    }

    (void)madvise(buf, bytes, MADV_NOHUGEPAGE);
    memset(buf, 0x5a, bytes);  // fork 前先让每页真正驻留。
    setvbuf(stdout, NULL, _IONBF, 0);

    pid_t pid = fork();
    if (pid < 0) {
        perror("fork");
        return EXIT_FAILURE;
    }

    if (pid == 0) {
        report("child-before", buf);
        long before = minor_faults();

        // 只写前半区域,每页改 1 字节,逼出逐页 COW。
        for (size_t off = 0; off < bytes / 2; off += (size_t)page_size) {
            buf[off] ^= 0x01;
        }

        long delta = minor_faults() - before;
        report("child-after", buf);
        printf("cow_minor_faults=%ld touched_pages=%zu\n",
               delta, (bytes / 2) / (size_t)page_size);
        munmap(buf, bytes);
        return 0;
    }

    waitpid(pid, NULL, 0);
    munmap(buf, bytes);
    return 0;
}
预期输出
child-before rss_kb=<KB> pss_kb=<KB> private_dirty_kb=<KB> shared_dirty_kb=<KB> minflt=<COUNT>
child-after rss_kb=<KB> pss_kb=<KB> private_dirty_kb=<KB> shared_dirty_kb=<KB> minflt=<COUNT>
cow_minor_faults=<COUNT> touched_pages=<COUNT>
实际数值会随页大小、内核和运行环境变化。常见 4 KiB 页环境中,写 32 MiB 会触碰约 8192 页;关键不是绝对数,而是写入后 Private_Dirty 明显增加、Shared_Dirty 大致减少同等规模,同时 cow_minor_faults 接近被触碰页数。
读懂为什么 RSS 没有同步翻倍
子进程写入前,64 MiB 映射已驻留,所以它的 RSS 已经接近 64 MiB;这些页只是与父进程共享。写一半之后,子进程仍然驻留约同样数量的虚拟页,因此 RSS 可以几乎不变,但其中约一半从共享页变成了自己的私有副本。
PSS 会按共享者数量分摊共享页。假设只有父子两个进程共享,写入前子进程 PSS 约为共享区域的一半;写一半后,私有的一半全部计给子进程,仍共享的一半只计一半,因此 PSS 会明显上升。这比 RSS 更能反映 COW 后的实际内存归属。
避免把其他缺页行为误认为 COW
必须先在 fork 前触碰实验区域,否则子进程第一次写页时可能同时混入按需分配零页的成本,实验就不再只验证 COW。程序也只统计目标 VMA,避免堆、动态库和日志输出自身的页错误污染结论。
透明大页可能让复制和计数以更大粒度发生,所以页错误数未必严格等于 4 KiB 页数。若看到 Private_Dirty 增长和 minor fault 增量与预期趋势一致,就已经抓住关键证据:fork 先共享物理页,真正的复制成本被推迟到首次写入对应页面时才支付。