
消息队列 / 系统课时
重试到底在重试什么
重试到底在重试什么
这一课解决一个常见误区:Producer 的“重试”并不是重新执行一次业务代码,而是对一次发送请求失败后的重新投递。理解失败发生在哪一层,才能判断为什么会重复、何时仍值得继续重试。
学习目标
- 说清 Producer 重试针对的是哪一次发送请求,以及什么情况下会触发。
- 区分“客户端重试”“消息重复到达”和“业务重复处理”三个概念。
- 能结合幂等生产者判断重试策略对可靠性与重复风险的影响。
重试发生在发送链路,而不是业务代码
调用 send() 后,Producer 会把记录放入批次并向 Broker 发送 Produce 请求。若请求遇到可恢复的瞬时错误,客户端可以重新发送对应记录;这个过程发生在 Producer 内部,业务线程并不会因为一次底层重试而自动再次执行创建订单、扣库存之类的业务代码。
因此,“重试一次”更准确地理解为:同一条待投递记录再次尝试获得 Broker 的确认。重试受 delivery.timeout.ms 等发送时限约束,不应把 retries 简单理解成“业务逻辑再执行 N 次”。
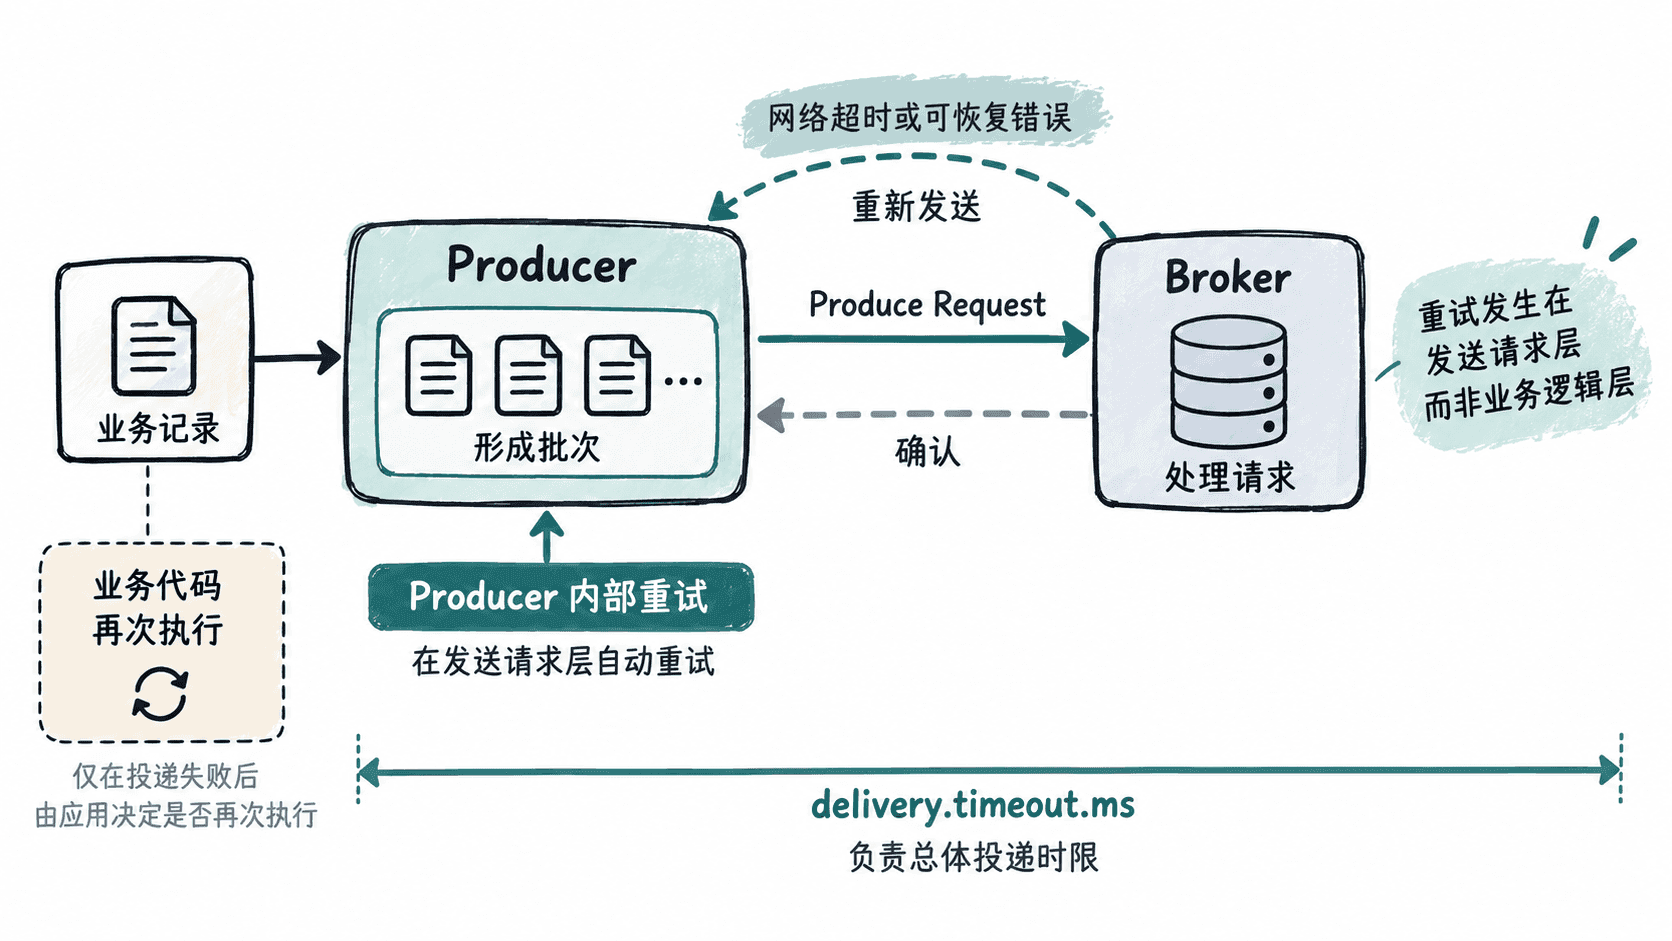
为什么重试可能带来重复
客户端无法总是准确知道 Broker 究竟有没有接受一条记录。典型情况是:Broker 已经写入并准备回复,但 Producer 在等待响应时发生网络中断。Producer 看到的是“请求失败或超时”,于是再次发送;从客户端视角这是合理的重试,从系统整体视角却可能出现前一次已经成功、后一次又抵达的情况。
这也是“至少一次”语义下重复风险的来源之一。重复不等于 Producer 一定会把业务代码执行两遍,而是同一业务记录可能被 Broker 接收不止一次,进而可能被下游重复消费。真正需要控制的是从生产、传输到消费的整条链路。
幂等生产者解决哪一层问题
Kafka Producer 支持幂等发送,用来降低由于生产者重试导致的重复记录风险。启用幂等后,Producer 会携带序列信息,Broker 可以识别同一生产者会话中的重复发送,从而避免把同一逻辑发送重复写入分区日志。
这并不意味着业务天然幂等。比如业务连续发送两条内容完全不同、但都表示“给用户充值 100 元”的消息,Kafka 无法判断它们是不是业务重复操作。因此,Producer 幂等解决的是生产请求重复写入的问题,业务去重仍需要业务标识、幂等键或消费侧约束。
一个主示例:把重试配置交给投递时限控制
下面示例展示 Java Producer 的核心可靠投递配置。这里不手动设置一个很小的 retries 次数,而是让 delivery.timeout.ms 作为单条记录从发送到最终失败的总体边界,同时显式开启幂等,并补齐创建 KafkaProducer 所需的 key/value serializer。
片段示例:需要 Kafka 集群可连接,<PORT> 为实际 Broker 端口。
import java.util.Properties;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.common.serialization.StringSerializer;

public class ProducerRetryConfigDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put("bootstrap.servers", "localhost:<PORT>");
        props.put("key.serializer", StringSerializer.class.getName());
        props.put("value.serializer", StringSerializer.class.getName());
        props.put("enable.idempotence", "true");
        // 让总体投递时限决定何时最终失败,而不是人为限制重试次数。
        props.put("delivery.timeout.ms", "120000");
        props.put("request.timeout.ms", "30000");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            System.out.println("idempotence=" + props.getProperty("enable.idempotence"));
            System.out.println("delivery.timeout.ms=" + props.getProperty("delivery.timeout.ms"));
        }
    }
}
预期输出
idempotence=true
delivery.timeout.ms=120000
这里的关键不是 120000 这个具体数值,而是职责分层:request.timeout.ms 控制一次请求等待响应的时间,delivery.timeout.ms 控制一条记录最终报告成功或失败的总体时限。生产环境应结合 Broker、网络和业务 SLA 设计数值,而不是机械追求“重试越多越可靠”。
看到重复时先问三个问题
排查重复消息时,先判断重复发生在哪一层:Producer 是否经历了请求超时或网络重连;Broker 是否实际写入过前一次请求;Consumer 是否因为重新拉取、重平衡或业务处理失败再次处理。
只有把这三层分开,才能避免把“Producer 重试”直接等同于“业务执行两次”。可靠投递的目标也不是消灭所有重试,而是在可接受的时间边界内提高成功概率,同时把无法避免的重复风险交给幂等机制和业务约束处理。