
消息队列 / 系统课时
Producer 事务怎么执行
Producer 事务怎么执行
本课把 Kafka Producer 事务拆成一条可执行的生命周期:初始化事务、开始事务、发送消息、提交或回滚,并说明消费位点怎样与事务绑定。学完后可以按这条顺序组织事务代码和排查提交失败。
学习目标
- 能说清 Producer 事务从初始化到提交或中止的完整生命周期。
- 能正确区分
beginTransaction、commitTransaction和abortTransaction的职责。 - 能理解事务提交失败、中止以及消费者可见性之间的关系。
事务生命周期怎么走
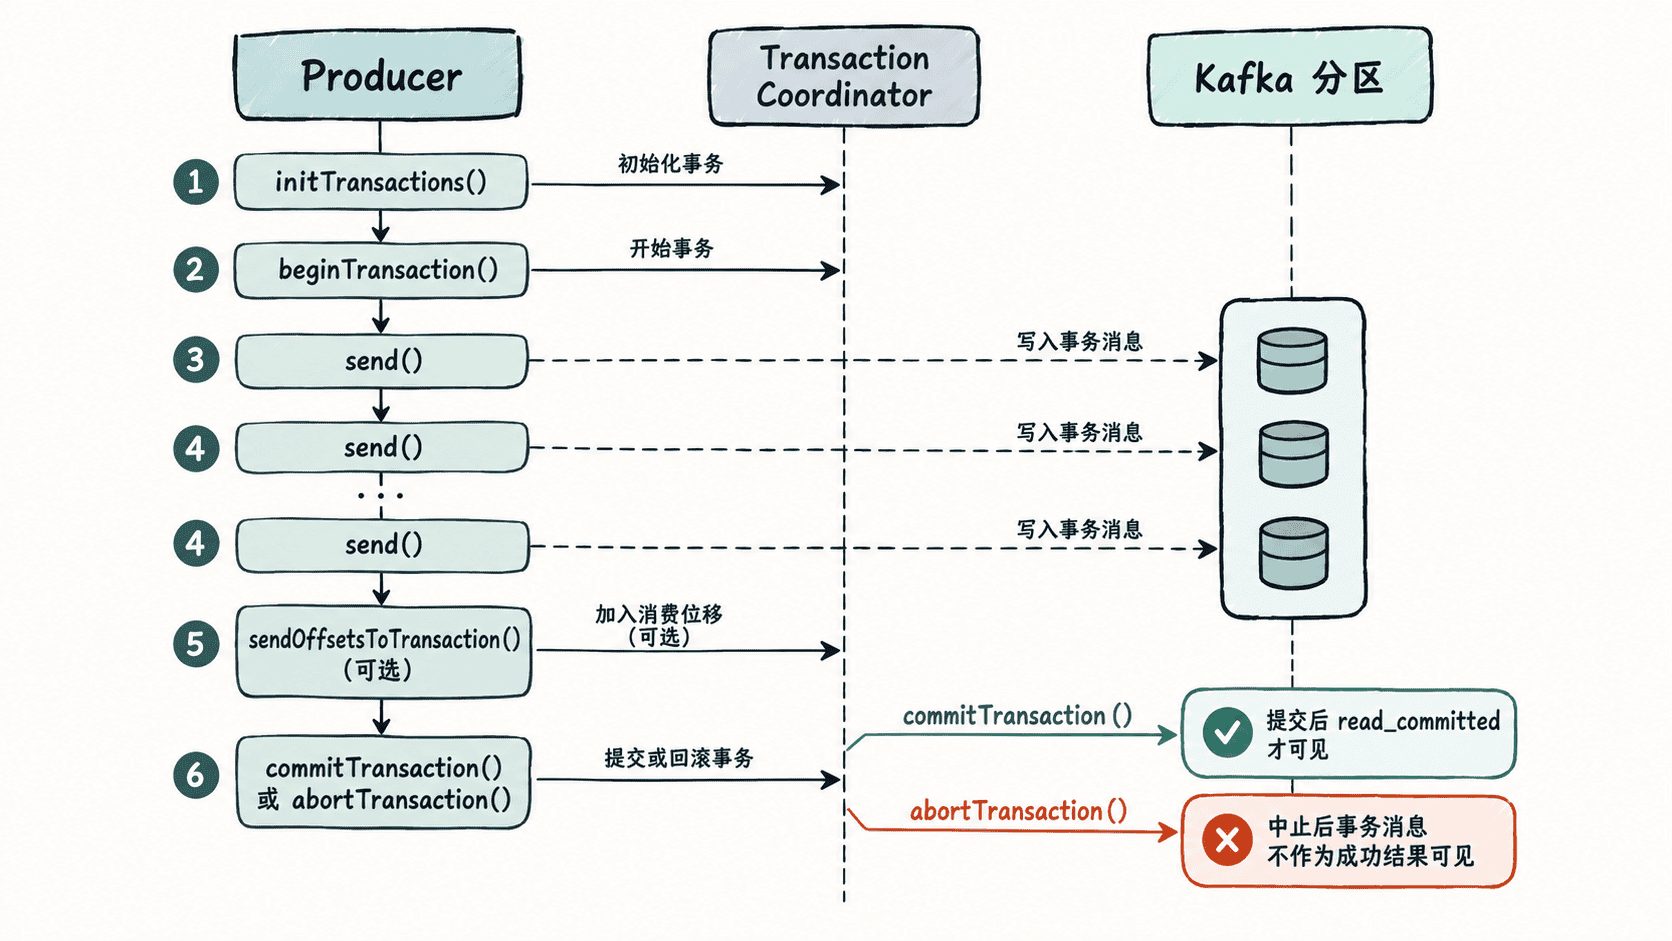
事务生产者首先需要配置唯一的 transactional.id,然后调用 initTransactions() 完成事务状态初始化。真正执行一次原子操作时调用 beginTransaction(),随后把属于该事务的消息发送出去;全部成功后调用 commitTransaction(),出现不可恢复错误或主动放弃时调用 abortTransaction()。
在消费—处理—再生产模式中,事务还可以通过 sendOffsetsToTransaction() 把消费位点加入当前事务。这样事务提交时,输出消息与位点一起生效;事务中止时,本次事务中的输出消息和消费位点都不会作为成功结果提交。
最小事务示例
下面示例使用 Java Kafka Producer API,展示最小的事务提交路径。代码中的 Broker 地址、Topic 和事务 ID 是示例值,实际环境应替换为部署配置。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

public class KafkaTransactionDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BROKER>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "<TRANSACTIONAL_ID>");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.initTransactions();
            producer.beginTransaction();
            try {
                // 两条输出消息属于同一个事务提交边界。
                producer.send(new ProducerRecord<>("orders", "<ORDER_ID>", "created"));
                producer.send(new ProducerRecord<>("order-events", "<ORDER_ID>", "order-created"));
                producer.commitTransaction();
            } catch (RuntimeException e) {
                // 当前事务无法继续时放弃整组输出,避免只提交其中一部分。
                producer.abortTransaction();
                throw e;
            }
        }
    }
}
预期结果
事务成功时,两条消息都作为同一事务的提交结果生效;事务执行失败并进入 abortTransaction() 时,这两条事务消息不会作为成功提交结果被 read_committed 消费者读取。每个 API 在生命周期中的职责
initTransactions() 负责让事务生产者完成事务身份的初始化工作,它不是一次业务事务的开始。业务事务应从 beginTransaction() 开始,到 commitTransaction() 或 abortTransaction() 结束。
send() 只是把消息加入当前事务的生产流程,并不代表消费者已经看到消息。只有事务提交后,事务结果才对 read_committed 消费者可见。由于 send() 本身是异步调用,实际业务代码还必须考虑发送过程中出现的异常以及提交阶段的失败。
abortTransaction() 的语义是放弃当前事务。它不是“撤销一个已经提交的事务”,因此不能在 commitTransaction() 成功以后再把结果回滚。
消费位点如何进入事务
在 Kafka 消费—处理—再生产场景中,核心顺序通常是:开始事务 → 处理输入 → 发送输出 → 将消费位点加入事务 → 提交事务。这里的消费位点不是普通的独立提交,而是绑定到当前事务。
片段示例:下面代码依赖已有的 consumer、producer 和本次 poll 已处理记录对应的 offsets,用于说明位点加入事务的关键调用。不要在这条事务流程中再调用 consumer.commitSync(),否则就把位点提前提交到了事务边界之外。
producer.beginTransaction();

producer.send(new ProducerRecord<>("output", "<KEY>", "<VALUE>"));

// 将本次 poll 已处理记录的位点绑定到当前事务,而不是独立提交。
producer.sendOffsetsToTransaction(
        offsets,
        consumer.groupMetadata()
);

producer.commitTransaction();
预期结果
正确的事务式处理应让输出消息与消费位点处于同一个事务提交边界;事务提交成功后,两者一起生效,事务中止时则不会作为本次成功处理结果提交。提交失败时怎么处理
commitTransaction() 不是一个可以无条件忽略错误的普通结束调用。提交阶段可能因为事务超时、协调器异常或其他不可恢复错误失败。业务代码应根据 Kafka 客户端抛出的异常类型决定是否可以重试整次事务、终止当前事务会话或进入人工处理路径,而不是简单地再次发送同一批业务消息。
事务代码最重要的边界是:一个业务事务只定义一次原子结果。不要在同一个事务对象里混入跨事务的无关发送,也不要在提交成功之后继续尝试用 abortTransaction() “补救”。
正确理解这条生命周期后,事务配置就不再只是几个 Producer 参数,而是一套明确的执行协议:初始化身份、建立事务边界、写入结果、绑定位点、最终提交或中止。业务代码围绕这个协议设计,才能真正获得 Kafka 内部一致的事务语义。