
消息队列 / 系统课时
演练 Broker 故障与网络抖动
演练 Broker 故障与网络抖动
本篇通过可控故障验证 Kafka 生产者在 Broker 不可用、副本不足和网络抖动下的确认、重试与超时行为,重点记录故障前后指标、日志和最终发送结果,确认系统能否按边界降级并恢复。
学习目标
- 能设计 Broker 不可用、副本不足和网络抖动三类故障场景
- 能根据
acks、重试和交付超时解释不同发送结果 - 能建立故障注入、观察、恢复和验收的最小演练闭环
先定义演练的成功条件
一次可靠性演练至少需要明确四个时间点:故障注入、错误开始出现、故障解除、发送恢复。演练前记录 Producer 的发送成功率、请求延迟、重试和 buffer wait,并记录目标 topic 的分区与副本状态。
验收标准不要只写“程序没有崩溃”。更有价值的标准是:可重试故障能够在交付超时前恢复并成功发送;不可满足确认条件时客户端能够明确失败;故障解除后重试流量能够下降,正常发送恢复且没有形成持续积压。
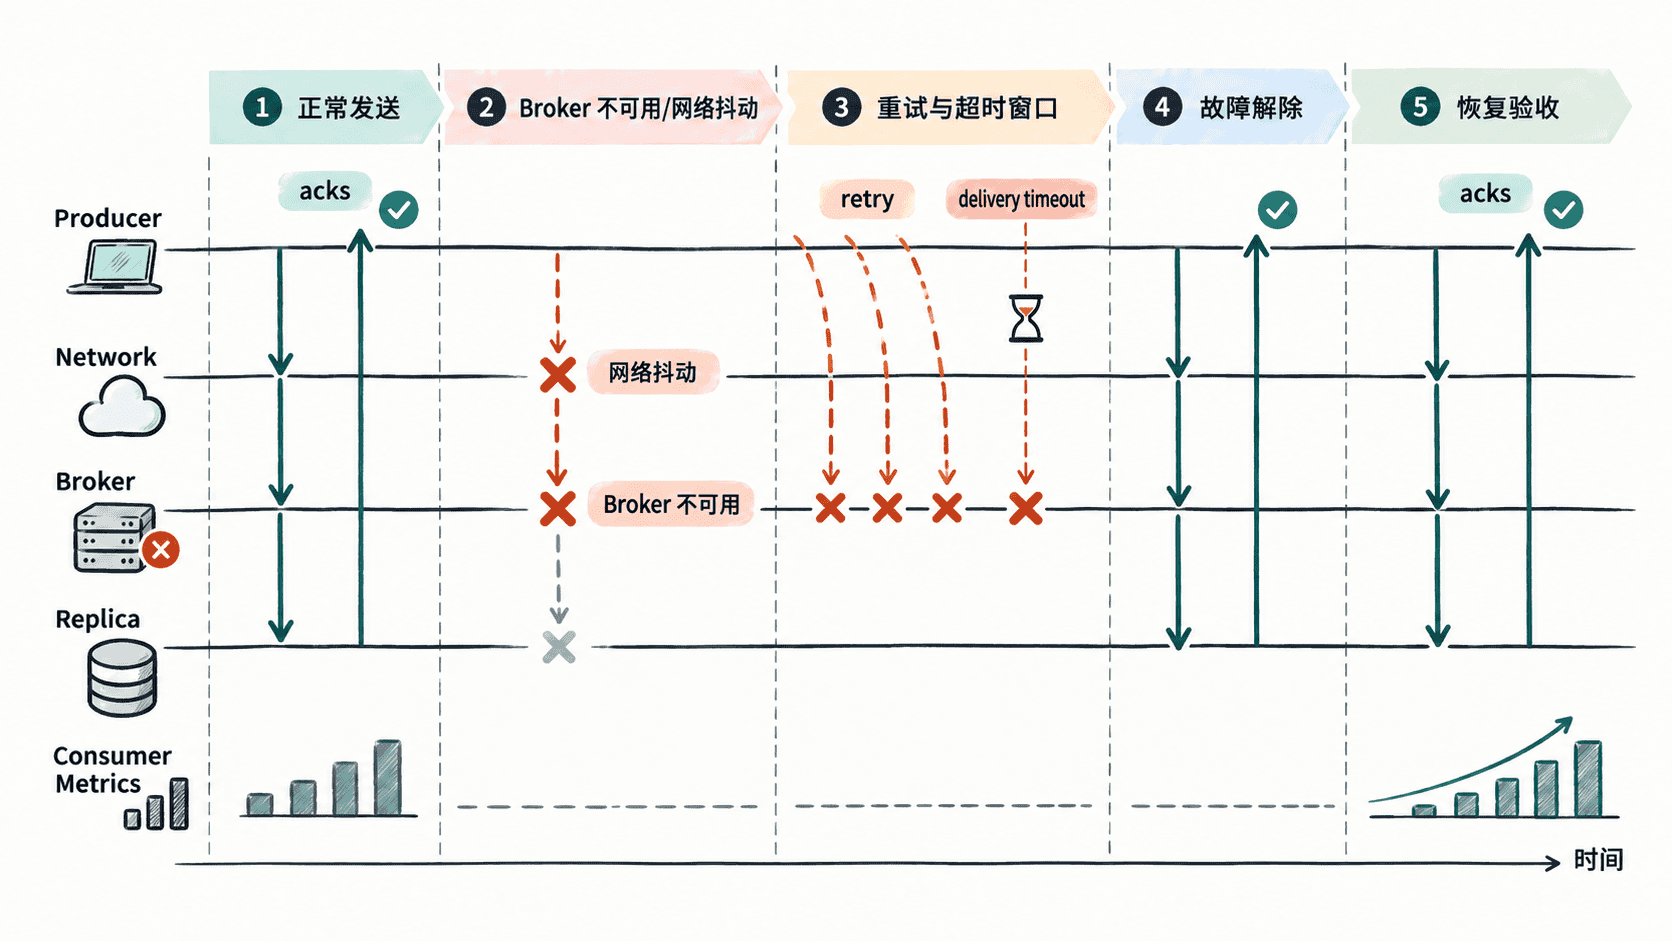
演练 Broker 不可用
最小场景可以针对测试环境中的一个 Broker 注入不可用状态,同时让 Producer 持续发送。注入后观察客户端是否进入重试,以及最终结果是恢复成功还是因超过交付时间而失败。
主示例使用 Kafka Java 客户端创建一个完整的 Producer,并向测试环境中的 orders topic 发送一条消息。故障注入本身由测试环境完成,不在应用代码中模拟。运行前只需将 <HOST>、<PORT> 替换为可访问的 Kafka 地址,并确保项目已引入 Kafka Clients 依赖。
import java.util.Properties;

import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;

public class ProducerFailureDrill {
    public static void main(String[] args) throws Exception {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<HOST>:<PORT>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.ACKS_CONFIG, "all");
        props.put(ProducerConfig.RETRIES_CONFIG, 20);
        props.put(ProducerConfig.DELIVERY_TIMEOUT_MS_CONFIG, 60000);
        props.put(ProducerConfig.REQUEST_TIMEOUT_MS_CONFIG, 10000);

        // Producer 负责按 delivery.timeout.ms 的边界重试,故障由测试环境注入。
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            ProducerRecord<String, String> record =
                    new ProducerRecord<>("orders", "order-<ID>", "created");

            producer.send(record, (metadata, exception) -> {
                if (exception != null) {
                    System.err.printf("send failed type=%s message=%s%n",
                            exception.getClass().getSimpleName(), exception.getMessage());
                    return;
                }
                System.out.printf("send ok partition=%d offset=%d%n",
                        metadata.partition(), metadata.offset());
            });
            producer.flush();
        }
    }
}
预期结果
恢复成功:send ok partition=<PARTITION> offset=<OFFSET>
持续故障:send failed type=<EXCEPTION_TYPE> message=<ERROR_MESSAGE>
其中 <HOST>、<PORT>、<ID>、<PARTITION>、<OFFSET> 等实际值会随测试环境变化。这里最关键的关系是:request.timeout.ms 描述一次请求等待响应的边界,而 delivery.timeout.ms 约束一条消息从发送开始到最终交付失败的总时间。调大单次请求超时并不等于允许无限重试。
演练副本不足与确认失败
副本不足时,故障重点从“Broker 是否在线”转向“当前分区是否仍满足确认条件”。当生产者使用 acks=all 时,客户端等待的是由 ISR 条件决定的确认;如果副本状态无法满足要求,发送可能进入等待、重试或最终失败。
演练时记录目标 partition 的 leader、ISR 和副本数量,并在同一时间窗口观察 Producer 日志。不要把“没有立刻报错”理解为“消息已经可靠写入”,因为确认条件可能仍未满足。
演练网络抖动并观察重试边界
网络抖动适合用短时阻断、丢包或增加延迟来模拟。演练目标是观察“偶发请求失败”和“持续无法交付”之间的差异。前者通常能够通过重试恢复,后者最终会触及交付超时并暴露真实失败。
故障注入应由测试环境的网络工具或基础设施完成,应用侧重点是持续记录异常类型、重试行为和最终发送结果。不要把短暂网络异常与永久不可达混为一谈,应结合异常持续时间和 delivery.timeout.ms 判断最终结果。
故障解除后的验收
恢复阶段至少检查三件事。第一,Producer 错误率和重试率应回落;第二,请求延迟和 buffer wait 不应持续异常;第三,业务侧应确认目标 topic 没有形成持续增长的生产者积压或消费者 lag。
最终演练报告应记录故障类型、注入方法、开始时间、解除时间、最大延迟、最高错误率、最终恢复时间和未恢复风险。真正可靠的生产者不是“永远不报错”,而是在 Broker 或网络暂时异常时能够按边界重试,在无法可靠交付时明确失败,并在故障解除后恢复正常吞吐。