
消息队列 / 系统课时
什么时候仍可能出现丢失
什么时候仍可能出现丢失
本课解决一个常见误区:即使使用 acks=all,消息也不能被简单理解为“绝对不丢”。判断风险时,要同时检查 Broker 副本确认、Producer 响应、失败重试,以及业务侧如何处理结果不确定和重复投递。
学习目标
- 能区分副本持久性、Producer 确认和业务最终成功语义
- 能识别
acks与min.insync.replicas的配置边界 - 能针对确认丢失场景选择安全的重试与幂等策略
先建立风险模型
消息是否最终可恢复,至少取决于三个环节:Broker 是否把数据复制到满足要求的 ISR 副本、Producer 是否收到成功确认、失败后是否能够安全重试。任何一个环节出现不确定状态,都可能出现“调用方认为失败,但消息实际上已经写入”的情况。
例如 acks=1 只等待 leader 确认。leader 写入本地日志后即可返回成功;如果此时发生故障,而新的 leader 没有这条记录,就存在 Producer 已成功、后续却无法从当前副本读到消息的风险。因此,可靠性不能只看请求是否成功,还要看副本确认策略。
哪些配置组合风险最高
acks=0 不等待 Broker 确认,Producer 无法根据发送结果判断 Broker 是否真正接收;acks=1 只确认 leader,在 follower 尚未追上的时间窗口内仍存在故障风险。
即使使用 acks=all,如果 Topic 的 min.insync.replicas=1,当 ISR 只剩 leader 时仍可能接受写入,这会削弱多副本配置原本提供的保护。这里必须区分配置边界:acks 是 Producer 端参数,min.insync.replicas 是 Broker/Topic 侧配置,两者需要协同设置。
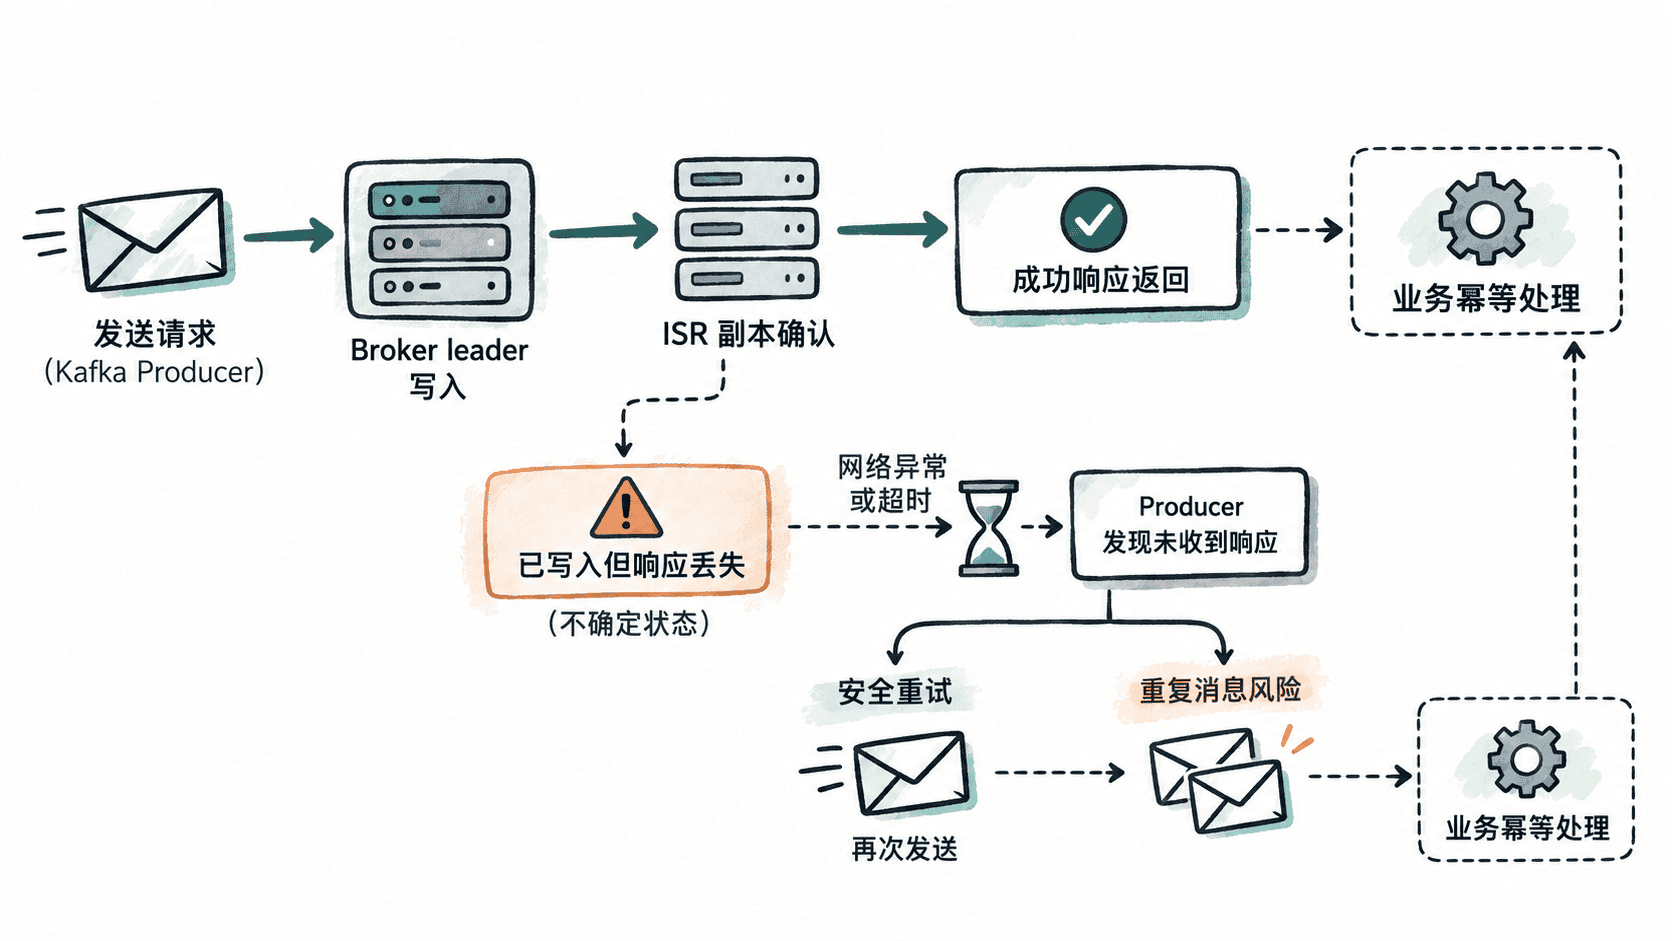
确认丢失也是另一类关键风险。Broker 可能已经成功写入,但响应在返回途中丢失,Producer 最终只能看到超时或网络异常。此时重试可能产生重复消息;把“没有收到响应”直接理解成“消息一定没有写入”同样是不安全的。
区分 Producer 与 Topic 侧配置
Producer 侧可以这样建立可靠性基线:
# 只有满足 Broker 的确认条件后才认为发送成功
acks=all

# Producer 自动重试时保持幂等语义,降低重复写入风险
enable.idempotence=true
预期结果:
Producer 使用 acks=all,并启用幂等发送;min.insync.replicas 不出现在这份 Producer 配置中。目标 Topic 则需要在 Broker/Topic 侧设置合理的 min.insync.replicas。例如三副本 Topic 可以根据故障容忍目标设置为 2:当可用 ISR 少于该门槛时,使用 acks=all 的写入会被拒绝,而不是继续接受风险更高的单副本写入。
怎样验证发送边界
可以用 Kafka Console Producer 验证 Producer 侧参数是否正确传入:
kafka-console-producer.sh --bootstrap-server <HOST>:<PORT> --topic <TOPIC> --producer-property acks=all --producer-property enable.idempotence=true预期结果:
终端进入消息输入状态;输入消息后客户端继续等待下一条输入。实际启动日志可能因 Kafka 版本和日志配置不同而变化。这只能证明客户端按指定参数启动并进入发送流程,不能单凭启动成功证明 Topic 的 ISR 已满足 min.insync.replicas,也不能证明所有故障场景下都不会丢失。
怎样处理确认不确定状态
acks=all 解决的是 Producer 对 Broker 成功确认的要求;min.insync.replicas 约束的是接受写入时的最小 ISR 门槛。两者都不等于端到端业务成功。
当 Producer 发送后没有拿到成功响应时,系统实际上可能处于两种状态:消息已写入但响应丢失,或消息确实没有完成写入。可靠系统不能靠网络错误直接判断其中哪一种成立,而应允许安全重试,并通过幂等 Producer 或业务幂等键消除重复影响。
因此,判断“消息是否可能丢失”时,应沿着“写入前提 → ISR 副本状态 → Broker 确认 → 响应返回 → 失败重试 → 业务去重”逐段检查。可靠投递的核心不是寻找一个保证绝对不丢的单一参数,而是让每个不确定状态都存在可恢复路径。