
消息队列 / 系统课时
生产端会遇到哪些失败
生产端会遇到哪些失败
这一篇把生产者从“调用发送”到“收到 Broker 响应”的失败路径拆开,帮助你区分发送失败、连接中断、Broker 不可用、请求超时和响应丢失,并理解为什么客户端异常不一定等于消息没有写入。
学习目标
- 能按故障发生位置区分常见生产端失败
- 能判断为什么“出现异常”不能直接证明消息没有写入
- 能根据失败类型选择重试、告警或人工核验方向
从发送调用到最终结果
生产者的一次发送可以理解为“准备记录 → 发起请求 → Broker 处理 → 返回响应”的链路。失败可能发生在发送前、网络传输中、Broker 处理时,也可能发生在响应返回途中,因此“客户端报错”不一定等价于“Broker 没收到消息”。
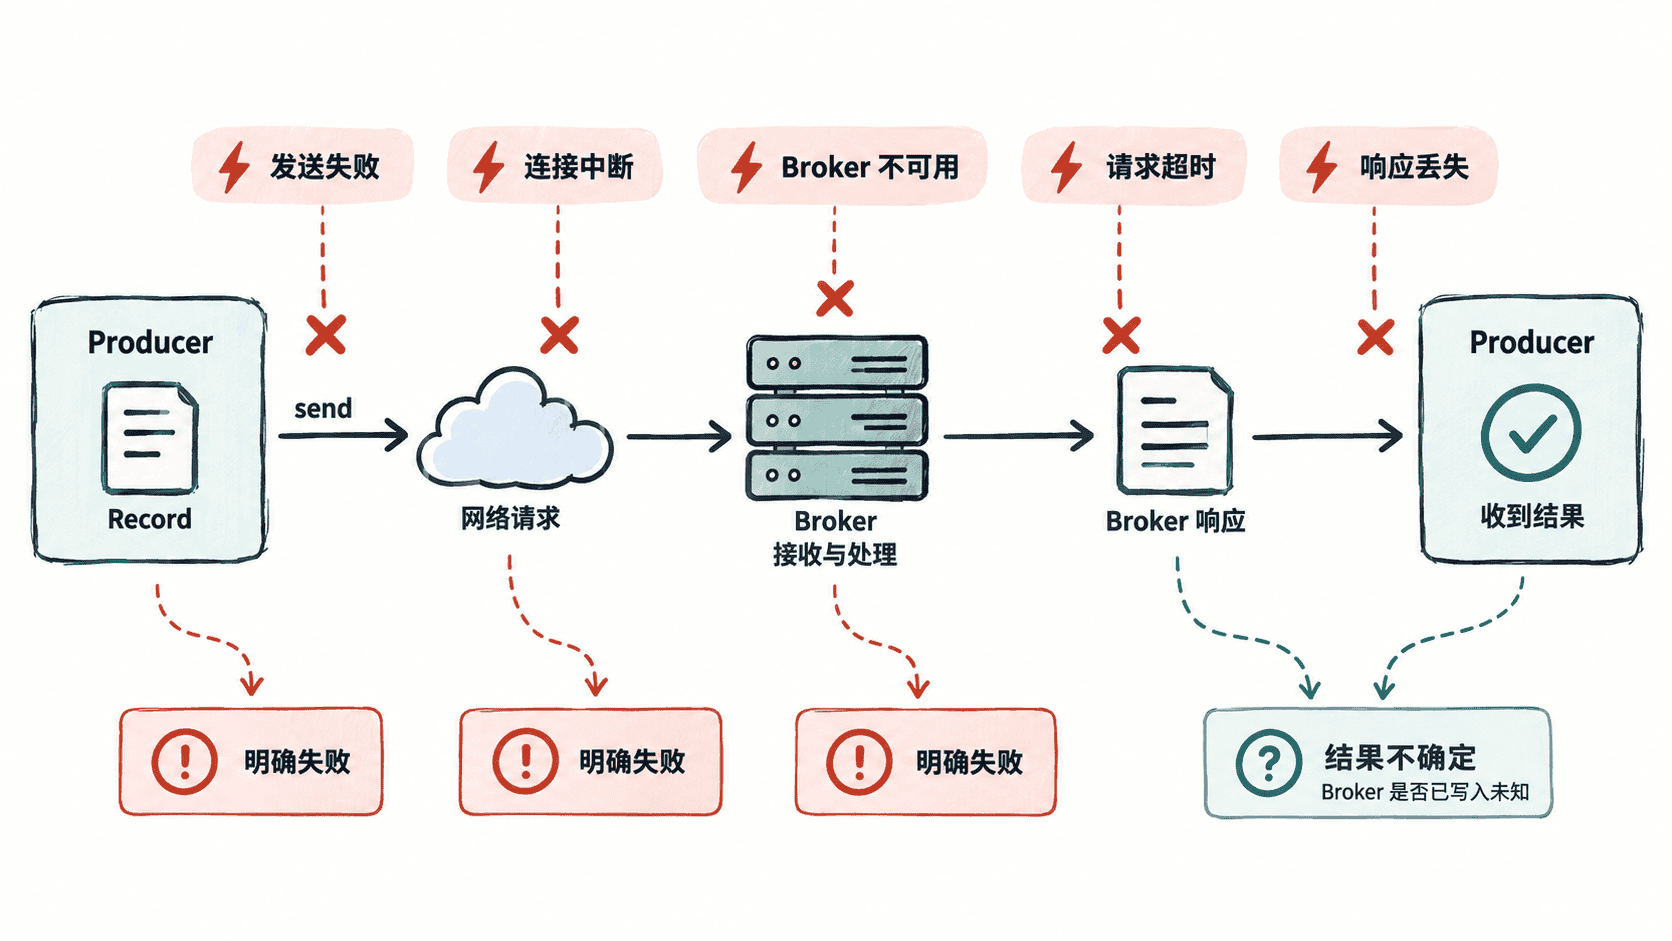
最重要的区别是结果确定性。例如参数校验失败通常可以判断消息尚未进入正常请求链路;而请求超时只能说明客户端在规定时间内没有拿到结果,不能仅凭异常判断 Broker 是否已经完成处理。
常见失败类型
发送失败通常发生在客户端准备请求或发送请求的早期阶段,例如消息序列化失败、参数错误或本地资源异常。这类错误通常可以较明确地判断本次发送没有进入正常的 Broker 请求处理链路。
连接中断发生在 Producer 与 Broker 的连接建立或复用过程中。断连可能发生在请求发送前,也可能发生在请求已经发出后,因此需要结合客户端日志、请求状态和 Broker 端证据判断实际结果。
Broker 不可用通常表现为目标 Broker 无法提供正常请求服务,例如节点故障、网络不可达或服务暂时拒绝请求。Producer 可以重试,但是否有效取决于失败原因和集群状态。
请求超时表示客户端等待 Broker 响应超过允许时间。它回答的是“客户端等不到结果”,而不是“消息一定没有写入”。因此,对超时进行业务层补偿时,不能默认直接当成未发送。
响应丢失更容易被误判。Broker 可能已经处理成功,但响应在返回客户端前丢失或连接被关闭,此时客户端看到的是失败或异常,实际消息却可能已经存在。
用失败信息做第一层判断
遇到异常时,先回答三个问题:请求有没有真正发出?Broker 有没有机会处理?客户端有没有拿到最终结果? 这三个问题比单看异常名称更有价值。
下面是发送回调的片段示例,依赖已经创建好的 KafkaProducer 和 ProducerRecord。它只能代表客户端观察到的最终结果:成功通常意味着 Producer 收到了 Broker 的成功响应;失败则说明客户端观察到了异常,不能单独证明消息一定不存在。
producer.send(record, (metadata, exception) -> {
    if (exception == null) {
        System.out.println("send=success topic=" + metadata.topic()
                + " partition=" + metadata.partition()
                + " offset=" + metadata.offset());
    } else {
        // 失败只代表客户端未获得成功结果,不能直接判断消息是否已写入。
        System.out.println("send=failed type="
                + exception.getClass().getSimpleName());
    }
});
预期结果
send=success topic=orders partition=2 offset=18427实际 topic、partition 和 offset 会随环境变化。这里真正需要关注的是:成功回调代表客户端拿到了 Broker 的成功响应,而失败回调还需要结合错误类型与服务端证据继续判断。
哪些失败不能直接重试
最容易出问题的是把所有异常都归为“发送失败”。对于结果明确的参数错误、序列化错误等问题,盲目重试通常没有价值;对于超时、连接中断、响应丢失等结果不确定的情况,重试才需要重点考虑幂等和重复发送风险。
因此,生产端故障处理的第一原则不是“看到异常就重试”,而是先区分明确失败与结果不确定。前者适合快速失败并修正原因,后者需要结合重试策略、幂等能力和后续校验一起设计。