
消息队列 / 系统课时
重试为什么会放大故障
重试为什么会放大故障
这一课解决“重试越多越可靠”这个常见误区。网络抖动或 Broker 过载时,失败请求本已占用资源,过度重试又会制造更多请求、等待与在途工作,从而拉高延迟,甚至把局部故障扩散成整体拥塞。
学习目标
- 理解 Kafka Producer 重试导致资源放大的因果链
- 能区分重试带来的可靠性收益与拥塞成本
- 会用时间窗口、重试指标和发送速率判断是否进入重试风暴
重试形成的放大链
一次正常发送只需要处理一份请求;发生网络抖动后,原请求可能已经占用了连接、发送缓冲区和 Broker 端处理资源。若客户端很快再次发送,新的重试请求会加入同一条拥塞路径。
当 Broker 本身过载时,处理速度下降会进一步拉长响应时间,更多请求因此超时,更多超时又触发重试。结果形成“过载→延迟升高→超时增加→重试增加→负载进一步升高”的反馈环。
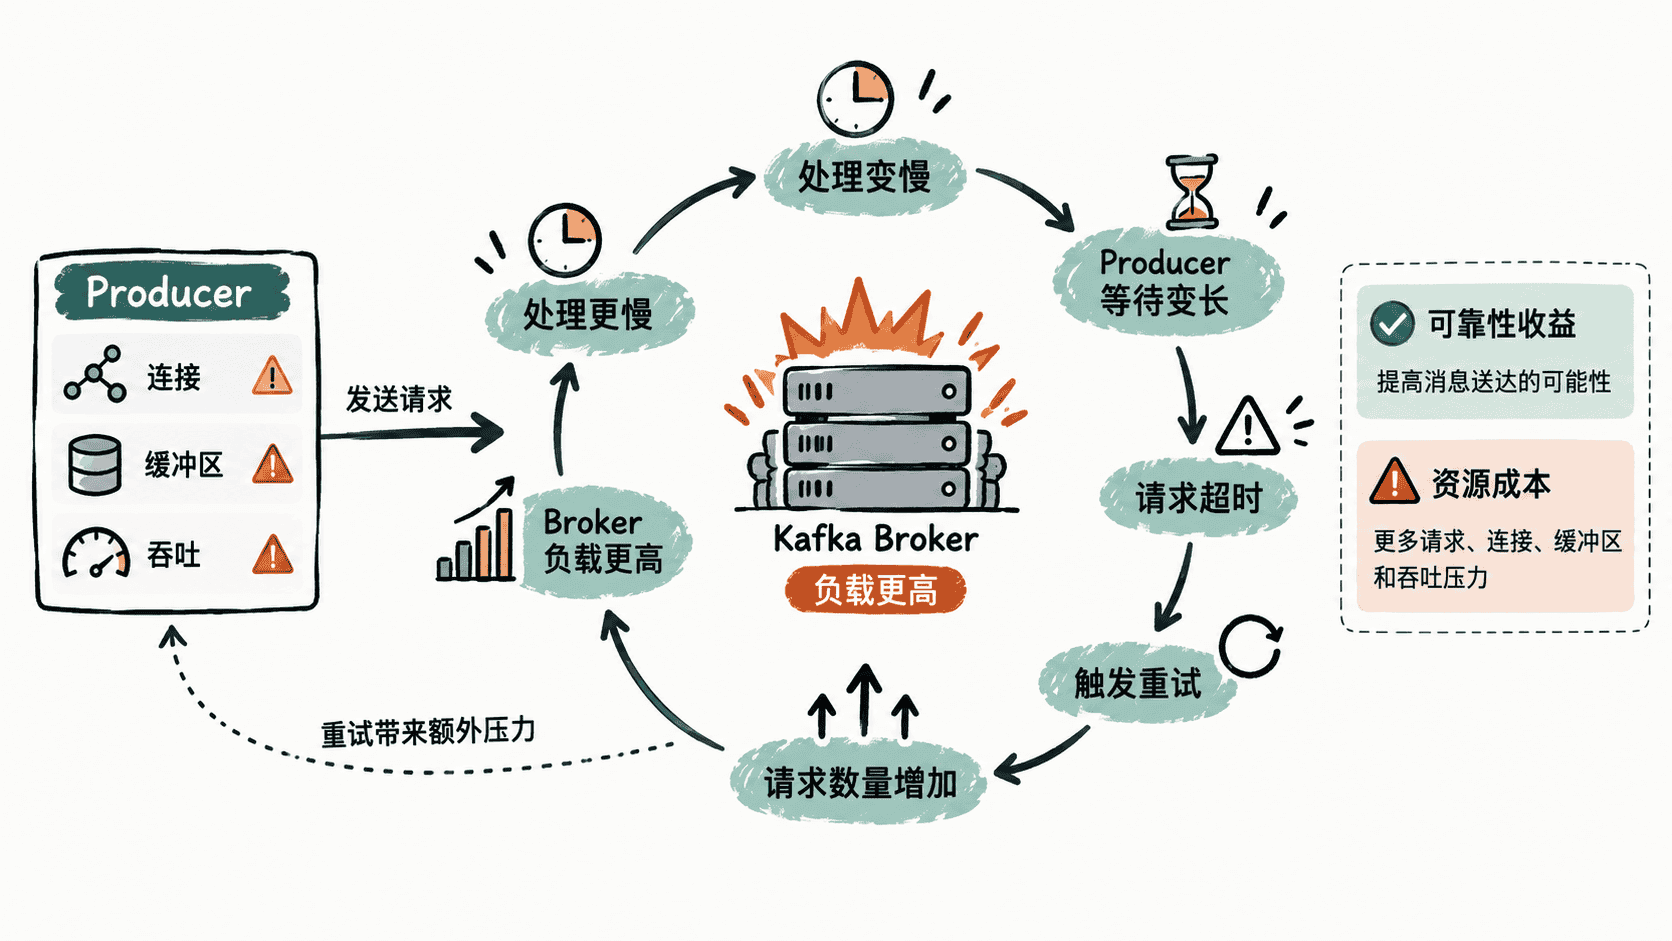
这个反馈环的关键不在“重试”本身,而在重试速度是否超过故障恢复速度。只要新增请求的速度持续高于 Broker 消化请求的能力,重试就会成为额外压力来源。
先看配置,再判断是否正在放大
Kafka Producer 的重试行为需要和请求超时、重试退避以及在途请求一起看。下面保留一组实验环境中的关键配置,重点观察重试间隔和请求等待窗口,而不是单独追求更大的重试次数。
# 片段示例:Kafka Producer 配置中的关键可靠性参数
acks=all
retries=10
retry.backoff.ms=200
request.timeout.ms=30000
enable.idempotence=true
预期结果
Producer 在请求失败后进入重试流程,并在重试之间等待 retry.backoff.ms。
启用幂等后,同一 Producer 会话中的重试不会简单等同于业务层重复写入。
实际重试持续时间还会受到请求超时、Broker 响应速度以及故障持续时间影响。
验证这组配置时,应同时观察 Producer 的 record-retry-rate、record-error-rate、request-latency-avg 和 bufferpool-wait-ratio 等指标,并把它们与发送速率放在同一时间窗口比较。不同监控系统的指标名称可能不同,但应至少能区分“重试增加”“请求变慢”和“缓冲等待增加”这三类信号。
这里不能只看 retries=10 就判断“最多产生 10 倍负载”。真实效果还取决于失败类型、同时在途请求数量、批量大小、压缩、连接状态和 Broker 当前吞吐能力。重试通常是对单个发送请求的再次尝试,而不是简单复制出同样数量的独立业务请求。
用指标和时间窗口识别重试放大
验证时不要只看最终错误率,应把 Producer 的重试速率、记录错误率、请求延迟与发送速率放在同一时间窗口比较。若重试速率持续上升,同时请求延迟升高、有效吞吐下降,说明失败请求正在占用越来越多资源。
实验可以固定业务发送速率,在正常状态下记录一分钟基线,再引入短暂网络抖动或降低 Broker 处理能力,连续观察故障窗口。重点比较“发送速率、重试速率、请求延迟、错误率、缓冲等待”五组信号,而不是只统计累计重试总数。
例如,可以把正常阶段和故障阶段按固定时间窗口采样,并重点确认重试速率是否先于或伴随延迟、错误率持续抬升。若故障解除后重试速率迅速回落、延迟恢复,则更符合短暂故障后的正常恢复;若三者同步恶化且吞吐下降,则更接近重试放大。
| 现象 | 更可能的含义 |
|---|---|
| 重试短暂升高后快速回落,延迟随后恢复 | 短暂故障,重试正在帮助恢复 |
| 重试持续升高,延迟和错误率同步升高 | 可能进入重试放大 |
| 发送速率不变,但在途工作持续堆积且吞吐下降 | Broker 或网络处理能力不足 |
| 缩短退避后重试更密集、延迟更高 | 重试节奏正在加剧拥塞 |
因此,判断“是否放大”至少要看一个完整故障窗口,而不是看到一次请求失败就立即下结论。
为什么延迟和缓冲等待会一起恶化
Producer 遇到持续超时时,请求在客户端侧停留更久,应用线程等待时间可能增加,发送缓冲区也更容易堆积。与此同时,Broker 处理变慢会延长请求生命周期,使同样数量的业务流量占用更多并发资源。
于是系统可能出现三个同时变化的信号:Producer 延迟上升、待发送或在途请求增加、有效吞吐下降。此时继续提高发送速率或缩短重试间隔,通常不是修复,而是在扩大积压。
如何治理重试放大
第一步是保留 Kafka 客户端提供的合理重试,不在业务代码里无条件做紧密循环重试。第二步是让重试具备退避,让瞬时故障有机会恢复;第三步是限制并发和发送压力,避免 Producer 在 Broker 已经拥塞时继续增加在途工作。
排查时应同时观察 Producer 的重试速率、错误率、请求延迟、发送缓冲与等待状态,以及 Broker 的请求处理延迟和资源利用率。若错误率和延迟同时升高,而重试速率也同步攀升,就要优先怀疑重试放大,而不是直接把问题归因于单个坏请求。
真正稳健的策略是让重试帮助系统跨过短暂故障,而不是承担持续故障期间的全部压力。短暂网络抖动适合自动恢复;持续过载则需要限流、降级或降低发送压力,否则“更努力地重试”反而会让恢复时间更长。