
消息队列 / 系统课时
定位发送失败与积压
定位发送失败与积压
本篇解决生产者发送错误率升高、延迟突增和消息积压难以判断根因的问题。你将按客户端指标、生产者日志、Broker 状态和积压位置逐层收敛,最终区分客户端拥塞、Broker 异常与下游消费不足。
学习目标
- 能从发送成功率、请求延迟、重试次数和缓冲区状态建立故障证据链
- 能结合生产者日志与 Broker 指标判断失败发生在哪一层
- 能区分生产者发送积压、Broker 端排队和消费者滞后
先判断积压发生在哪里
Kafka 中看到“积压”时,第一步不是立刻调大重试或批量,而是确认积压对象。生产者侧常见信号包括请求延迟、重试率、发送错误率以及 RecordAccumulator 缓冲区等待;Broker 侧更关注请求处理、网络线程和副本状态;消费者侧则用 consumer lag 判断消息是否已经进入主题但尚未被处理。
一条实用的定位顺序是:先确认生产者是否仍在持续产生请求,再确认请求是否成功写入 Broker,最后确认消费者是否跟得上。这样可以避免把消费者慢误判成生产者发送失败。
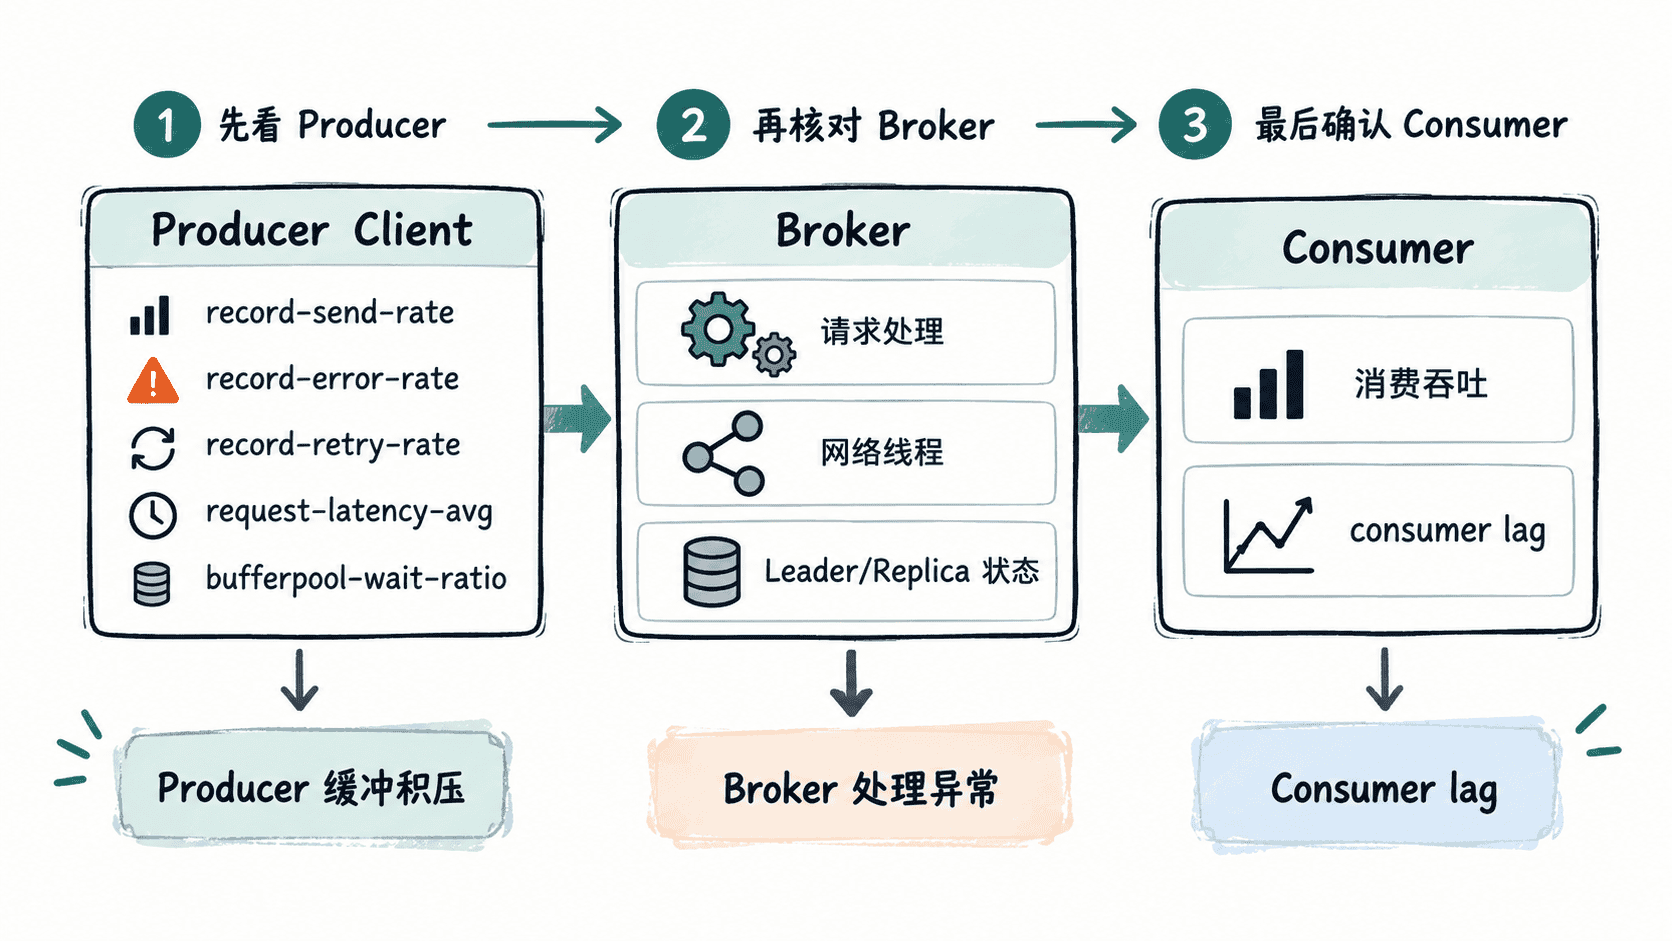
用客户端指标确认发送侧是否真的异常
先观察生产者的 record-send-rate、record-error-rate、record-retry-rate、request-latency-avg,以及 bufferpool-wait-time-total、bufferpool-wait-ratio 等指标。生产者默认会通过 JMX 暴露在 kafka.producer:type=producer-metrics,client-id=<ID> MBean 下,因此可以直接按客户端实例查看这些值。需要注意,bufferpool-wait-time-total 是累计等待时间,诊断时应结合采样窗口计算变化量,而不是把它当成瞬时值。
可以用 JMX 连接工具直接读取上述 MBean。下面示例假设 Kafka Producer 进程开启了远程 JMX,地址为 <HOST>:<PORT>,实际 JMX 地址应以部署配置为准。
$ java -jar jmxterm-<VERSION>.jar
$ open <HOST>:<PORT>
$ bean kafka.producer:type=producer-metrics,client-id=<ID>
$ get record-send-rate
$ get record-error-rate
$ get record-retry-rate
$ get request-latency-avg
$ get bufferpool-wait-ratio
预期结果
record-send-rate = <VALUE>
record-error-rate = <VALUE>
record-retry-rate = <VALUE>
request-latency-avg = <VALUE>
bufferpool-wait-ratio = <VALUE>
实际指标值会随流量和故障状态变化;重点是比较同一客户端在连续采样窗口中的变化,而不是只看某一个绝对值。
若错误率升高同时请求延迟和重试率增加,通常说明请求已经发出但无法稳定完成;若发送速率下降、bufferpool-wait-ratio 长时间升高,则更像生产端缓冲区无法及时获得可用空间,背后应继续检查 Broker 处理速度、网络或发送吞吐。
下面用 Java Producer 建立一个可复现的观察例子。配置本身不是“修复参数”,而是让发送行为稳定、便于与 JMX 指标和日志时间窗口对应。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;

import java.util.Properties;

public class ProducerProbe {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<HOST>:<PORT>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.ACKS_CONFIG, "all");
        props.put(ProducerConfig.RETRIES_CONFIG, "10");
        props.put(ProducerConfig.DELIVERY_TIMEOUT_MS_CONFIG, "120000");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.send(new ProducerRecord<>("orders", "order-<ID>", "created"), (metadata, exception) -> {
                // 回调结果与同一时间窗口的 Producer JMX 指标一起判断,避免只看单条消息。
                if (exception != null) {
                    System.err.println("send failed: " + exception.getClass().getSimpleName());
                    return;
                }
                System.out.printf("send ok topic=%s partition=%d offset=%d%n",
                        metadata.topic(), metadata.partition(), metadata.offset());
            });
            producer.flush();
        }
    }
}
预期结果
send ok topic=orders partition=<PARTITION> offset=<OFFSET>实际分区与 offset 会随集群状态和已有消息数量变化。若回调出现 TimeoutException、NotEnoughReplicasException 或其他发送异常,应同时查看 record-error-rate、record-retry-rate 和 request-latency-avg;只有把异常类型与指标变化对应起来,才能进一步判断请求超时、副本条件不满足还是其他错误。
用日志和 Broker 状态确认失败类型
日志定位时不要只看异常名称,要看异常发生的时间、topic、partition、请求是否重试以及最终是否超过 delivery.timeout.ms。同一个业务错误可能先出现多次可重试异常,最后才表现为一次发送失败;只看最后一行容易误判根因。
Broker 侧重点检查目标分区是否存在副本异常、leader 是否频繁变化,以及请求处理是否明显变慢。尤其要区分“Broker 拒绝了请求”和“Broker 已经写入,但客户端等待确认超时”,两者后续动作完全不同。前者应沿 Broker 错误与副本状态继续排查,后者则要结合请求延迟、重试以及网络状况判断确认链路是否受阻。
常见判断可以概括为:客户端失败伴随大量重试,优先查网络、Broker 可用性和副本状态;客户端缓冲持续上涨但错误不明显,优先查请求处理延迟与发送速率;Broker 正常而 consumer lag 持续上升,则不要继续扩大生产端重试,而应转向消费侧吞吐。
用时间窗口把三类积压区分开
可以固定一个 <TIME> 时间窗口,同时记录 Producer、Broker 和 Consumer 三组指标。核心不是寻找单个“万能指标”,而是观察它们的先后关系:Producer 侧看发送速率、错误率、重试率、请求延迟和缓冲等待;Broker 侧看目标分区、副本状态及请求处理;Consumer 侧看 consumer lag。
若 Producer 错误率和请求延迟先升高,随后发送速率下降,说明发送链路先出问题;若 Producer 正常发送而 consumer lag 上升,说明消息已经稳定进入 Kafka,积压属于消费侧;若 Broker 副本状态异常与 Producer 错误同步出现,则需要优先处理集群可用性,而不是继续修改客户端发送参数。
排查完成后的结论应该能够回答三个问题:消息是否到达 Broker、发送失败发生在哪个时间窗口、积压当前位于 Producer、Broker 还是 Consumer。 只有这三个答案明确后,才适合进入下一步的参数调整或故障恢复。