
消息队列 / 系统课时
超时后为什么不确定
超时后为什么不确定
这一课解决一个容易被误判的问题:Producer 超时并不等于 Kafka 一定没有收到消息。通过区分请求发送、Broker 处理、响应返回和客户端计时器,可以正确判断未知结果,并设计后续处理。
学习目标
- 理解客户端超时与 Broker 实际处理结果为什么可能不一致
- 能区分“明确失败”和“结果未知”两种状态
- 掌握超时后的重试、幂等与业务去重思路
超时并不等于消息未写入
Producer 发送一次消息后,至少存在几个彼此独立的阶段:客户端发出请求、网络传输、Broker 接收并处理、Broker 返回响应、客户端收到响应。超时只说明客户端在规定时间内没有拿到可用响应,并不能单独证明前面的写入没有发生。
例如,Broker 已经把消息追加到日志,但响应在返回途中遇到网络抖动。此时客户端看到的是 timeout,Broker 看到的却可能是一次已经成功处理的 Produce 请求。
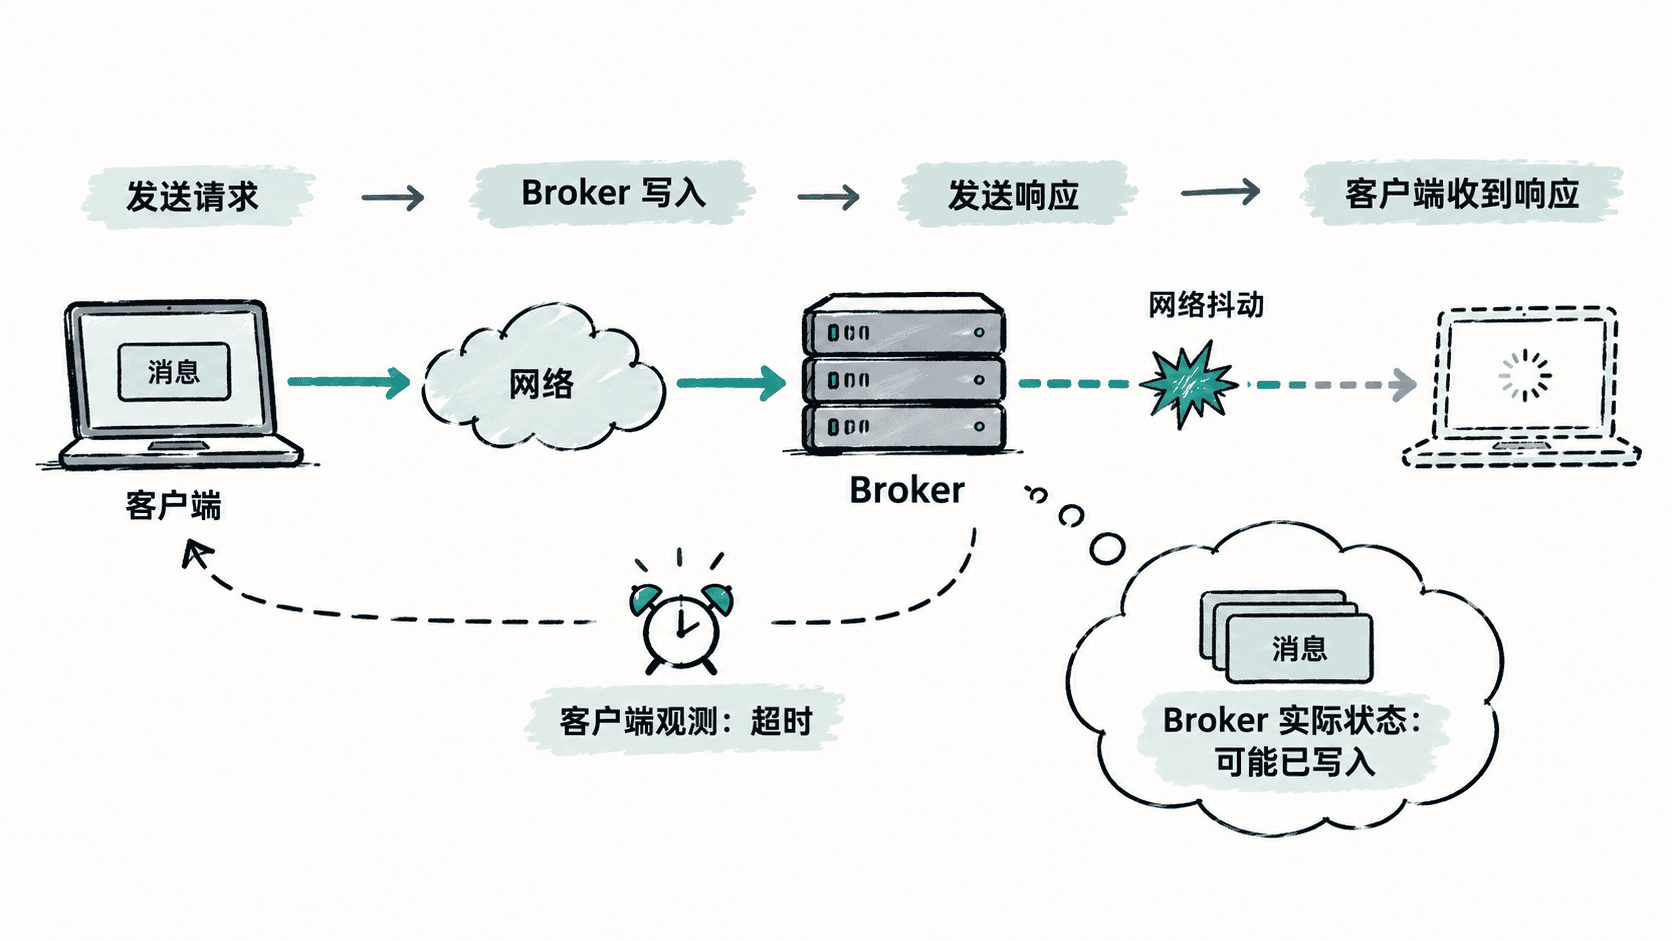
因此,超时后的状态最好理解成三类,而不是简单二选一:成功、明确失败、结果未知。明确失败通常意味着客户端获得了足够证据,确认本次请求没有完成;结果未知则表示客户端缺少足够证据判断 Broker 是否已经处理。
用客户端日志判断哪一种状态
排查超时不能只看异常名称,要同时观察发送时间、请求类型、topic、partition、异常类型以及后续重试行为。下面的完整示例使用 KafkaProducer.send() 返回的 Future 主动等待响应,用于说明客户端等待窗口结束时可能出现的未知结果。运行前需要项目已添加 Kafka Client 依赖,并把连接地址替换为实际值。
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.clients.producer.RecordMetadata;

import java.util.Properties;
import java.util.concurrent.ExecutionException;
import java.util.concurrent.Future;
import java.util.concurrent.TimeUnit;
import java.util.concurrent.TimeoutException;

public class ProducerTimeoutExample {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<BOOTSTRAP_SERVERS>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        props.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");

        String topic = "<TOPIC>";
        ProducerRecord<String, String> record =
                new ProducerRecord<>(topic, "order-<ID>", "created");

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            // get() 的超时只限制调用方等待多久,不代表 Broker 一定未处理请求。
            Future<RecordMetadata> future = producer.send(record);

            try {
                RecordMetadata metadata = future.get(500, TimeUnit.MILLISECONDS);
                System.out.println("send success: "
                        + metadata.topic() + "-" + metadata.partition());
            } catch (TimeoutException e) {
                System.out.println("send result unknown: client wait timed out");
            } catch (ExecutionException e) {
                System.out.println("send failed: "
                        + e.getCause().getClass().getSimpleName());
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                System.out.println("send interrupted");
            }
        }
    }
}
预期结果
正常收到响应:send success: <TOPIC>-<PARTITION>
客户端等待超时:send result unknown: client wait timed out
明确失败:send failed: <EXCEPTION_TYPE>
线程被中断:send interrupted这里最重要的不是异常名,而是状态语义:TimeoutException 代表调用方等待窗口结束;它不能单独作为“消息一定不存在”的证据。若业务把 timeout 直接当成失败并立即再次发送,就可能制造重复消息。
为什么网络抖动最容易制造未知结果
网络抖动可能发生在多个位置。请求已经到达 Broker 时,客户端可能还没收到响应;Broker 已经完成写入时,响应也可能在返回路径丢失;连接重建时,客户端更难仅靠本地状态判断上一请求究竟执行到哪里。
所以“发送超时”与“消息状态未知”之间存在明显关系:超时是观测结果,未知状态是业务结论。前者由客户端等待计时器产生,后者来自对整条请求链路缺乏最终证据。
超时后的正确处理
首先确认 Producer 是否启用了幂等能力,并让 Kafka 客户端负责合理的重试;不要在业务层因为一次 timeout 就无条件创建第二条相同消息。其次,关键业务应设计可去重的业务键,让重复投递即使发生,也不会造成两次业务效果。
对于需要确认结果的场景,还应结合 Producer callback、客户端日志、Broker 指标以及消费端业务状态进行交叉验证。真正可靠的判断不是“有没有 timeout”,而是“能不能最终证明这条业务消息已经生效”。
当客户端无法证明成功或失败时,把它标记为“未知”比粗暴标记为“失败”更安全,因为它提醒后续处理保留幂等与去重空间,也避免把一次网络问题放大成两次业务写入。