
消息队列 / 系统课时
如何设计发送失败策略
如何设计发送失败策略
发送失败不是简单地“重试还是报错”,而是先判断业务能否同步等待、是否允许异步处理、失败是否必须留痕,以及最终是否需要业务补偿。本篇给出一套可落地的选择路径,并用 Java 示例验证失败处理。
学习目标
- 能根据业务一致性与时延要求选择发送失败策略
- 能区分同步等待、异步回调、失败落库和业务补偿的职责
- 能为生产者失败处理补上可观测、可重试和可恢复的闭环
先判断失败意味着什么
发送失败至少包含两类情况:客户端明确知道发送未成功,以及客户端无法确定消息究竟有没有写入 Kafka。前者适合直接失败或重新处理;后者更危险,因为再次发送可能产生重复消息。
因此,策略设计不要只围绕异常类型,而要回答三个问题:消息是否可以丢、调用方是否需要立刻知道结果、失败后谁负责继续处理。这三个答案决定了处理边界。
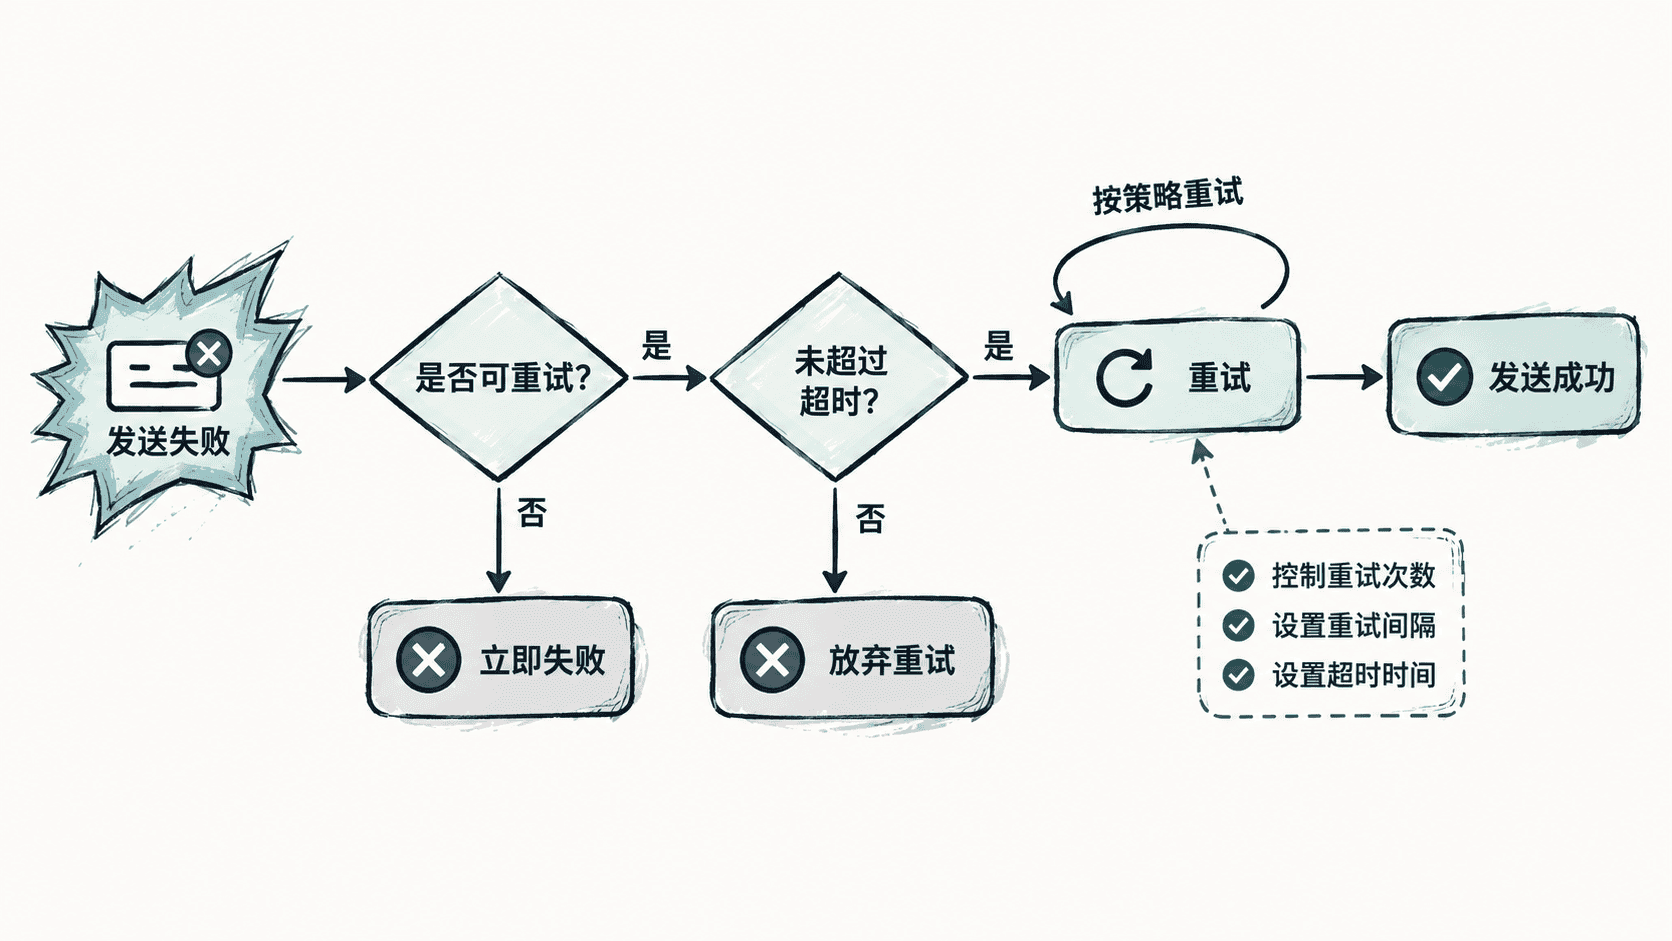
同步等待:结果必须立即决定
同步等待适合下单、扣库存、权限变更等“发送成功才能继续”的场景。调用线程等待 Kafka 返回成功或异常,再决定事务是否继续。它的优点是失败路径清晰,缺点是 Kafka 网络抖动会直接增加业务接口时延。
Java 中可以显式等待 Future 结果:
import java.util.Map;
import java.util.concurrent.TimeUnit;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;

public class SyncSendExample {
    public static void main(String[] args) {
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(Map.of(
                "bootstrap.servers", "<HOST>:<PORT>",
                "key.serializer", "org.apache.kafka.common.serialization.StringSerializer",
                "value.serializer", "org.apache.kafka.common.serialization.StringSerializer"
        ))) {
            ProducerRecord<String, String> record =
                    new ProducerRecord<>("orders", "<ID>", "created");
            try {
                producer.send(record).get(5, TimeUnit.SECONDS);
                System.out.println("SEND_OK");
            } catch (Exception e) {
                System.out.println("SEND_FAILED=" + e.getClass().getSimpleName());
            }
        }
    }
预期输出
SEND_OK实际发送失败时会进入 SEND_FAILED=... 分支;具体异常类型取决于超时、网络或 broker 返回结果。示例中的 <HOST>、<PORT>、<ID> 为实际部署值的占位符。
异步回调:业务线程不等待结果
异步回调适合日志、埋点、通知等对接口实时成功没有硬依赖的场景。发送方法立即返回,Kafka 在成功或失败后调用回调。关键不是“异步就更可靠”,而是失败后的动作必须明确,否则异常只是从同步调用点转移到了回调线程。
失败回调通常至少记录业务标识、topic、partition、key 和异常原因;对于允许重试的场景,还应交给统一重试机制,而不是在回调里无限递归发送。
失败落库:把不确定性变成可恢复数据
当消息不能直接丢失,但业务接口又不能长时间等待 Kafka 时,可以将待发送或发送失败信息写入本地持久化介质,再由后台任务重放。这类方案本质上是把“发送动作”和“失败恢复”解耦。
落库记录至少应包含业务唯一标识、消息内容或可重建消息所需的数据、状态、重试次数、最后失败时间和下一次重试时间。状态可以明确迁移,例如 PENDING → SENDING → FAILED → RETRYING → SENT。
业务补偿:失败后的正确性由业务兜底
业务补偿适合消息已经影响后续业务流程,但发送失败后需要继续推动状态收敛的场景。例如订单已创建而通知事件未投递,可以先记录订单状态,再由补偿任务按照业务规则重新生成事件。
四种策略可以这样取舍:
| 策略 | 典型场景 | 核心优点 | 主要风险 |
|---|---|---|---|
| 同步等待 | 发送成功才能继续 | 结果最直接 | 增加请求时延 |
| 异步回调 | 非关键通知、日志 | 降低业务线程等待 | 失败处理容易遗漏 |
| 失败落库 | 不允许直接丢消息 | 可重试、可审计 | 需要状态机与重放治理 |
| 业务补偿 | 消息对应业务状态变更 | 能推动最终收敛 | 实现复杂、需要幂等 |
真正可靠的方案通常不是四选一,而是组合:前台请求采用同步或异步发送,失败后进入持久化记录,再由重试任务和业务补偿共同完成恢复。
让失败处理形成闭环
上线前至少验证一次“发送成功”“明确失败”“结果不确定”三条路径,并分别确认日志、指标和恢复动作是否存在。尤其要避免只监控 Kafka 发送异常数量,却没有办法知道失败消息是否最终得到处理。
最终原则是:同步负责即时决策,回调负责快速反馈,落库负责保存失败事实,补偿负责推动业务最终收敛。当这四层职责清晰后,生产者失败策略才不会停留在简单的异常捕获上。