
消息队列 / 系统课时
批量与压缩如何影响可靠发送
批量与压缩如何影响可靠发送
本节把 batch.size、linger.ms 和 compression.type 放到同一条发送链路里理解。最终你能判断一次发送为什么变大、为什么会多等几毫秒、为什么压缩率会变化,以及这些变化如何影响吞吐、延迟和失败重试成本。
学习目标
- 理解
batch.size与linger.ms如何共同决定一个请求的批次形成过程。 - 理解压缩是按完整批次进行,以及为什么更好的批量通常能带来更好的压缩效果。
- 能在可靠发送场景下平衡吞吐、延迟、CPU 与重试带来的额外成本。
先把三项参数放回发送路径
batch.size 是按分区维护的批次容量上限;生产者会尽量把发往同一分区的记录组合进更少的请求。linger.ms 则允许生产者在批次尚未填满时短暂等待更多记录,以提高成批发送概率。Kafka 文档说明,批次达到 batch.size 后会立即发送,不会为了 linger.ms 继续等待。:contentReference[oaicite:4]{index=4}
compression.type 决定生产者使用的压缩方式,压缩针对完整批次执行,因此批量形成得越充分,通常越有利于压缩效率。Kafka 当前文档列出的生产者压缩类型包括 none、gzip、snappy、lz4 和 zstd。:contentReference[oaicite:5]{index=5}
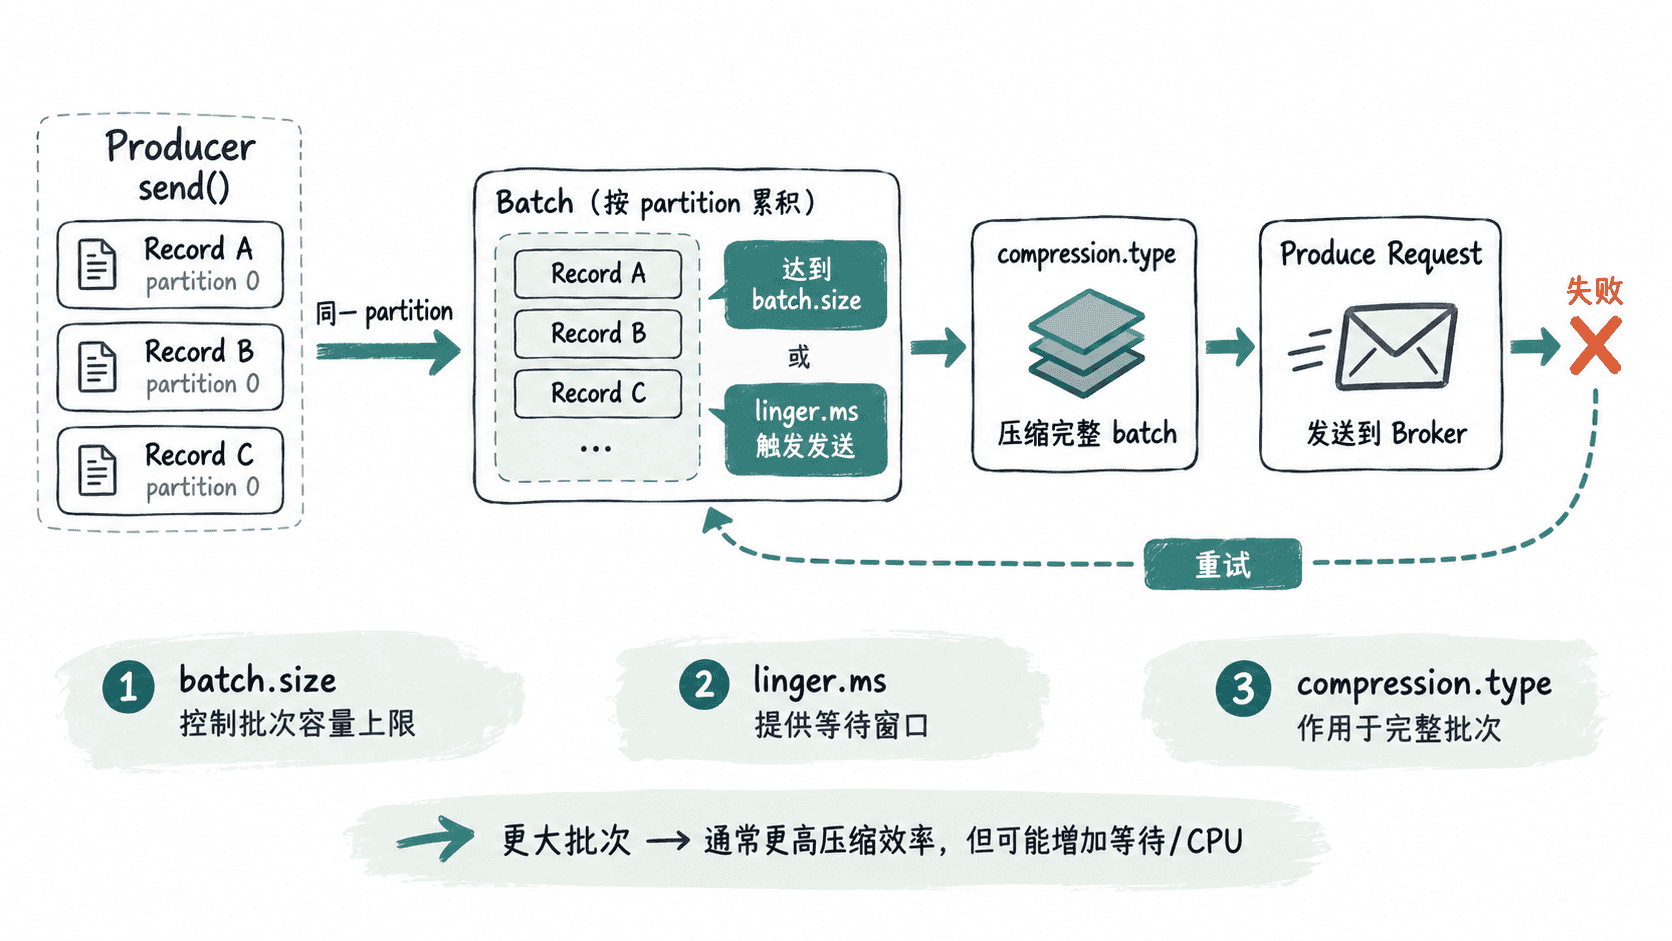
batch.size 和 linger.ms 怎么配合
可以把它们理解成两个不同的“发车条件”。batch.size 更像车厢容量,消息填满后立即发车;linger.ms 更像允许空车厢再等一小段时间,争取把随后到达的记录一起装上。这个等待时间是上界,而不是每条消息都会固定增加同样的延迟。:contentReference[oaicite:6]{index=6}
例如业务流量稳定、消息持续到达,同一个批次很可能很快达到容量上限,此时增大 linger.ms 的收益有限。低流量或突发流量下,适当的等待时间更容易形成有效批次,但代价是发送延迟增加。
一个可直接放入 Producer 的配置
下面示例采用中等大小的批次、短暂等待和 zstd 压缩。它只是一个起点,不代表所有业务的最佳值。
# 片段示例:KafkaProducer 配置
bootstrap.servers=<BROKER>
batch.size=32768
linger.ms=5
compression.type=zstd
acks=all
enable.idempotence=true
预期结果
发送到同一分区的记录会优先形成批次;批次达到 32768 字节时可立即发送,未达到时最多等待 5ms 以聚合更多记录。
形成的完整批次使用 zstd 压缩后发送;可靠发送仍由 acks=all 和幂等配置共同承担。
这里最容易误解的是“压缩等于只减少网络字节数”。压缩通常也会增加客户端 CPU 消耗,并可能影响发送端的处理时间;而批次大小变化又会改变压缩输入的组织方式。因此调优时要同时观察网络、CPU、吞吐和尾延迟,而不是只看压缩后字节数。
为什么可靠发送不能只看压缩率
失败重试时,客户端需要重新发送尚未成功完成的请求。批次越大,单次请求携带的数据越多,失败后的重试工作量也可能更大;但更大的批次又能减少请求数量,提高压缩效率和网络利用率。
因此可靠发送的目标不是“批次越大越安全”,而是找到一个能稳定形成有效批次、又不会明显推高单条消息延迟和资源峰值的区间。delivery.timeout.ms 还会限制记录从 send() 返回到最终成功或失败的总时间,因此重试、等待和请求超时必须一起评估。:contentReference[oaicite:7]{index=7}
什么时候该向哪个方向调
延迟优先:先降低 linger.ms,再检查 batch.size 是否过大。不要为了追求高压缩率让低流量请求长期等待。
吞吐优先:可以提高 batch.size,并给 linger.ms 一个小的聚合窗口,让更多记录进入同一批次;同时观察 Broker、客户端 CPU 与网络带宽是否出现新的瓶颈。
网络带宽紧张:开启压缩通常比单纯扩大批次更有效,但要选择合适的压缩算法,并验证 CPU 是否成为新的瓶颈。由于压缩针对完整批次执行,更好的批量形成通常有利于压缩效率。:contentReference[oaicite:8]{index=8}
真正上线前,至少用业务真实消息大小做一次对照测试:记录平均批次大小、压缩后请求字节数、发送吞吐和 p95/p99 延迟。只有这些指标同时满足目标,批量和压缩配置才算可靠,而不是“看起来合理”。