
消息队列 / 系统课时
为什么重试会产生重复
为什么重试会产生重复
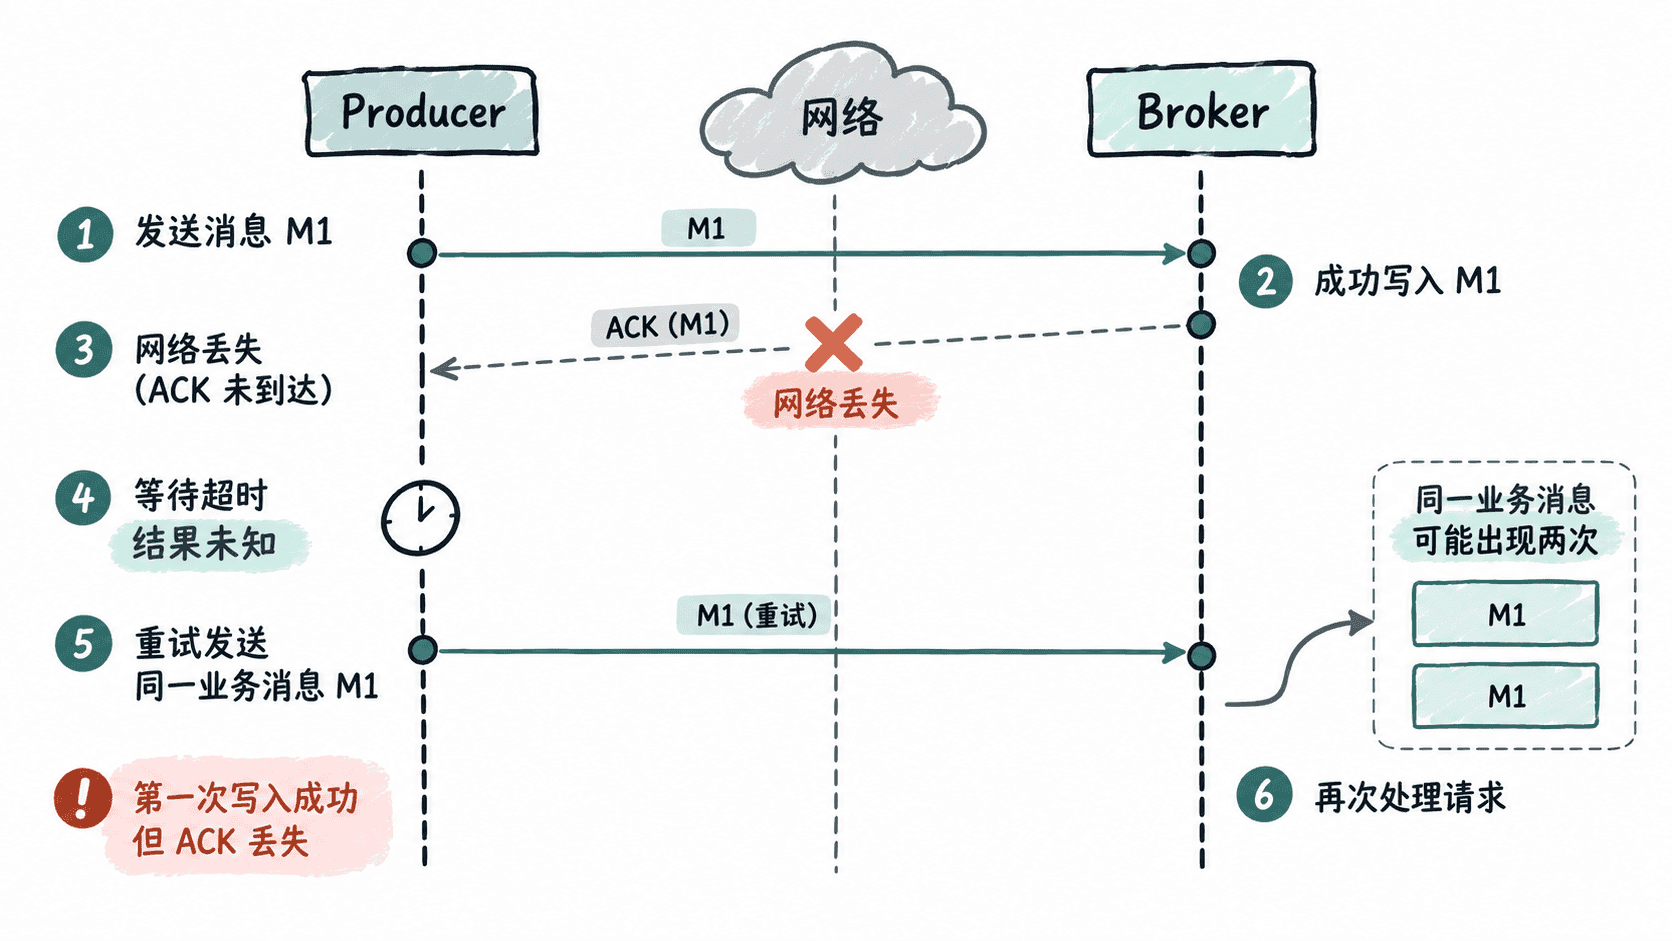
Kafka 生产者重试解决的是“发送失败后再次尝试”,但网络异常时客户端可能只知道“结果没回来”,并不知道 broker 是否已经写入。此时再次发送同一业务消息,就可能形成重复。本篇从一次典型的应答丢失场景拆解这个过程。
学习目标
- 能解释网络应答丢失为什么会造成重复发送
- 能区分“发送未成功”和“发送结果未知”两种失败
- 能判断重试策略与幂等、业务去重之间的关系
重复的根因是结果不确定
最容易误解的一点是:重复并不一定来自 broker 把一条消息写了两次,也可能来自客户端无法确认第一次到底发生了什么。
例如生产者发送消息后,broker 已完成写入,但返回确认时网络中断。生产者收到的是超时或网络异常,于是按照重试策略再次发送。对生产者而言两次都是合理动作,但 broker 可能已经处理过第一次请求,因此最终可能出现两条消息。
用一次发送观察结果状态
下面的 Java 示例用于说明生产者如何接收异步发送结果。示例使用正确的 KafkaProducer 构造方式,不人为伪造 broker 行为,而是通过回调区分成功与异常;真实环境中的网络抖动可能让第一次请求的最终状态变得不可直接判断。运行前需要将 Kafka 客户端依赖加入项目,并将 bootstrap.servers 改为实际地址。
import java.util.Map;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.clients.producer.RecordMetadata;

public class RetryObservationExample {
    public static void main(String[] args) throws Exception {
        Map<String, Object> props = Map.of(
                "bootstrap.servers", "<HOST>:<PORT>",
                "key.serializer", "org.apache.kafka.common.serialization.StringSerializer",
                "value.serializer", "org.apache.kafka.common.serialization.StringSerializer",
                "acks", "all",
                "enable.idempotence", "true"
        );

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            ProducerRecord<String, String> record =
                    new ProducerRecord<>("orders", "<ID>", "created");

            producer.send(record, (RecordMetadata metadata, Exception exception) -> {
                if (exception == null) {
                    System.out.println("SEND_OK partition=" + metadata.partition());
                } else {
                    System.out.println("SEND_ERROR=" + exception.getClass().getSimpleName());
                }
            });

            // flush 让示例在退出前等待已提交的发送请求完成回调。
            producer.flush();
        }
    }
}
预期输出
SEND_OK partition=<PARTITION>正常情况下回调会报告成功;发生可见失败时会进入 SEND_ERROR=...。这里的 <HOST>、<PORT>、<ID> 和 <PARTITION> 都是实际环境中的动态值。示例开启了生产者幂等能力,用于保持可靠发送配置;它本身不是重现网络应答丢失的故障注入程序。
为什么一次“失败”不能直接推出“没写入”
生产者看到的异常通常来自发送链路上的某个阶段,而不是 broker 内部状态的完整快照。请求可能尚未到达 broker,也可能已经写入后才在响应链路上失败。
因此应把失败分为两类理解:明确失败和结果未知。明确失败意味着可以合理判断本次写入没有完成;结果未知则意味着不能排除第一次已经成功写入。
这也是为什么“失败后立即重发”可能产生重复。重试解决的是可恢复的通信失败,但它本身无法证明之前的消息一定不存在。
重试与幂等分别解决什么
重试解决的是暂时性失败后的再次尝试;幂等解决的是重复请求到达后,系统如何避免重复效果。两者不是替代关系。
启用生产者幂等能力后,Kafka 客户端会利用生产者身份和序列号等协议机制抑制同一生产者会话中的重复写入,但业务系统仍然应该保留业务唯一标识,因为消息仍可能被重复消费,业务操作也可能在 Kafka 之外重复执行。
因此不要把“开启幂等”理解为“业务完全不需要去重”。更准确的做法是:生产者侧减少协议层重复,消费者或业务侧保证最终业务效果可重复执行。
一个实际的判断方法
看到“发送失败后重复”现象时,先回答三个问题:第一次请求是否可能已成功写入,生产者是否自动重试,同一业务消息是否有稳定唯一标识。
若三者答案分别为“可能”“是”“没有”,风险最高,因为系统既无法判断第一次状态,又会自动再次发送,还没有业务层面的去重依据。补救时应优先建立唯一业务 ID,再根据要求评估生产者幂等与重试参数。
最终要记住:网络超时描述的是客户端没有及时拿到结果,不等于 broker 一定没有处理请求。 重试因此天然存在重复风险,而可靠投递的下一步就是让重复可识别、可抑制、可安全处理。