
消息队列 / 系统课时
事务超时会发生什么
事务超时会发生什么
这篇课时解决 Kafka 事务运行时间过长后的行为:什么时候被判定超时、transaction.timeout.ms 与 Broker 限制如何共同生效,以及事务失效后 Producer 应该如何恢复。
学习目标
- 理解
transaction.timeout.ms与 Brokertransaction.max.timeout.ms的关系 - 能识别事务超时后的提交失败与后续恢复路径
- 能根据业务处理耗时合理设置事务边界,而不是单纯把超时时间调大
两个超时约束共同决定上限
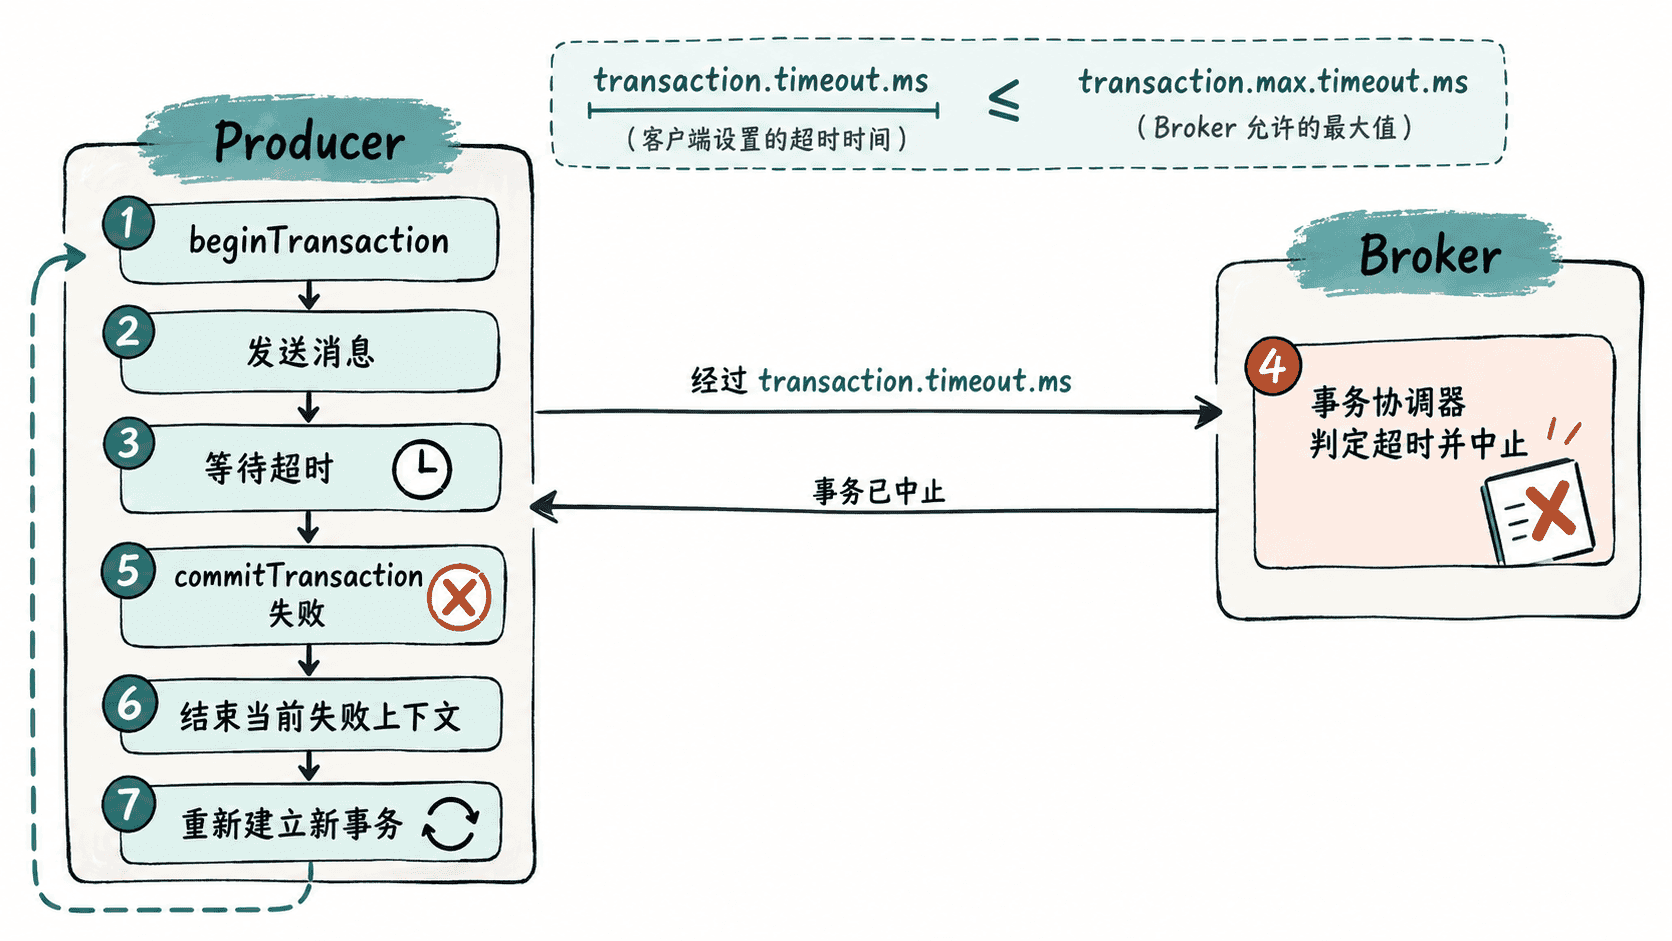
Producer 的 transaction.timeout.ms 表示客户端请求的事务超时时间。它不能无限增大,因为 Broker 会通过 transaction.max.timeout.ms 限制允许的最大值;如果 Producer 请求值超过 Broker 上限,相关请求会被拒绝。
因此配置思路不是“把 Producer 超时调到足够大”,而是先确定单次事务的真实工作窗口,再检查 Broker 是否允许这个窗口。事务持续时间应覆盖消息发送、处理和必要的重试,但不应把长时间的外部等待无限包进事务。
事务超时发生在哪里
事务超时的核心是 Broker 侧对事务生命周期进行约束。Producer 开启事务并开始涉及分区后,如果事务在允许窗口内没有完成,事务协调器可以主动中止正在进行的事务。此后继续对当前事务执行提交等操作,可能得到事务状态相关的错误。
常见原因并不只是 Kafka 网络慢。更常见的是业务处理时间过长,例如事务内部执行大批量数据库查询、等待远程 HTTP、长时间重试,或者一次事务积累了过多消息。这些操作都会拉长事务存活时间。
可以先检查 Broker 的事务最大超时配置:
kafka-configs.sh --bootstrap-server <HOST>:<PORT> --entity-type brokers --entity-default --describe --all | grep transaction.max.timeout.ms预期输出
transaction.max.timeout.ms=900000实际输出格式会随 Kafka 版本和脚本参数略有变化;关键是确认 Broker 当前允许的最大事务超时,而不是把示例中的数值直接当成你的环境值。
Producer 端如何设置
Producer 通过 transaction.timeout.ms 指定事务超时时间。下面是一个完整的 Java 示例,假设 Broker 的 transaction.max.timeout.ms 足够覆盖 120 秒,并且运行环境已经提供 kafka-clients 依赖。
import java.util.Properties;
import org.apache.kafka.clients.producer.KafkaProducer;

public class TransactionTimeoutConfigExample {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put("bootstrap.servers", "<HOST>:<PORT>");
        props.put("enable.idempotence", "true");
        props.put("transactional.id", "order-producer-01");
        props.put("transaction.timeout.ms", 120000);

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.initTransactions();
            System.out.println("initTransactions succeeded");
        }
    }
}
预期结果
initTransactions succeeded这里必须使用合法配置键 transaction.timeout.ms;它表示事务超时窗口,不能写成不存在的 transaction.time。如果 transaction.timeout.ms 超过 Broker 的 transaction.max.timeout.ms,事务相关请求会因超时配置无效而失败。设置值时还要注意,超时并不是越大越好:窗口过长会延迟失败后的恢复,也容易掩盖单批处理时间失控的问题。
超时后的恢复行为
一旦当前事务已经因为超时、异常或其他原因进入不可继续提交的状态,不要在同一个失败事务上继续追加业务结果。正确思路是停止当前处理,让失败事务结束并重新建立事务边界。
典型恢复逻辑是捕获 commitTransaction() 等事务操作抛出的异常,判断当前事务是否已经失效;如果已经失效,就结束当前处理上下文,再从新的事务开始。对于消费处理场景,还要确保 offset 提交仍与消息处理保持原子关系,不能在错误的时间单独提交 offset。
为什么优先缩短事务,而不是无限放大超时
如果一次事务必须等待数据库、远程服务或其他慢操作,真正的问题通常是事务边界过大。更稳妥的方法是把无关等待移出事务,把批次控制在稳定处理时间内,并用监控观察事务持续时长的 P95、P99。
例如一个正常批次通常只需 2 秒,却偶发因为远程依赖阻塞 90 秒,那么直接把事务超时从 30 秒调到 10 分钟,只是把异常隐藏得更久。更合理的治理顺序是确认最长允许处理时间、切断长外部等待、缩小单批规模,再决定是否需要调整超时配置。
线上排查时,先确认三个事实:当前事务已经运行多久、Broker 允许的最大事务超时是多少、处理逻辑中哪一步消耗了主要时间。只有这些事实清楚后,才决定是优化事务边界、调整批次,还是在可接受范围内提高超时值。
验证一次事务是否稳定
在测试环境中,可以让事务处理时间逐步接近超时阈值,观察正常提交与超时失败两条路径。验证重点不是记住某个具体错误文本,而是确认超时后当前事务不会继续被当作有效事务使用,并且下一轮能够建立新的事务。
最终应把事务超时视为事务生命周期治理问题,而不是单纯的 Producer 参数。transaction.timeout.ms 决定客户端请求的事务窗口,Broker 的 transaction.max.timeout.ms 决定允许的上限,而真正决定系统稳定性的仍然是事务内部做了多少工作、每批处理多久,以及失败后能否安全建立下一次事务。