
消息队列 / 系统课时
为什么并发发送会乱序
为什么并发发送会乱序
并发发送并不意味着 Kafka 一定乱序,但它会让“业务调用先后”和“消息最终进入分区的先后”不再天然一致。多个请求同时发送、发送结果异步返回,再叠加失败重试后,消息时间线可能与原始调用顺序不同。
学习目标
- 理解并发发送为什么会打破简单的调用顺序假设
- 识别网络延迟、异步发送和重试带来的乱序来源
- 知道什么时候应依赖单分区顺序,什么时候需要额外的业务约束
调用顺序不等于完成顺序
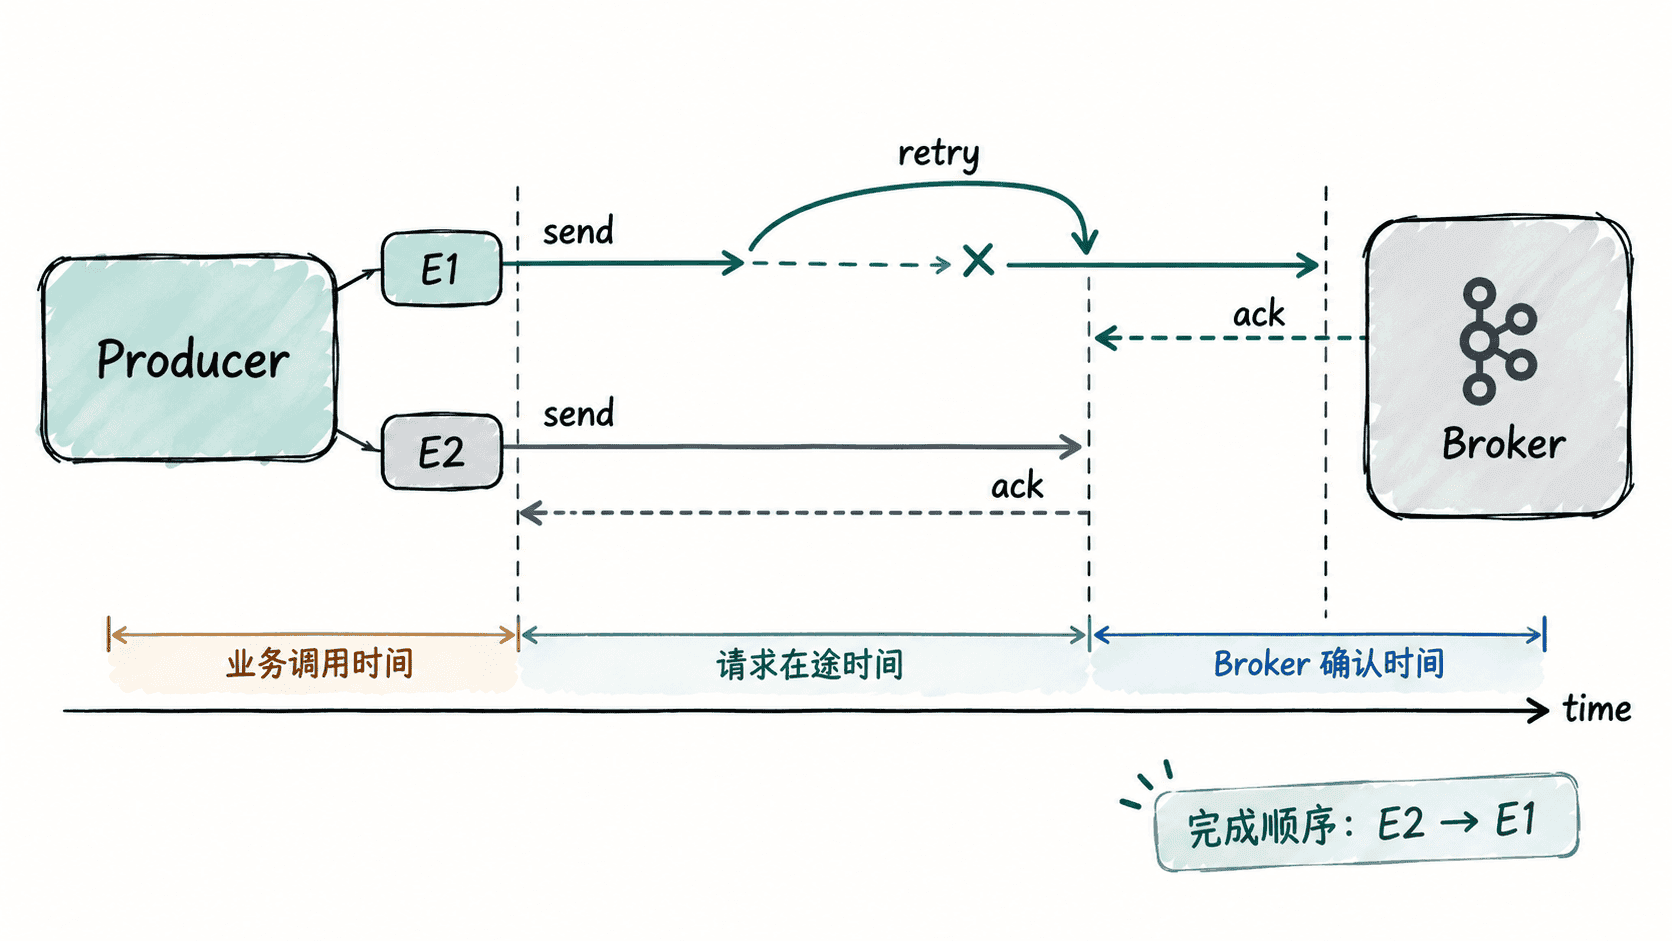
假设业务线程先发送事件 E1,随后发送 E2。如果两条消息同时在途,E1 可能因为网络抖动、批处理或失败重试而更晚得到确认,因此不能把“代码先调用 send”直接等同于“消息先完成”。KafkaProducer 的 send() 返回的是 Future<RecordMetadata>,调用本身先完成入队,真正的发送与确认在后续异步进行。
import java.util.Properties;
import java.util.concurrent.Future;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.clients.producer.RecordMetadata;
import org.apache.kafka.common.serialization.StringSerializer;

public class ConcurrentSendExample {
    public static void main(String[] args) throws Exception {
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "<HOST>:<PORT>");
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            // send() 先返回 Future;实际发送和确认在后台异步完成。
            Future<RecordMetadata> first = producer.send(
                new ProducerRecord<>("orders", "A1001", "CREATED"));
            Future<RecordMetadata> second = producer.send(
                new ProducerRecord<>("orders", "A1001", "PAID"));

            RecordMetadata firstMetadata = first.get();
            RecordMetadata secondMetadata = second.get();
            System.out.printf("E1 partition=%d offset=%d%n", firstMetadata.partition(), firstMetadata.offset());
            System.out.printf("E2 partition=%d offset=%d%n", secondMetadata.partition(), secondMetadata.offset());
        }
    }
}
预期结果
两次 send 可以连续发起,Future 分别等待各自的发送结果;实际 partition 和 offset 由集群元数据与分区分配决定,可能因环境不同而不同。如果两条消息最终属于同一个分区,生产者在启用幂等并使用有效的在途请求配置时,可以在失败重试场景下保持该分区内的顺序;在非幂等生产者中,多个请求同时在途时,前一个请求失败并重试可能让后续请求先成功,从而造成重排序风险。因此,不能只看 send() 调用顺序,还要结合分区、在途请求和重试配置判断。
重试为什么会放大顺序风险
发送失败后,生产者可能对尚未确认的消息进行重试。若同时存在其他在途请求,某条消息的重试可能晚于后续消息的首次发送,从而形成“业务先发生,网络后完成”的现象。KafkaProducer 会控制未确认请求的并发数,而幂等配置会进一步影响失败重试时的顺序语义。
排查乱序时,至少要区分三个时间点:业务事件产生时间、Producer 发起请求的时间、Broker 最终确认写入的时间。只比较应用日志里的 send 调用时间,往往不足以定位问题。
如何降低并发乱序风险
首先让具有强顺序约束的消息使用同一个业务 key,确保它们按同一分区规则路由;Kafka 的分区机制支持通过 key 选择目标分区,同一 key 通常会被映射到同一分区。其次,不要在应用层并行修改同一实体的状态,却又要求下游严格按照调用顺序解释事件。对于这类场景,应让事件本身携带可校验的版本号或序列号。
例如订单状态可以同时携带 version。消费者处理“版本 8”时,如果发现当前状态已经是“版本 9”,就不能仅凭消息到达顺序覆盖现有状态,而应执行幂等、丢弃旧版本或进入补偿流程。
什么时候应该额外保护
如果业务只要求“同一订单事件最终可按正确版本解释”,同一分区的顺序语义加上版本号通常已经足够清晰;如果业务要求跨订单、跨分区也存在严格全局先后,就不能仅靠普通 Topic 分区模型解决,需要重新设计顺序边界。
核心原则是:并发发送优化的是吞吐,不自动提供业务全局顺序。先定义顺序对象,再决定 key、分区和并发模型;不要事后依靠消费者线程调度去恢复已经丢失的顺序信息。