
P2P 与分布式存储 / 系统课时
用 UnixFS 表示目录和文件
用 UnixFS 表示目录和文件
当一个目录包含多个文件和子目录时,IPFS 需要保存的不只是文件内容,还包括名称、目录层级和文件大小等信息。本课使用 Kubo 导入一个两级目录,观察 UnixFS 节点与 IPLD 链接,沿根 CID 定位文件,并验证导出的目录是否与原始内容一致。
学习目标
- 使用 Kubo 将多级目录导入 UnixFS,并获取根 CID。
- 区分目录节点、文件节点、DAG-PB 链接和 UnixFS 元数据的职责。
- 通过根 CID 和目录路径读取文件,检查导出结果与原始文件是否一致。
准备多级目录并导入 IPFS
以下操作适用于使用默认 UnixFS 导入行为的 Kubo 0.30 及相近版本。要求已安装 ipfs 命令、执行过 ipfs init,并确保本地仓库可写。下面的本地导入、DAG 检查和文件读取操作不需要连接公共 IPFS 网络。
先在 Linux、macOS 或具有 Bash 环境的终端中建立测试目录。文件内容保持固定,便于后续检查。
mkdir -p demo/docs demo/assets
printf 'Hello UnixFS\n' > demo/hello.txt
printf 'IPFS directory example\n' > demo/docs/readme.txt
printf 'image-placeholder\n' > demo/assets/icon.txt
find demo -type f | sort
预期输出:
demo/assets/icon.txt
demo/docs/readme.txt
demo/hello.txt
使用 ipfs add -r 递归导入目录。--cid-version=1 要求生成 CIDv1;-Q 仅输出最终根 CID,便于保存和后续复用。
ROOT_CID=$(ipfs add -r -Q --cid-version=1 demo)
printf 'Root CID: %s\n' "$ROOT_CID"
ipfs files stat "/ipfs/$ROOT_CID"
预期结果:第一条输出显示以 Root CID: 开头的 CIDv1 字符串;第二条输出显示对应 UnixFS 对象的统计信息,包括类型、大小等字段。CID 具体值由内容、导入参数和编码方式决定,不应预先硬编码。
UnixFS 如何组织文件和目录
UnixFS 是 IPFS 生态中表示文件、目录及相关元数据的数据格式。它通常建立在 IPLD 数据模型之上,使用 DAG-PB 节点保存目录链接或文件布局信息;文件内容也可能直接保存在 Raw 块中。
本例包含三类关键对象:
- 根目录
demo:保存hello.txt、docs、assets三个命名链接。 - 子目录
docs和assets:分别保存指向各自文件节点的链接。 - 文件节点:表示文件内容。小文件可能由一个 DAG-PB 节点承载,也可能使用 Raw 叶子块;较大的文件可能形成多级分块 DAG。
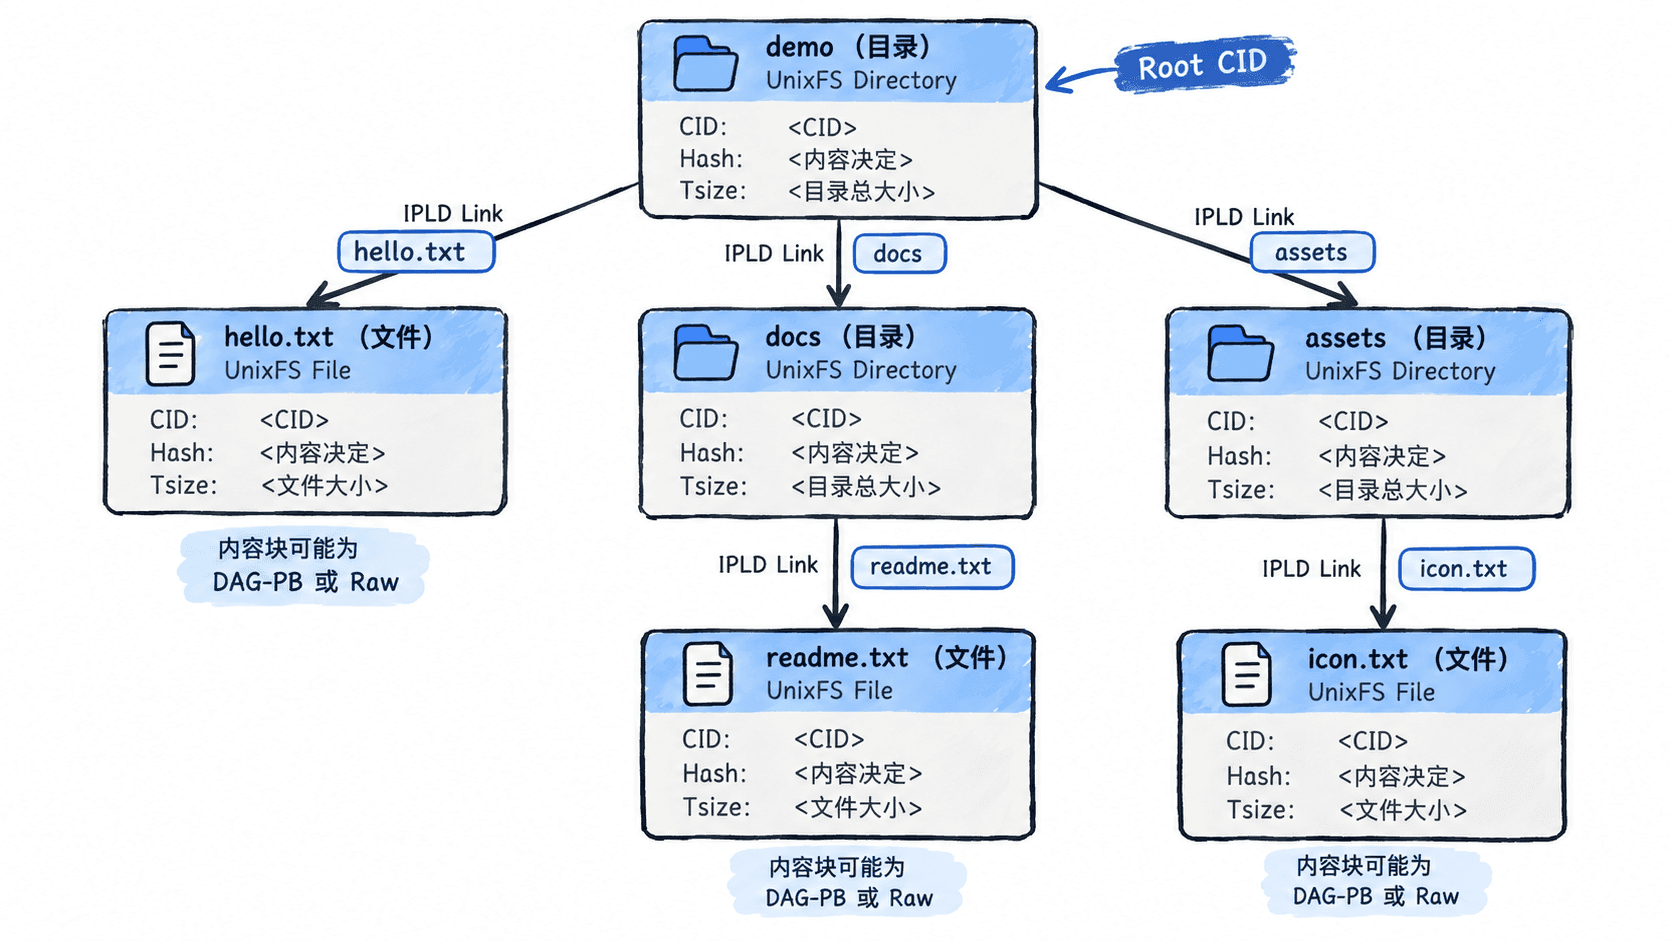
在 DAG-PB 目录节点中,Links 数组的每个元素通常包含 Name、Hash 和 Tsize:
| 字段 | 含义 | 本例中的作用 |
|---|---|---|
Name |
子项在父目录中的名称 | docs 或 hello.txt |
Hash |
指向子节点的 CID | 定位目录或文件节点 |
Tsize |
链接目标的累计 DAG 大小信息 | 用于记录子 DAG 的大小,不是文件名长度 |
UnixFS 目录自身的类型信息存放在节点的 UnixFS 数据中。文件的逻辑大小、块大小信息等也可由 UnixFS 元数据描述。不要将 PBLink 的 Tsize 直接当成用户看到的文件字节数:它可能包含编码开销及被引用的子块大小。
检查目录链接和 UnixFS 元数据
ipfs ls 适合快速检查 UnixFS 目录的直接子项;ipfs dag get 则用于观察底层 IPLD 对象。二者看到的是不同抽象层次。
ipfs ls "$ROOT_CID"
ipfs dag get "$ROOT_CID"预期结果:ipfs ls 列出 assets、docs 和 hello.txt 对应的 CID、大小及名称;ipfs dag get 返回根节点的结构化表示,包含 Data 和 Links 等信息。实际顺序、CID 和编码展示方式以本地版本为准。
对于默认的 DAG-PB UnixFS 目录,Data 是 UnixFS 元数据的二进制编码,不能简单地将其当作普通 UTF-8 文件内容;Links 则包含可解析的子节点引用。
接下来查看 UnixFS 层面识别出的文件类型和大小:
ipfs files stat "/ipfs/$ROOT_CID/docs"
ipfs files stat "/ipfs/$ROOT_CID/docs/readme.txt"预期结果:第一条显示目录对象的信息,第二条显示文件对象的信息。对于本例,readme.txt 的逻辑文件大小为 23 字节;具体统计输出的字段和 DAG 占用大小可能因 Kubo 版本及导入编码不同而变化。
从根 CID 逐级解析目录路径
IPFS 路径 /ipfs/<CID>/docs/readme.txt 不是传统磁盘上的绝对路径。它以根 CID 为入口,逐级解析 UnixFS 目录中的命名链接。
解析过程如下:
- 根据根 CID 读取
demo目录节点,确认其 UnixFS 类型为 Directory。 - 在根节点的链接中查找名称为
docs的子项,取得其目标 CID。 - 读取
docs目录节点,查找名称为readme.txt的链接。 - 根据文件节点及其引用的内容块恢复字节流,并交给调用方。
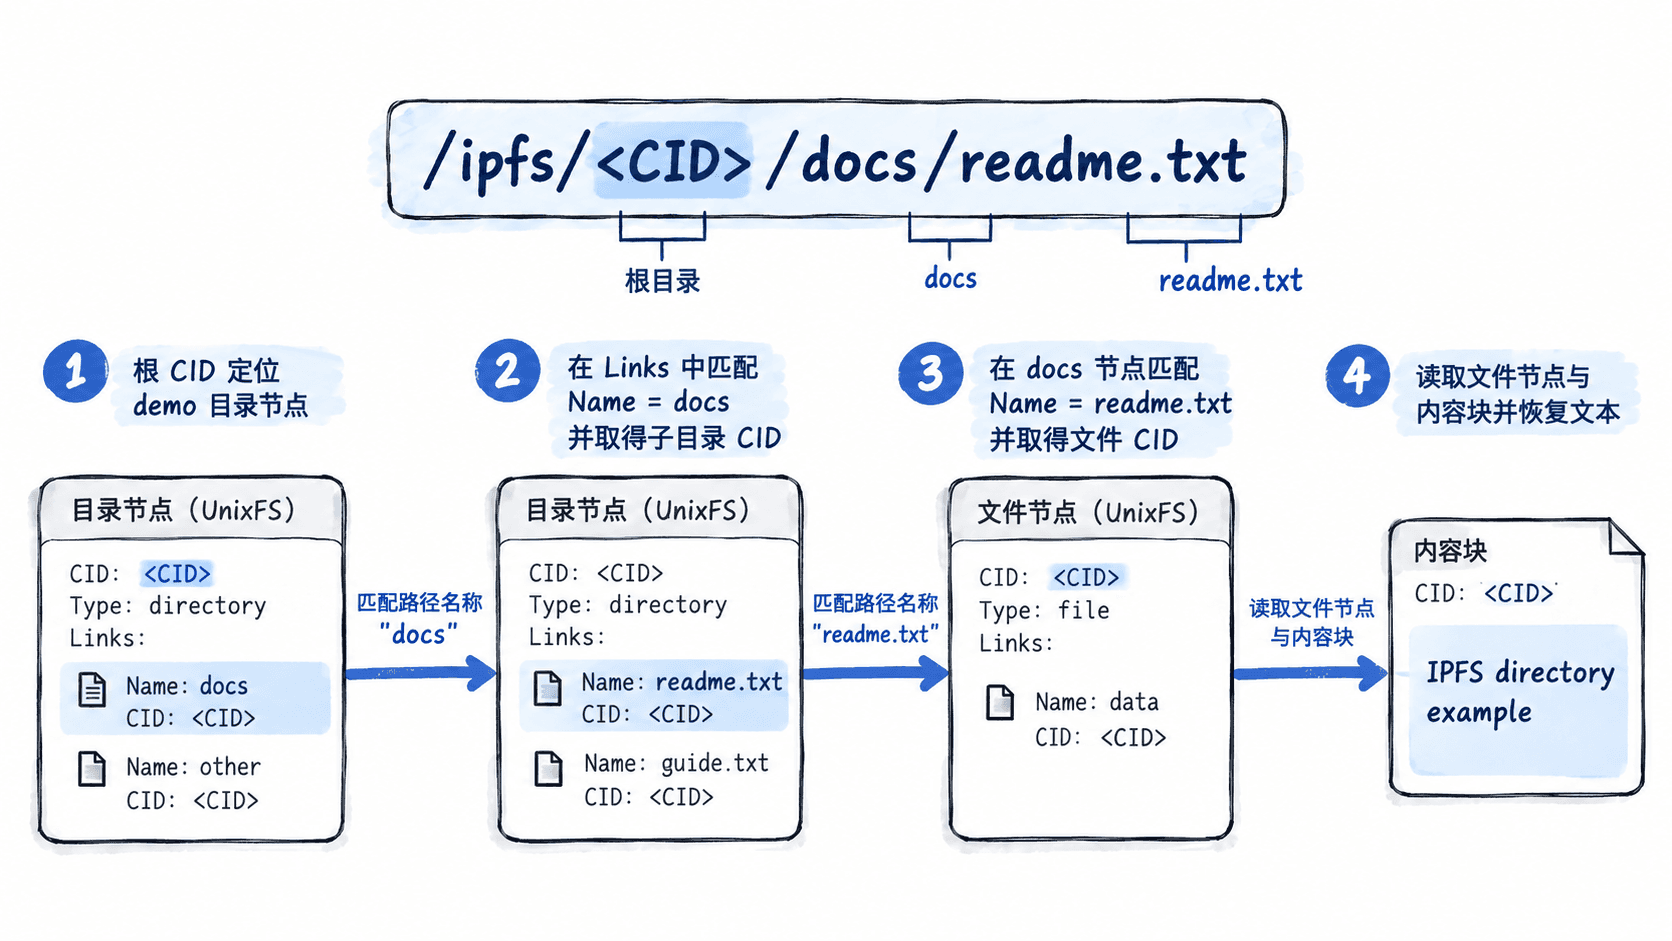
直接使用 ipfs cat 验证路径解析:
ipfs cat "/ipfs/$ROOT_CID/docs/readme.txt"
ipfs cat "/ipfs/$ROOT_CID/hello.txt"
预期输出:
IPFS directory example
Hello UnixFS
这说明 Kubo 能从根 CID 出发,根据目录链接名称找到目标文件,而不是通过文件名直接查询全局索引。路径中任意一级名称错误,都会导致解析失败。
导出目录并验证内容完整性
ipfs get 可以将 UnixFS 文件或目录恢复到本地文件系统。为避免覆盖原目录,使用独立的输出位置。
mkdir -p restored
ipfs get "$ROOT_CID" -o restored/demo

diff -r demo restored/demo
printf 'diff exit code: %s\n' "$?"
预期输出:
diff exit code: 0ipfs get 可能显示进度信息;上面仅列出最终的比较结果。diff -r 无差异时退出码为 0,说明导出后的文件内容和目录结构与原始测试目录一致。
还可以直接验证文件字节流:
ipfs cat "/ipfs/$ROOT_CID/docs/readme.txt" | sha256sum
sha256sum demo/docs/readme.txt
预期结果:两行输出的 SHA-256 摘要完全一致。第一行从 UnixFS 路径恢复内容后计算摘要,第二行直接对原始文件计算摘要;摘要后的文件名或标准输入标记可能不同。
如果导出失败,按以下顺序检查:根 CID 是否完整、路径名称大小写是否一致、相关块是否仍在本地仓库,以及是否误将 ipfs files 的 MFS 路径与 /ipfs/ 内容路径混用。
目录变化为什么会产生新的 CID
Merkle DAG 的父节点引用子节点 CID,因此目录内的文件内容发生变化时,受影响的文件节点 CID 通常变化,引用它的目录节点也需要更新。变化会沿父目录向根目录传播。
使用独立副本验证这一特性,避免覆盖原来的实验数据:
cp -R demo demo-v2
printf 'Updated content\n' > demo-v2/docs/readme.txt
NEW_ROOT=$(ipfs add -r -Q --cid-version=1 demo-v2)
printf 'Old root: %s\nNew root: %s\n' "$ROOT_CID" "$NEW_ROOT"
预期结果:输出两个不同的根 CID。这里除了文件内容变化,顶层目录名称也由 demo 变成 demo-v2;不过根目录 CID 的差异来自其编码内容及引用关系的变化,而不是顶层目录在本地磁盘上的名称本身。
在默认的命名目录链接结构中,未修改的 hello.txt 和 assets 子树仍可复用原有内容块;docs/readme.txt 及引用它的 docs、根目录节点则需要重新计算 CID。对于大文件,变化是否影响其他块还取决于分块算法和文件布局。
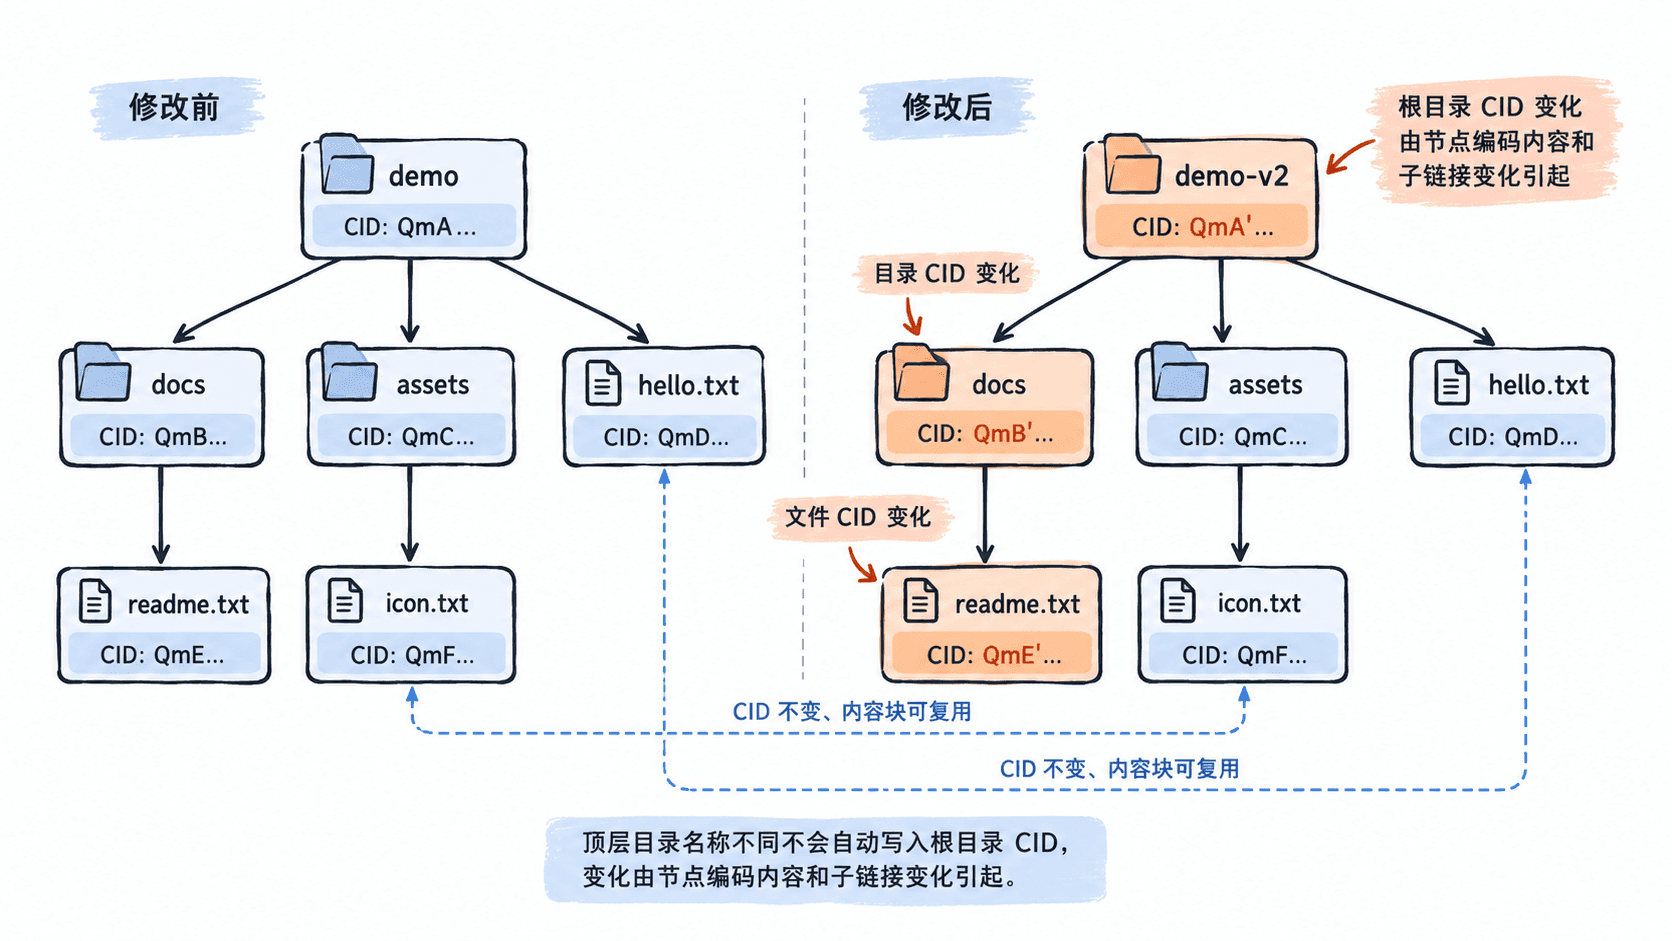
通过这组实验可以确认:UnixFS 负责表达文件与目录语义,IPLD 链接负责连接内容寻址节点,而根 CID 则为整棵目录 DAG 提供可验证的入口。