
P2P 与分布式存储 / 系统课时
定位提供者为空的检索失败
定位提供者为空的检索失败
已知 CID 却查不到内容提供者时,先不要认定文件已经丢失。这里以保存数据的 Kubo 节点 A 和发起检索的节点 B 为例,分别检查本地数据、提供者记录与路由连接,再用跨节点下载确认修复有效。
学习目标
- 区分“查不到提供者记录”和“内容块确实丢失”。
- 使用 Kubo 命令检查 Pin、完整 DAG、路由及提供状态。
- 补发提供者记录,并从另一节点验证可发现和可取回。
识别故障发生的层次
检索一份 IPFS 内容至少涉及三层:A 的块存储保存实际数据;提供者发布机制把 CID 与可提供它的 Peer ID 关联起来;B 通过 DHT 或已配置的委托路由发现节点后,再连接并下载区块。提供者记录不存放文件本身。
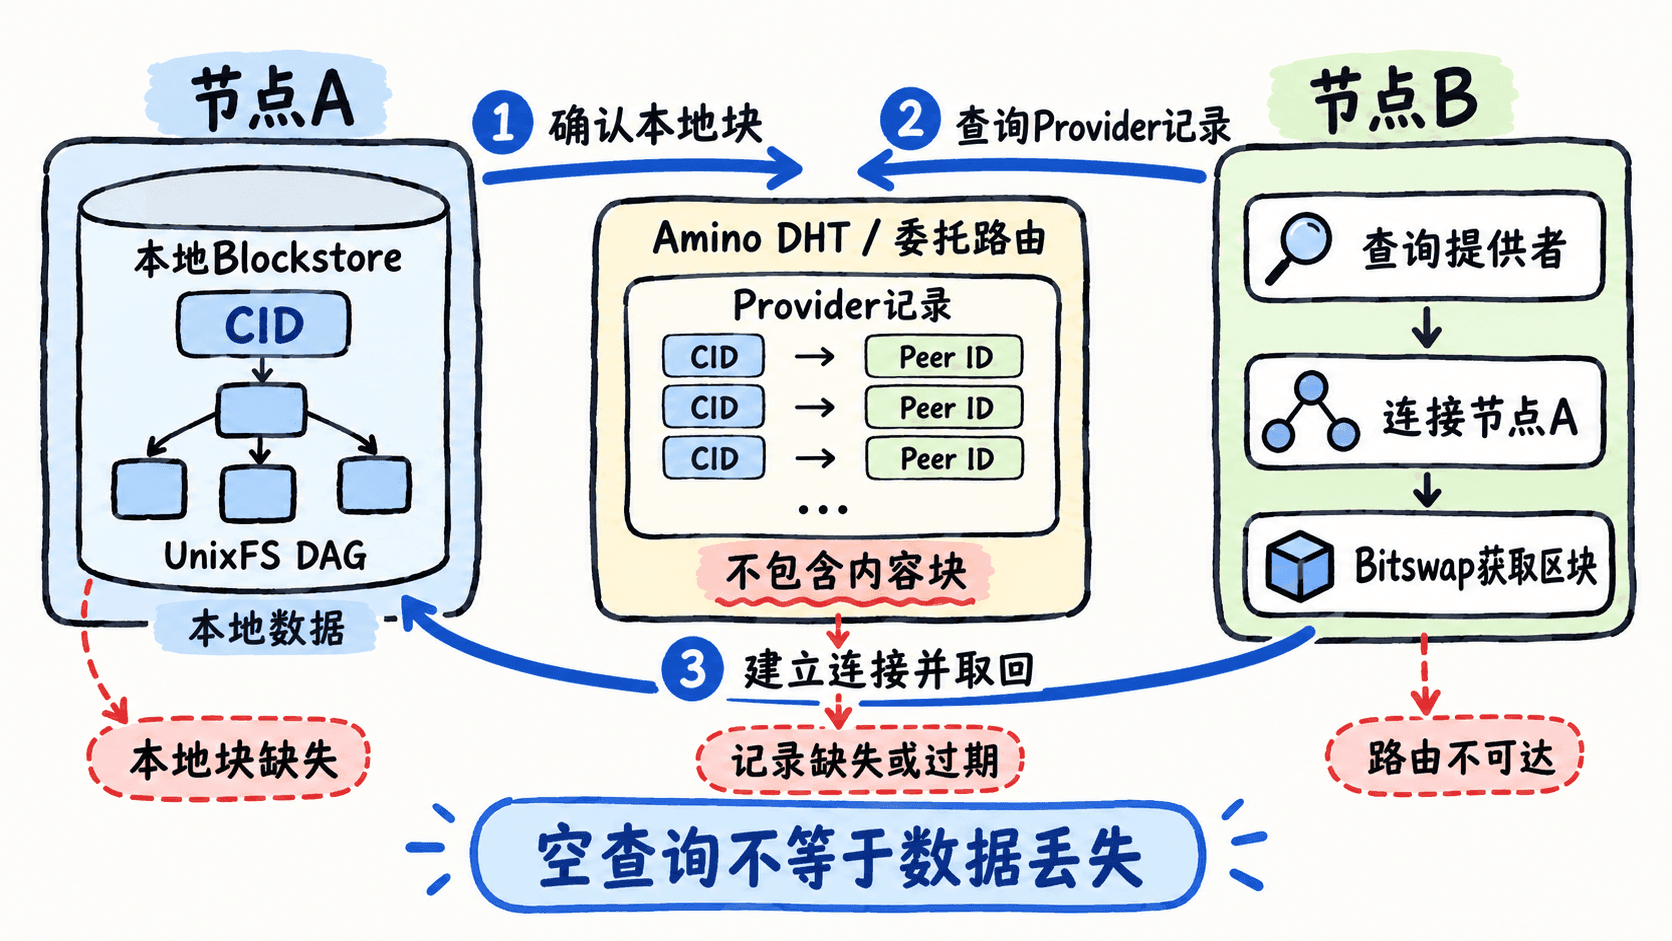
例如,A 已保存完整 DAG,但发布任务未完成或记录过期,B 的 findprovs 仍可能没有结果。反过来,即使能查到一个 Peer ID,该节点也可能离线或缺少部分区块,因此“发现成功”还不是“读取成功”。
检查节点 A 是否仍持有内容
以下命令以 Kubo 0.43.x 和 Bash 终端为例。把 <CID> 替换为实际根 CID;确保 A 的守护进程已启动,且终端连接的是 A 的仓库,不是 B 的 RPC 地址。先检查该 CID 的 Pin 类型与递归 Pin 完整性。
# 在节点 A 执行;递归 Pin 能保护根及其后代块
CID='<CID>'
ipfs pin ls "$CID"
ipfs pin verify --quiet
预期输出(根 CID 被递归 Pin 且所有递归 Pin 完整时):
<CID> recursive第二条命令在没有发现损坏的递归 Pin 时不输出内容。若 pin ls 提示未被 Pin,仅说明没有找到该 CID 的 Pin,不能证明块已消失;MFS 引用或尚未清理的缓存也可能保有数据。若是 direct Pin,它只保护指定块,不保证子 DAG 完整。
需要进一步排除“在线读取自动从别处补块”的干扰时,在维护窗口停止 A 的守护进程后,以离线方式遍历该 CID 的全部 DAG。不要在服务运行中强行争用同一个仓库锁。
CID='<CID>'
# 离线遍历完整 DAG,避免从网络获取缺失块
if ipfs --offline dag stat "$CID" >/dev/null; then
  printf 'LOCAL_DAG_COMPLETE\n'
else
  printf 'LOCAL_DAG_FAILED\n'
fi
预期输出(所有必需块均在本地且能正常解码时):
LOCAL_DAG_COMPLETE若显示 LOCAL_DAG_FAILED,需结合实际错误排查缺块、错误 CID 或仓库访问问题,不能仅凭该标记判定永久丢失。若确认缺块,应先从备份、原始文件或其他副本恢复,再重新 Pin;离线检查后恢复 A 的守护进程。
在节点 B 查询提供者与路由
确认 A 拥有数据后,回到联网的 B 上查询同一个根 CID。不要在 A 本机代替 B 查询,否则本地缓存可能掩盖另一节点的路由故障。
# 在节点 B 执行
CID='<CID>'
ipfs routing findprovs --num-providers=5 "$CID"
预期输出(B 成功发现 A 时,以实际 Peer ID 替换占位符):
<ID_A>若查询完成但没有输出,表示 B 此刻通过其已配置的路由尚未发现提供者,不等于全网不存在副本。若报超时或网络错误,应先查路由可用性,不能把它归为“空记录”。
# 在节点 B 检查路由模式和已连接节点数
printf 'ROUTING='
ipfs config Routing.Type
printf 'CONNECTED_PEERS='
ipfs swarm peers | awk 'END {print NR}'
预期输出(使用常见自动路由且已有连接时):
ROUTING=auto
CONNECTED_PEERS=<COUNT>
<COUNT> 是动态连接数,应大于 0 才能说明当前存在连接,但仍不足以保证 DHT 正常。若 Routing.Type 是 none、连接数为 0,或节点只启用不具备所需发布能力的路由,应核对部署配置、引导节点及网络策略。A 也要检查同样的路由条件。较新 Kubo 使用 ipfs routing findprovs;旧教程中的 ipfs dht findprovs 已从 Kubo 0.43.x 移除。
补发记录并核对发布状态
在 A 已确认持有对应根块且重新联网后,手动补发一次提供者记录。Kubo 0.43.x 的 provide once 是实验性命令;默认 Sweep 提供器可能先将任务排队,命令成功并不代表记录已立刻传播。
# 在节点 A 执行
CID='<CID>'
ipfs --enc=json provide once "$CID"
预期输出(成功入队时):
{"Queued":"<CID>"}随后在 A 执行 ipfs provide stat --queues --operations --connectivity,观察队列是否消化、是否出现发布错误及 DHT 连接状况。提供者记录通常有约 48 小时的有效期,长期依赖单次 provide once 无法代替持续的重新发布;还需核对 Provide.Enabled、Provide.Strategy 及重提供调度是否符合部署目标。
从独立节点验收可取回性
在 B 再次执行查询,并把内容下载到一个尚不存在的输出路径。<PATH> 替换成实际保存路径;这里刻意不在 A 上执行下载,避免本地命中造成假阳性。
CID='<CID>'
OUT='<PATH>'
# 从节点 B 完整下载,区分提供者发现与实际取回
ipfs routing findprovs --num-providers=5 "$CID"
if ipfs get --progress=false --output="$OUT" "$CID" >/dev/null; then
  printf 'RETRIEVAL_OK\n'
else
  printf 'RETRIEVAL_FAILED\n'
fi
预期输出(发现 A 且成功下载时):
<ID_A>
RETRIEVAL_OK
若 B 已能查到 A 但下载失败,继续检查 A 的对外地址、NAT、防火墙、连接性及区块完整性;故障已从“提供者为空”转移到连接或交换层。若多次跨节点查询均为空,而 A 的本地 DAG 完整,应优先修复发布和路由配置,而不是重新计算 CID。最终验收应同时满足:A 的数据完整、B 能发现 A、B 能实际下载并读取内容。