
P2P 与分布式存储 / 系统课时
拆解 CIDv1 的编码字段
拆解 CIDv1 的编码字段
拿到一串以 bafy 开头的 IPFS CID 时,不能只凭前缀判断文件类型或哈希算法。本课通过拆解真实 CID 的二进制字段,识别版本、Multicodec、Multihash 和 Multibase,并用 Python 验证编码与解码结果,最终能够区分内容标识本身与它的文本表示。
学习目标
- 说明 CIDv1 的字段顺序以及各字段的职责。
- 区分 Multibase 文本前缀、Multicodec 内容类型和 Multihash 哈希信息。
- 使用可运行脚本拆解 CIDv1,并验证不同文本编码表示同一个内容标识。
CIDv1 的逻辑结构
CID(Content Identifier)是 IPFS 用来标识内容的结构化标识符。CIDv1 由三个连续部分组成:版本号、内容类型编码和 Multihash。它们按顺序编码成字节序列,之后才转换成便于复制和传输的字符串。
| 组成部分 | 作用 | 常见值 |
|---|---|---|
| Version | 标明 CID 结构版本 | 0x01,表示 CIDv1 |
| Multicodec | 标明被标识内容的编码格式 | 0x70 为 dag-pb;0x55 为 raw |
| Multihash | 保存哈希算法编码、摘要长度和摘要 | 0x12 为 sha2-256;长度 0x20 为 32 字节 |
前三个数字字段并非固定宽度整数,而是使用无符号 Varint 编码。常见值小于 128,因此各占一个字节;较大的编码值可能占多个字节,不能假定每个字段始终只有一个字节。
Multihash 自身包含三个部分:哈希函数编码、摘要字节长度和摘要数据。例如使用 SHA-256 时,通常由 0x12、0x20 和 32 字节摘要组成,总长度为 34 字节。
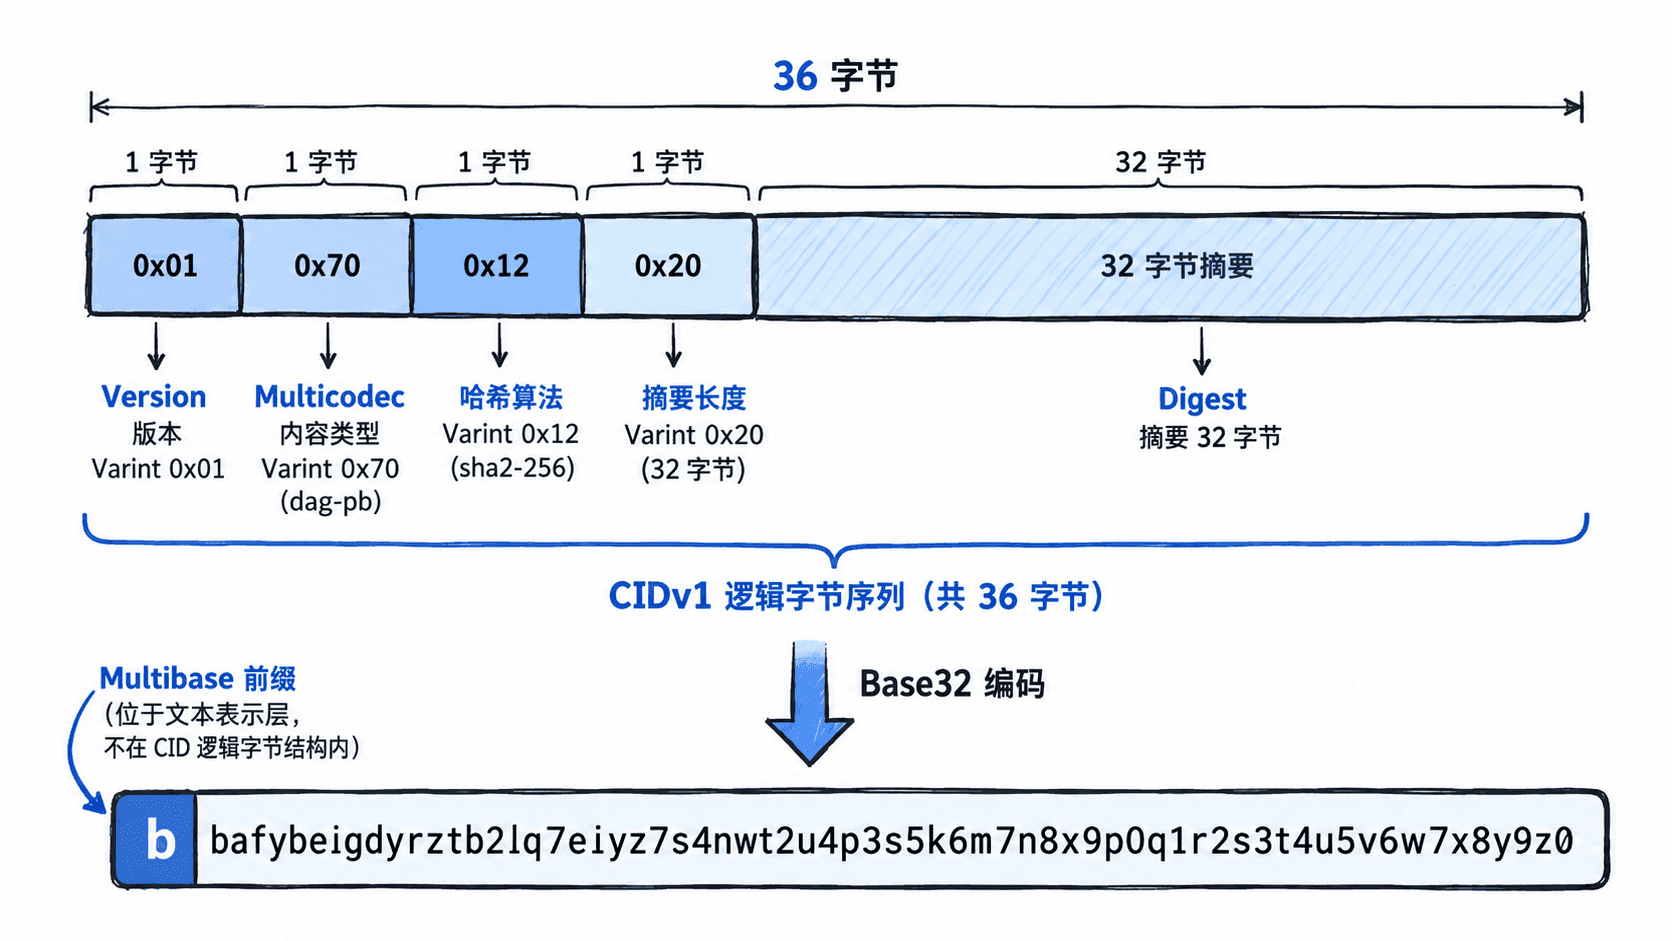
Multibase 为什么不属于 CID 的内部字段
CIDv1 可以使用多种 Multibase 编码展示同一组字节。Multibase 在文本开头放置一个编码标识字符,让解码器知道后续字符应该按哪一种进制解码。
| 文本前缀 | Multibase 编码 | 典型用途 |
|---|---|---|
b |
base32 小写 | 常见 CIDv1 文本表示 |
z |
base58btc | 另一种可读文本表示 |
k |
base36 小写 | 可用于部分 DNS 场景 |
例如,b 只告诉解码器后续文本使用 base32,并不代表版本号、文件格式或哈希算法。去掉 Multibase 前缀并解码后,得到的字节序列才从 Version 字段开始。
同一 CIDv1 的 base32 和 base58btc 字符串通常不同,但解码得到的 CID 字节完全相同。相反,仅仅因为两个字符串都以 bafy 开头,不能断定它们引用同一份内容。
用 Python 拆解真实 CIDv1
下面使用一个可复现的 CIDv1 示例:将 SHA-256 空字符串摘要包装为 Multihash,再指定 raw Multicodec,最后进行 base32 编码。这样不依赖网络节点,也不会把 CID 文本误当作普通哈希字符串。
环境要求 Python 3.9 或更高版本,仅使用标准库。保存为 inspect_cid.py 后运行。
import base64
import hashlib


def read_uvarint(data, offset):
    # Varint 的低7位承载数值,最高位表示是否继续。
    value = 0
    shift = 0
    while offset < len(data):
        byte = data[offset]
        offset += 1
        value |= (byte & 0x7F) << shift
        if byte < 0x80:
            return value, offset
        shift += 7
        if shift > 63:
            raise ValueError('Varint 超出支持范围')
    raise ValueError('Varint 不完整')


def inspect(cid):
    if not cid.startswith('b'):
        raise ValueError('此示例只支持小写 base32 CIDv1')
    encoded = cid[1:].upper()
    encoded += '=' * ((-len(encoded)) % 8)
    data = base64.b32decode(encoded)

    version, pos = read_uvarint(data, 0)
    codec, pos = read_uvarint(data, pos)
    hash_code, pos = read_uvarint(data, pos)
    digest_size, pos = read_uvarint(data, pos)
    digest = data[pos:]

    if version != 1 or len(digest) != digest_size:
        raise ValueError('CID版本或摘要长度不符合预期')

    print('version:', version)
    print('codec:', hex(codec))
    print('hash:', hex(hash_code))
    print('digest length:', len(digest))
    print('digest:', digest.hex())
    print('CID bytes:', len(data))


if __name__ == '__main__':
    # raw + sha2-256;摘要来自空字节串。
    digest = hashlib.sha256(b'').digest()
    cid_bytes = bytes([0x01, 0x55, 0x12, 0x20]) + digest
    cid = 'b' + base64.b32encode(cid_bytes).decode().lower().rstrip('=')
    inspect(cid)
运行命令:
python inspect_cid.py预期输出:
version: 1
codec: 0x55
hash: 0x12
digest length: 32
digest: e3b0c44298fc1c149afbf4c8996fb92427ae41e4649b934ca495991b7852b855
CID bytes: 36
这里的 0x55 代表 raw,0x12 代表 sha2-256。36 字节由版本号 1 字节、Multicodec 1 字节、Multihash 算法编码 1 字节、摘要长度 1 字节和摘要数据 32 字节组成。
这段脚本刻意只支持小写 base32 CIDv1,避免把示范解析器误认为完整的 Multibase 实现。生产环境应使用成熟的 CID、Multiformats 库处理不同编码、Varint 合法性和多种哈希算法。
同一摘要不一定意味着同一个 CID
假设两个 CID 都使用 SHA-256,且摘要恰好相同,但一个 Multicodec 是 raw(0x55),另一个是 dag-pb(0x70)。它们的 Multihash 相同,CID 的完整字节序列却不同,因此是两个不同的 CID。
还需要区分三个经常混淆的概念:
- Multicodec 描述 CID 指向的数据块采用什么编码格式,并不直接说明用户看到的文件扩展名。
- Multihash 描述摘要算法和摘要值,并不证明数据来自可信发布者。
- Multibase 描述 CID 字节如何转成字符串,不改变原始 CID 字节。
CIDv0 也不能简单视为带有另一种前缀的 CIDv1。CIDv0 是受限的历史格式,使用 dag-pb 和 sha2-256,并以无 Multibase 前缀的 base58btc Multihash 字符串表示;CIDv1 则显式包含版本号和 Multicodec。转换时必须检查约束,而不能只替换字符串开头。
验证文本表示和内容标识的边界
可以在上面的 Python 脚本中,将 cid_bytes 保持不变,分别生成 base32 和 base16 表示。base16 的 Multibase 前缀为 f,对应小写十六进制文本。
以下为片段示例,依赖前一个完整脚本中的 cid_bytes 变量,添加到调用 inspect(cid) 之后:
# 两种文本表示封装的是同一组CID字节。
base16_cid = 'f' + cid_bytes.hex()
base32_cid = cid
print('base32 prefix:', base32_cid[0])
print('base16 prefix:', base16_cid[0])
print('same bytes:', bytes.fromhex(base16_cid[1:]) == cid_bytes)
预期输出:
base32 prefix: b
base16 prefix: f
same bytes: True
这个实验验证了文本编码可以变化,而 Version、Multicodec 和 Multihash 组成的 CID 字节仍然一致。它并不意味着不同内容编码格式的 CID 可以任意互换。
实际排查 CID 问题时,先检查 Multibase 并解码,再读取 Version、Multicodec 和 Multihash,最后核对摘要长度及数据块的哈希结果。只有完成这些检查,才能判断字符串表示差异、编码格式差异和真正的内容变化分别发生在哪一层。