
P2P 与分布式存储 / 系统课时
复现文件变化引起的 CID 变化
复现文件变化引起的 CID 变化
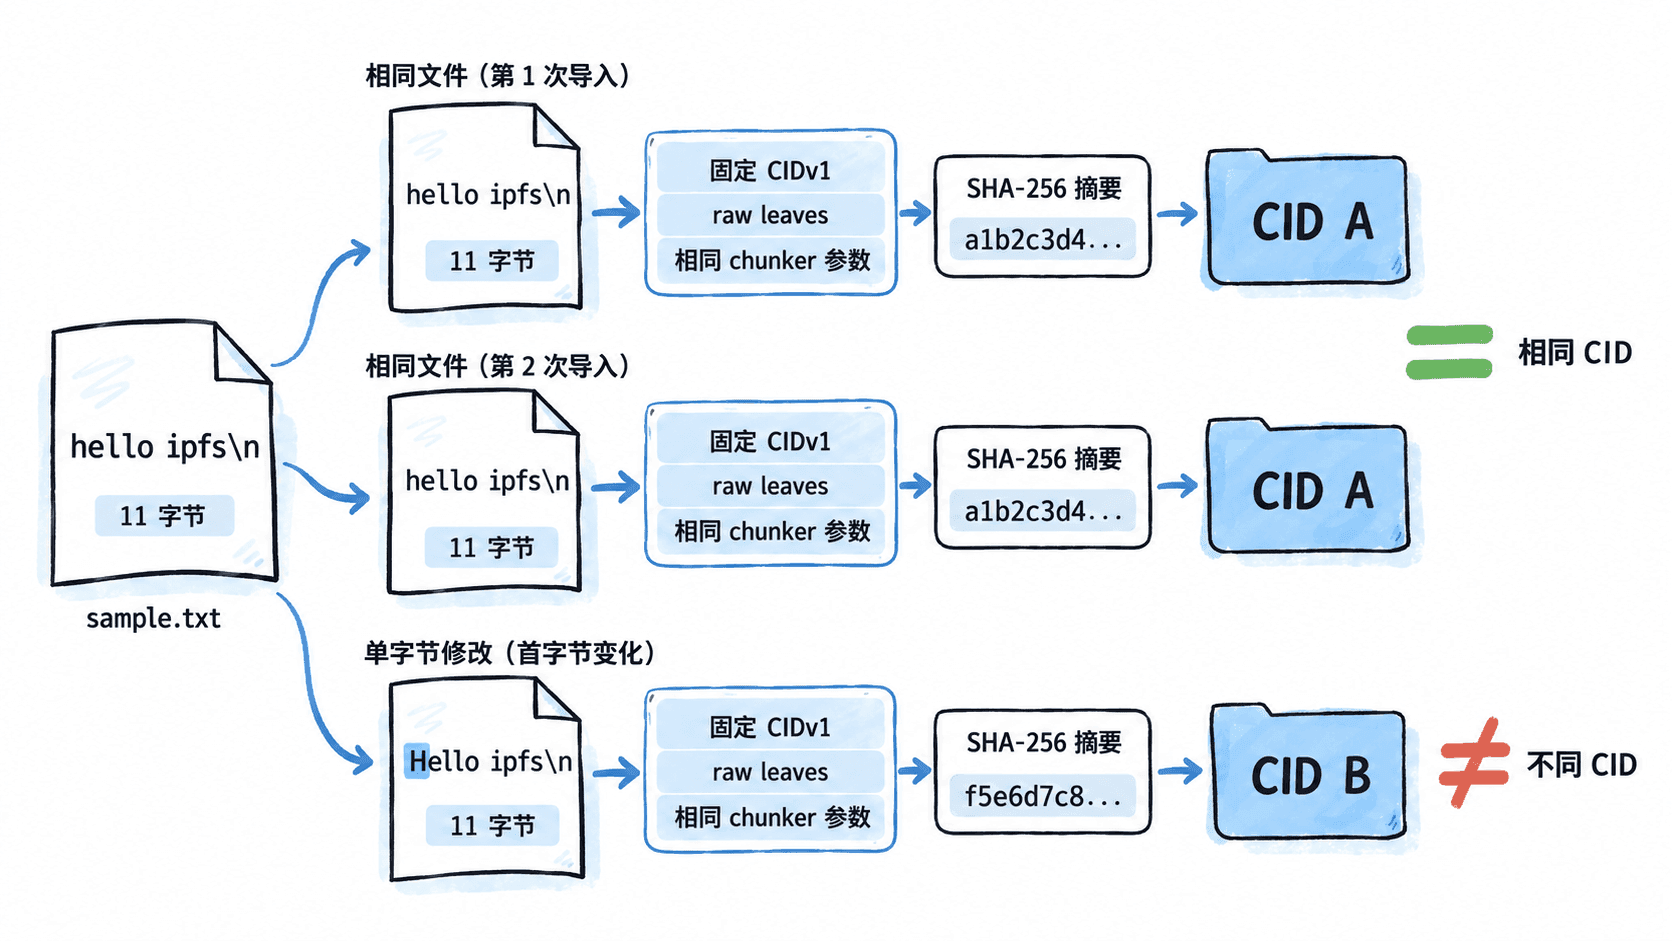
同一个文件重复导入 IPFS,CID 是否一定相同?只修改一个字节又会发生什么?本课使用 Kubo 命令行完成三组对照实验,记录 CID、文件哈希与读取结果,区分内容变化和导入参数变化对内容标识的影响。
学习目标
- 使用固定导入参数验证相同文件的 CID 稳定性。
- 修改文件中的一个字节,观察 CID 与 SHA-256 摘要的变化。
- 识别 CID 比较成立的条件,并通过读取和重新计算摘要验证内容。
准备可重复的实验环境
实验使用已安装并初始化的 Kubo,要求终端可以执行 ipfs 命令。使用 ipfs version 检查版本,并确保实验期间使用同一个 Kubo 版本和相同导入选项。
ipfs version预期输出示例(实际版本号可能不同):
ipfs version 0.XX.X本实验只调用本地仓库操作,不要求连接公网 Peer,也不要求先启动 ipfs daemon。若提示仓库未初始化,应先在独立实验环境执行 ipfs init;已有仓库不需要重复初始化。
为了避免编辑器自动添加换行、修改编码或保存 BOM,使用 Python 3 精确生成实验文件。以下命令适用于提供 Python 3 的 Bash 环境,后续命令也在同一工作目录执行。
mkdir -p ipfs-cid-lab
cd ipfs-cid-lab
python3 - <<'PY'
from pathlib import Path

# 固定 UTF-8 字节,避免编辑器引入额外换行
Path('sample.txt').write_bytes(b'hello ipfs\n')
print(Path('sample.txt').read_bytes())
PY
预期输出:
b'hello ipfs\n'文件实际包含 11 个字节,其中末尾换行占 1 字节。后续所有对照实验都以这个字节序列为基准。
验证内容不变时 CID 保持稳定
使用 ipfs add 将文件导入本地仓库,并固定 --cid-version=1、--raw-leaves=true、--chunker=size-262144 等选项。文件较小,只需一个叶子块;这些选项的作用是固定本次实验的内容编码与分块方式。
ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample.txt
ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample.txt
预期结果:两行输出都是 CIDv1 字符串,通常以 bafy 开头,且两次结果逐字相同。具体 CID 由实际文件字节和编码参数决定,不需要预先填写固定值。--only-hash 计算导入结果的 CID,但不将新块写入仓库。
可以使用下面的 Bash 脚本自动比较,避免手动抄写长字符串出错。
CID1=$(ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample.txt)
CID2=$(ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample.txt)
# 使用完全一致的选项进行两次计算
if [ "$CID1" = "$CID2" ]; then
  echo '相同内容:CID 一致'
else
  echo '相同内容:CID 不一致'
fi
预期输出:
相同内容:CID 一致这里验证的是同一字节序列在相同导入规则下产生相同 CID,而不是文件名、创建时间或本地路径相同。对于当前单块 raw-leaf 文件,文件名不参与这个叶子块的 CID 计算。
修改一个字节并比较 CID
先保存原始文件,再将第一个字节由小写 h(十六进制 0x68)改成大写 H(0x48)。文件长度保持 11 字节,只有一个字节发生变化。
python3 - <<'PY'
from pathlib import Path

source = Path('sample.txt').read_bytes()
# 只替换首字节,其余字节和文件长度保持不变
assert source == b'hello ipfs\n'
Path('sample-modified.txt').write_bytes(b'H' + source[1:])
print(Path('sample-modified.txt').read_bytes())
PY
预期输出:
b'Hello ipfs\n'接下来同时比较 SHA-256 文件摘要和 IPFS CID。SHA-256 用于观察原始字节变化;CID 则包含内容编码信息与多哈希标识,两者不能直接当成同一种字符串比较。
sha256sum sample.txt sample-modified.txt
CID_ORIGINAL=$(ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample.txt)
CID_MODIFIED=$(ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --only-hash --quiet sample-modified.txt)
if [ "$CID_ORIGINAL" != "$CID_MODIFIED" ]; then
  echo '单字节修改:CID 已变化'
else
  echo '单字节修改:CID 未变化'
fi预期结果:sha256sum 显示两个不同的 64 位十六进制摘要,随后输出:
单字节修改:CID 已变化对于本实验的 raw-leaf、SHA-256 内容标识,原始字节发生变化会使摘要变化,进而使 CID 变化。严格来说,密码学哈希存在理论上的碰撞可能,因此不能将“任意不同输入绝对不可能得到同一摘要”作为数学保证。
将计算结果与实际读取结果对照
前面的 --only-hash 没有存储文件块。现在执行真实导入,再通过返回的 CID 读取内容,验证仓库中的对象确实对应原始字节。
CID=$(ipfs add --cid-version=1 --raw-leaves=true --chunker=size-262144 --quiet sample.txt)
# 读取刚写入本地仓库的内容,并逐字节比较
ipfs cat "$CID" > restored.txt
python3 - <<'PY'
from pathlib import Path

original = Path('sample.txt').read_bytes()
restored = Path('restored.txt').read_bytes()
print('读取内容一致:', original == restored)
print('文件字节数:', len(restored))
PY
预期输出:
读取内容一致: True
文件字节数: 11
这一步确认 CID 能在本地仓库中定位已导入的内容,并且读取后的字节与源文件一致。若使用其他节点读取,还需要该节点能够发现并取得对应数据;拥有 CID 本身并不保证数据一定在线或可获取。
排除导入参数造成的干扰
判断 CID 是否稳定时,至少要同时固定以下条件:
| 对照条件 | 实验中的固定值 | 变化可能造成的影响 |
|---|---|---|
| 文件字节 | hello ipfs 加 LF 换行 |
内容摘要变化 |
| CID 版本 | --cid-version=1 |
CID 表示结构可能不同 |
| 叶子编码 | --raw-leaves=true |
raw 与 dag-pb 编码可能产生不同 CID |
| 分块规则 | --chunker=size-262144 |
大文件的分块及 DAG 结构可能不同 |
| 文件导入形式 | 单文件导入,不使用 --wrap-with-directory |
包装目录会引入额外的目录对象 |
需要特别区分两种现象:同一内容使用不同 Multibase 文本编码时,CID 字符串可能不同,但仍指向相同的 CID 标识;而改变 IPLD 编码、哈希算法或 DAG 构造方式,则可能真正改变标识的对象。
本实验的验收标准是:重复计算得到相同 CID;修改一个字节后得到不同 CID;实际导入并通过 CID 读取后恢复原始 11 字节。只有同时控制输入字节和导入规则,才能把 CID 的变化正确归因于文件内容变化。