
P2P 与分布式存储 / 系统课时
区分 CIDv0 和 CIDv1 的差异
区分 CIDv0 和 CIDv1 的差异
同一份 IPFS 内容可能同时拥有以 Qm 开头和以 bafy 开头的两种 CID 表示。它们的字符串不同,却不一定代表内容发生变化。本课通过字段拆解、Kubo 命令转换和实际校验,判断 CIDv0 与 CIDv1 的区别、兼容条件以及不能转换的边界。
学习目标
- 识别 CIDv0 和 CIDv1 的结构、编码方式及常见文本前缀。
- 使用 Kubo 将符合条件的 CIDv0 转为 CIDv1,并验证内容标识是否保持一致。
- 判断版本转换、重新编码与内容重新哈希之间的区别。
两种 CID 的结构与显示形式
CID(Content Identifier)是 IPFS 使用的内容标识符,包含用于识别内容的多哈希信息。CIDv0 是早期的受限格式,CIDv1 则将版本、内容编解码器和多哈希信息明确组合起来,支持更多编码与哈希算法。
| 比较项 | CIDv0 | CIDv1 |
|---|---|---|
| 版本字段 | 不显式存储 | 显式存储版本号 1 |
| 内容编解码器 | 隐含为 dag-pb |
通过 Multicodec 标识 |
| 哈希约束 | SHA2-256,32 字节摘要 | 支持多种 Multihash 算法 |
| 常见文本编码 | Base58btc,无 Multibase 前缀 | 常见为带 b 前缀的 Base32 小写形式 |
| 常见文本开头 | Qm |
bafy,但不固定 |
| 适用范围 | 传统 UnixFS / DAG-PB 内容 | DAG-PB、Raw 等多种内容编解码器 |
CIDv0 的二进制形式就是特定的 Multihash:哈希算法代码 0x12(SHA2-256)、摘要长度 0x20(32 字节),随后是 32 字节摘要。它没有独立的版本号或编解码器字段。
CIDv1 的逻辑字节结构依次为版本 Varint、Multicodec Varint、Multihash。Multihash 内部又包含哈希算法代码、摘要长度与摘要字节。转换时不能把这些字段当作普通字符串前缀进行拼接。
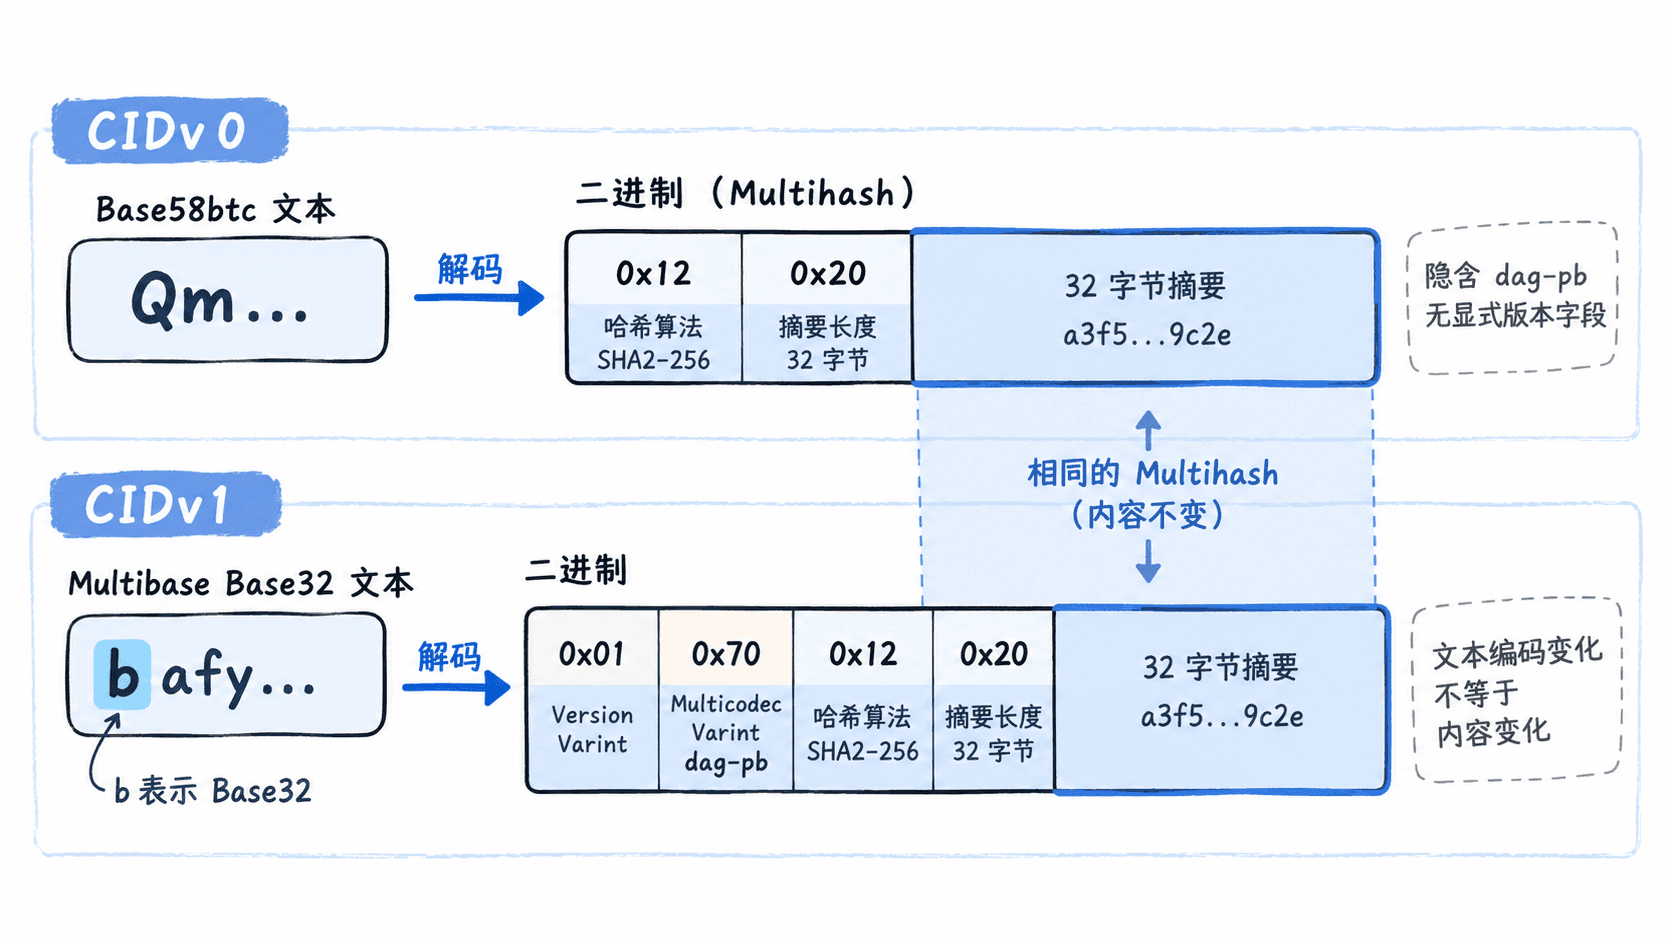
使用 Kubo 进行版本转换
准备已安装的 Kubo CLI,确认 ipfs 命令可用。本实验使用一个固定的、符合 CIDv0 约束的示例 CID,无须启动 IPFS 守护进程,也无须连接外部节点。
首先检查 Kubo 版本:
ipfs version预期输出格式如下,版本号随安装版本变化:
ipfs version <VERSION>下面以 QmYwAPJzv5CZsnAzt8auVTLG6dBvMQqKX6xM7MtnNfE9X8 为示例,使用 ipfs cid base32 生成 CIDv1 的 Base32 表示。该命令在支持 CID 子命令的 Kubo 版本中可用。
ipfs cid base32 QmYwAPJzv5CZsnAzt8auVTLG6dBvMQqKX6xM7MtnNfE9X8预期结果:输出一行以 bafy 开头的 CIDv1 字符串。转换过程保留原有 Multihash,并显式加入版本 1 和 dag-pb 编解码器信息;它不会读取文件内容重新计算摘要。
若希望明确指定 CID 版本与文本编码,可以使用 ipfs cid format:
ipfs cid format -v 1 -b base32 QmYwAPJzv5CZsnAzt8auVTLG6dBvMQqKX6xM7MtnNfE9X8预期结果:同样输出一个 Base32 编码的 CIDv1,和上一条命令表示相同的内容标识。
验证转换前后是否指向相同内容
判断两个 CID 是否等价,不能直接比较文本字符串。对于从 CIDv0 合法升级而来的 CIDv1,应同时检查内容编解码器和 Multihash,而不是只比较摘要中的一部分字节。
可以使用下面的 Python 3 标准库示例,对两个 CID 的文本编码和关键字段进行独立检查。脚本只处理 CIDv0 的 Base58btc 形式与 CIDv1 的 Base32 小写形式,并验证本实验使用的 SHA2-256、32 字节摘要格式。
import base64

ALPHABET = '123456789ABCDEFGHJKLMNPQRSTUVWXYZabcdefghijkmnopqrstuvwxyz'


def decode_base58(value):
    number = 0
    for char in value:
        number = number * 58 + ALPHABET.index(char)
    raw = number.to_bytes((number.bit_length() + 7) // 8, 'big')
    return b'\x00' * (len(value) - len(value.lstrip('1'))) + raw


def read_varint(data, offset):
    result = 0
    shift = 0
    while offset < len(data):
        byte = data[offset]
        offset += 1
        result |= (byte & 0x7f) << shift
        if byte < 128:
            return result, offset
        shift += 7
        if shift > 63:
            raise ValueError('Varint too long')
    raise ValueError('Incomplete Varint')


def parse_cid(value):
    if value.startswith('Qm'):
        data = decode_base58(value)
        version, codec, multihash = 0, 0x70, data
    elif value.startswith('b'):
        payload = value[1:].upper()
        payload += '=' * (-len(payload) % 8)
        data = base64.b32decode(payload)
        version, offset = read_varint(data, 0)
        codec, offset = read_varint(data, offset)
        multihash = data[offset:]
    else:
        raise ValueError('Unsupported CID text encoding')

    algorithm, offset = read_varint(multihash, 0)
    length, offset = read_varint(multihash, offset)
    digest = multihash[offset:]
    if length != len(digest):
        raise ValueError('Digest length mismatch')
    return version, codec, algorithm, digest


if __name__ == '__main__':
    cid0 = 'QmYwAPJzv5CZsnAzt8auVTLG6dBvMQqKX6xM7MtnNfE9X8'
    version, codec, algorithm, digest = parse_cid(cid0)
    print('CID version:', version)
    print('Codec is dag-pb:', codec == 0x70)
    print('SHA2-256:', algorithm == 0x12)
    print('Digest bytes:', len(digest))
预期输出:
CID version: 0
Codec is dag-pb: True
SHA2-256: True
Digest bytes: 32
将上面命令生成的 CIDv1 字符串赋值给 cid1,再在程序末尾加入 print(parse_cid(cid0)[1:] == parse_cid(cid1)[1:]),应输出 True。比较时跳过版本号,但保留编解码器、哈希算法与摘要,因此不会将不同内容类型误认为同一个 CID。
这段代码是针对本实验的简化解析器,不是完整的生产级 CID 实现。生产环境还需处理更多 Multibase 编码、Multihash 类型、规范化校验和异常输入。
什么时候可以转换,什么时候不能
CIDv0 升级为 CIDv1 有明确的结构条件:原 CID 必须是 dag-pb,使用 SHA2-256,并包含 32 字节摘要。满足条件时可以将原 Multihash 封装为 CIDv1,不需要下载内容,也不会修改底层数据块。
反方向转换限制更严格。只有 CIDv1 的 Multicodec 为 dag-pb,且 Multihash 是 SHA2-256、32 字节摘要时,才能表示为 CIDv0。即使 CIDv1 的字符串很短,也不代表可以降级。
| 操作 | 是否可行 | 原因 |
|---|---|---|
| 合规 CIDv0 转 CIDv1 | 可以 | 显式加入版本与 dag-pb 信息 |
dag-pb、SHA2-256 的合规 CIDv1 转 CIDv0 |
可以 | 满足 CIDv0 固定格式约束 |
raw 类型 CIDv1 转 CIDv0 |
不可以 | CIDv0 隐含的类型只能是 dag-pb |
| 使用其他哈希算法的 CIDv1 转 CIDv0 | 不可以 | CIDv0 固定使用 SHA2-256 |
| 同一 CIDv1 改用 Base36 或 Base32 | 可以 | 只改变文本编码,不改变 CID 二进制内容 |
区分版本变化与内容变化
在实际项目中,以下三种操作必须分别处理:
- 文本重新编码:同一 CIDv1 从 Base32 改为 Base36,二进制 CID 完全不变。
- CID 版本转换:CIDv0 转为 CIDv1,CID 二进制结构变化,但
dag-pb编解码器与 Multihash 保持不变。 - 重新导入或重新构建内容:改变分块器、Raw Leaves、目录包装方式或文件内容,都可能产生不同的 DAG 结构和根 CID。
例如,同一文件分别使用 --cid-version=0 和 --cid-version=1 导入时,如果 DAG-PB 编码、分块方式及其他构建参数均保持一致,可能只发生 CID 表示形式的变化。但 Kubo 的 CIDv1 导入设置可能启用 Raw Leaves,因此不能仅凭文件字节相同就断言根 CID 的 Multihash 一定相同。
做迁移验证时,应先检查两个 CID 是否具有相同的 Multicodec 和 Multihash,再按需读取内容验证。如果两个 CID 只是合规的版本转换,通常可以视为同一内容块的两种标识形式;如果 Multihash 或 Multicodec 不同,就需要进一步检查 DAG 构建参数,而不是简单判定文件内容已被修改。
对于 API、数据库和缓存键,建议统一使用 CIDv1 Base32 小写文本作为规范表示,同时在兼容层接受合法的 CIDv0 输入。这样既便于与现代 IPFS 工具和网关路径配合,也能避免同一内容标识因文本形式不同而产生重复记录。