
P2P 与分布式存储 / 系统课时
解释相同文件出现不同 CID 的原因
解释相同文件出现不同 CID 的原因
同一个文件使用 Kubo 导入 IPFS,可能得到不同的 CID,即使文件内容一个字节都没有变化。本课通过固定文件内容、分别修改 CID 版本、分块大小与 DAG 布局,复现 CID 差异,并判断差异来自编码表示还是底层数据变化。
学习目标
- 使用 Kubo 命令复现相同文件生成不同 CID 的现象。
- 区分 CID 文本编码、Multicodec、分块策略和 DAG 布局造成的差异。
- 使用
ipfs cid、ipfs dag和文件哈希验证内容是否一致。
CID 标识的是哪个对象
CID(Content Identifier)标识一个经过特定编码的 IPLD 数据块。它包含内容类型与多哈希等信息,并不总是原始文件字节的直接哈希。
Kubo 使用 UnixFS 导入普通文件时,可能把文件组织为单个数据块,也可能将文件拆成多个块并建立 DAG。文件的根 CID 标识 DAG 根块,而不是抽象意义上的文件名或文件路径。
需要区分三个层次:
| 层次 | 比较对象 | 可能变化的因素 |
|---|---|---|
| 原始文件 | 文件字节序列 | 实际内容 |
| IPLD 数据块 | 编码后的块字节 | UnixFS 编码、分块、DAG 布局 |
| CID 表示 | 版本、Codec、Multihash、文本编码 | CID 版本、Multibase |
例如,两个 CID 可以使用不同的 Multibase 文本表示,却指向相同的内容标识;也可能因为 DAG 根块编码不同而具有不同的多哈希。
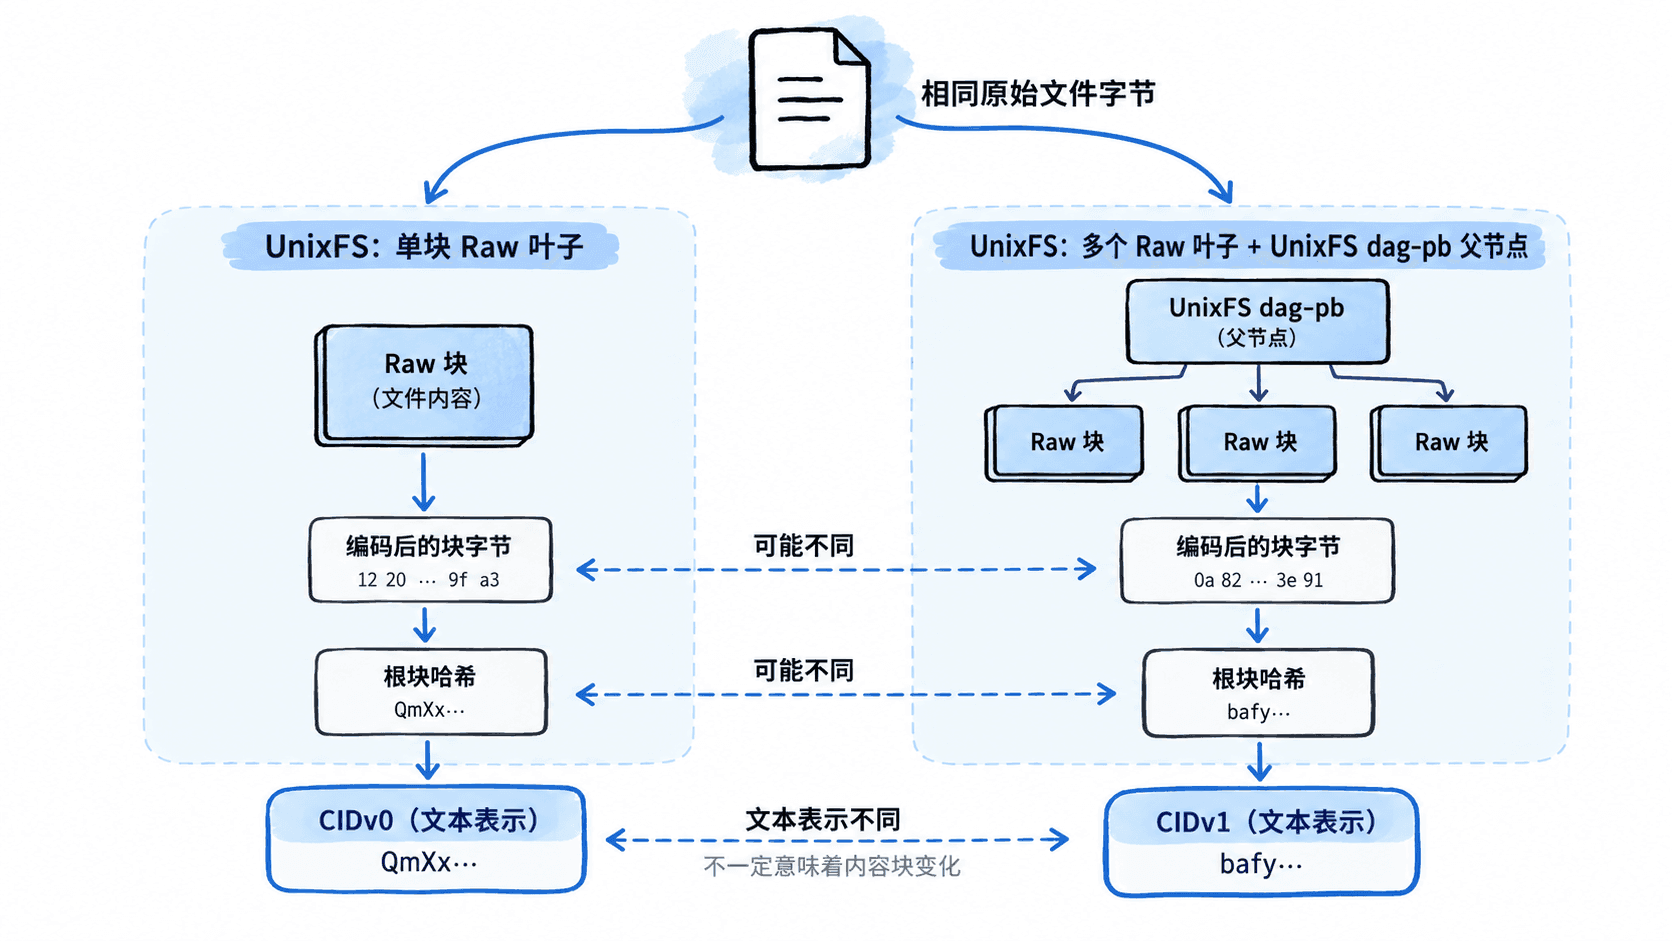
固定文件并比较 CID 版本
以下实验使用 Kubo CLI,适用于支持 ipfs add --cid-version、ipfs cid 和 ipfs dag 的常见 Kubo 版本。需要已经执行 ipfs init,并确认 ipfs version 能正常返回版本号。ipfs add --only-hash 可仅计算导入结果,不必启动守护进程,也不会把计算出的块持久保存到仓库。
先创建完全确定的测试文件。以下命令适用于安装了 Python 3 与 Kubo 的 Bash 环境。
python3 -c 'from pathlib import Path; Path("hello.txt").write_bytes(b"hello ipfs\n")'
sha256sum hello.txt
ipfs add --only-hash --cid-version=0 -Q hello.txt
ipfs add --only-hash --cid-version=1 -Q hello.txt预期结果:sha256sum 返回一个固定的 64 位十六进制摘要,两条 ipfs add 分别输出 CIDv0 和 CIDv1;实际 CID 字符串以本机结果为准。CIDv0 通常以 Qm 开头,默认 Base32 表示的 CIDv1 通常以 bafy 开头。
这里的版本变化需要谨慎解释:CIDv0 隐含 dag-pb Codec 与 SHA2-256 多哈希,而 CIDv1 显式记录版本和 Codec。对于默认导入的小文件,Kubo 可能在两种版本下采用不同的叶子编码,因此不能直接认定两条命令仅改变了 CID 外层表示。
要隔离 CID 版本因素,可以固定 UnixFS 编码配置,再转换同一个 CID:
CID=$(ipfs add --only-hash --cid-version=0 -Q hello.txt)
ipfs cid base32 "$CID"
ipfs cid format -v 1 -b base32 "$CID"
预期结果:两条转换命令返回同一个 Base32 CIDv1 字符串,前提是所用 Kubo 版本支持这些子命令。它们没有重新导入文件,也没有修改 CID 所含的多哈希摘要,只改变 CID 的版本或文本表示。
修改分块大小与 DAG 布局
对较大的文件,分块策略会改变 DAG 结构。为了保证实验可复现,生成一个 1 MiB 文件,并分别使用 256 KiB 与 512 KiB 的固定分块大小。这里显式指定 CIDv1、Raw 叶子与 Balanced 布局,避免默认参数干扰。
python3 -c 'from pathlib import Path; Path("sample.bin").write_bytes(bytes(range(256)) * 4096)'
sha256sum sample.bin
CID_A=$(ipfs add --only-hash -Q --cid-version=1 --raw-leaves=true --chunker=size-262144 --trickle=false sample.bin)
CID_B=$(ipfs add --only-hash -Q --cid-version=1 --raw-leaves=true --chunker=size-524288 --trickle=false sample.bin)
printf '256KiB: %s\n512KiB: %s\n' "$CID_A" "$CID_B"
预期结果:文件 SHA-256 保持不变,两个根 CID 通常不同。前一种配置将 1 MiB 文件分为 4 个 256 KiB 叶子块,后一种分为 2 个 512 KiB 叶子块;父节点记录的链接集合不同,根块编码及其哈希随之变化。
| 参数 | 配置 A | 配置 B |
|---|---|---|
--cid-version |
1 | 1 |
--raw-leaves |
true | true |
--chunker |
size-262144 | size-524288 |
--trickle |
false | false |
| 叶子块数量 | 4 | 2 |
| 原始文件大小 | 1048576 B | 1048576 B |
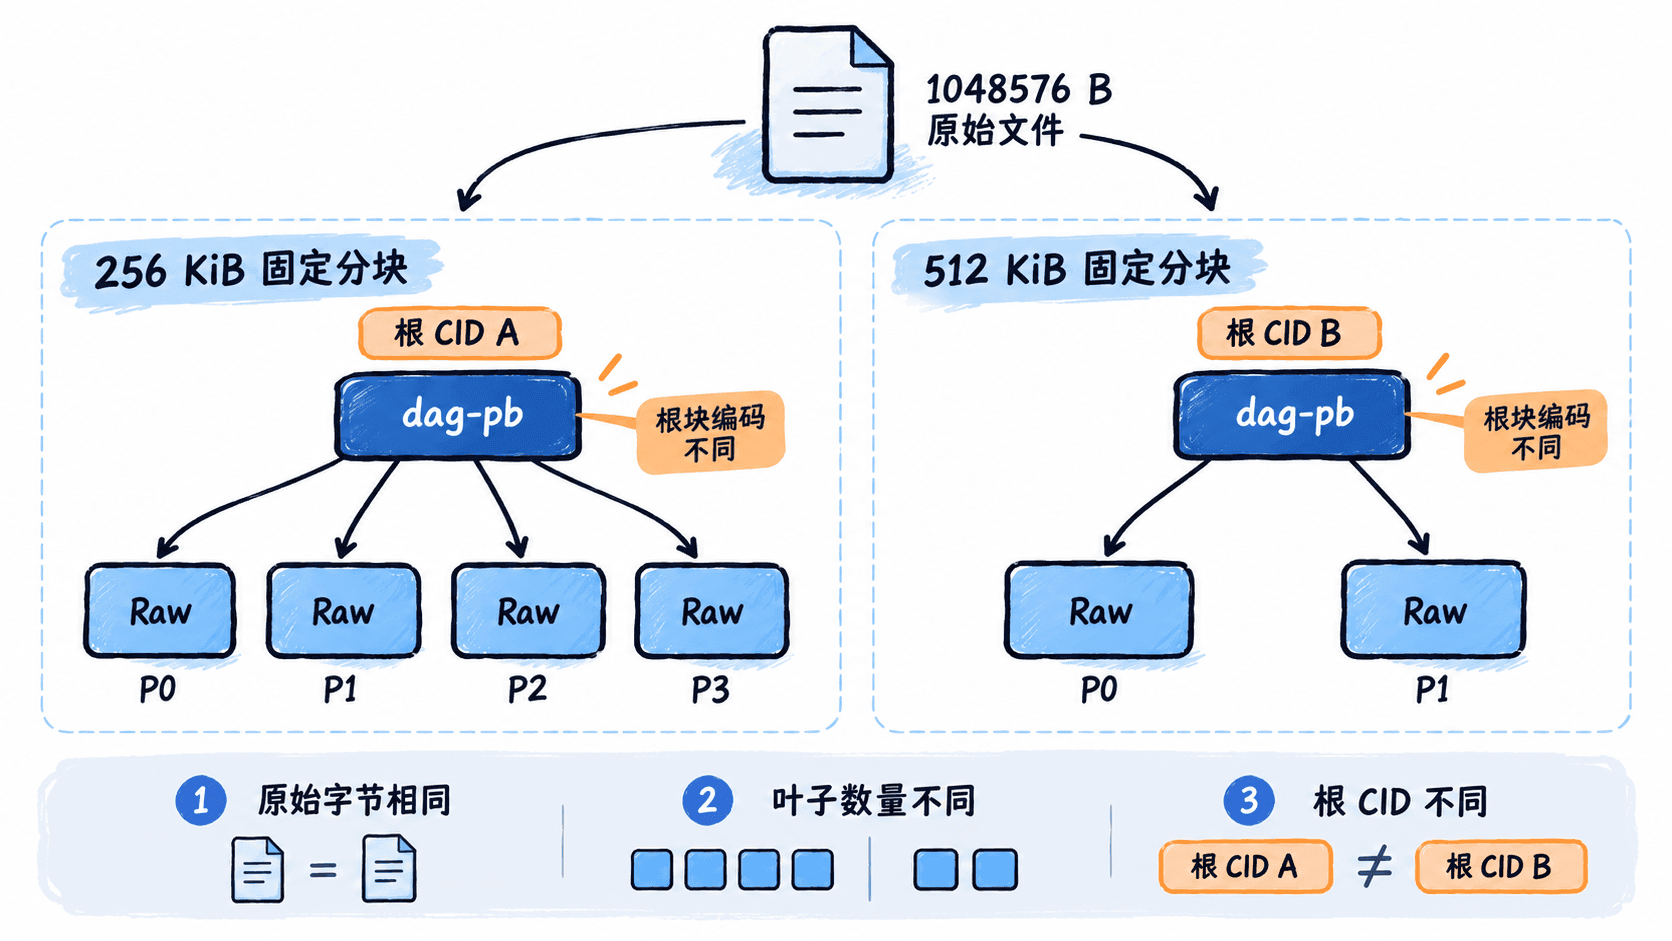
Balanced 和 Trickle 是另一组布局选择。可将 --trickle=false 改为 --trickle=true 再运行一次,但是否得到不同根 CID 取决于文件规模和实际 DAG 结构;小文件或尚未触发布局差异的文件可能得到相同结果。
查看 DAG 并验证文件内容
前面的 --only-hash 不会保存块,因此要用实际导入来检查 DAG 和读取文件。继续使用同一个 sample.bin,去掉 --only-hash,并在本地仓库导入两个版本。
CID_A=$(ipfs add -Q --cid-version=1 --raw-leaves=true --chunker=size-262144 --trickle=false sample.bin)
CID_B=$(ipfs add -Q --cid-version=1 --raw-leaves=true --chunker=size-524288 --trickle=false sample.bin)
ipfs dag stat "$CID_A"
ipfs dag stat "$CID_B"
ipfs cat "$CID_A" > restored-a.bin
ipfs cat "$CID_B" > restored-b.bin
sha256sum sample.bin restored-a.bin restored-b.bin
cmp sample.bin restored-a.bin
cmp sample.bin restored-b.bin
预期结果:两个 ipfs dag stat 命令均返回对应 DAG 的统计信息,统计字段随 Kubo 版本可能不同;sha256sum 的三行摘要完全一致,两个 cmp 命令均不输出内容且退出码为 0。ipfs cat 能读取本地已保存的 UnixFS 文件内容,不要求连接远程 Peer。
这组验证建立了两个独立结论:根 CID 不同,说明内容寻址对象的编码结构不同;恢复后的文件哈希一致,说明两个 DAG 解码得到的原始文件字节一致。
若 ipfs cat 报告找不到块,应先检查是否只运行了 --only-hash,或者实际导入是否成功。若 cmp 报告差异,应检查是否修改了输入文件、导入的是否为同一文件,以及是否把其他命令输出混入了恢复文件。
排查相同文件 CID 不一致
实际项目中可以按下面顺序定位,不要一开始就认定发生了数据损坏。
- 使用
sha256sum比较两个原始文件,先排除换行符、BOM、编码转换和文件内容变化。 - 使用
ipfs cid format -f '%V %c %h' <CID>检查版本、Codec 和哈希算法;这里的<CID>需替换为真实 CID,且应先用本机帮助命令确认格式占位符支持情况。 - 比较
--chunker、--raw-leaves、--trickle和--cid-version,同时确认是否启用了目录包装、文件元数据或其他导入选项。 - 对已导入的对象使用
ipfs dag stat查看 DAG 规模,再使用ipfs cat导出内容并计算 SHA-256。 - 如果是目录 CID,额外核对文件名、路径、目录条目及元数据;即使内部文件字节不变,目录根 CID 也可能变化。
如果两个文件的 SHA-256 一致但根 CID 不同,应记录完整导入参数、Kubo 版本和根 CID,再检查 DAG 编码差异。若需要跨设备生成可复现的 CID,就必须统一文件字节、CID 版本、Codec、分块策略、叶子编码、DAG 布局及相关元数据,而不能只约定使用相同的文件名。