
P2P 与分布式存储 / 系统课时
使用 Helia 从前端获取内容
使用 Helia 从前端获取内容
本课使用 Helia、UnixFS 和 HTTP 检索模块构建一个浏览器文件读取页面。读者输入已发布的 CID,即可获取并显示文件内容,同时通过浏览器开发者工具观察委托路由、区块获取和完整性验证,判断为什么本地存在的文件不一定能被前端取回。
学习目标
- 使用 Helia 7.x 和 UnixFS API 在浏览器中按 CID 读取文件。
- 区分委托路由、浏览器可用传输和 Trustless Gateway 的职责。
- 通过 Network 面板定位内容不可达、跨域限制和读取超时。
准备可被远端读取的 CID
实验需要一个已经发布、能够从其他节点取回的 UTF-8 文本文件。CID 是内容标识符,不包含文件所在服务器的位置;浏览器必须通过路由服务或网关找到可提供数据的来源。
如果已拥有公开可读取的文件 CID,可以直接使用。否则,在安装并启动 Kubo 的机器上打开 Bash 终端,确保本地 IPFS API 可用,然后执行:
printf 'Hello IPFS\n' > hello.txt
ipfs add --cid-version=1 hello.txt
预期输出格式:
added <CID> hello.txt其中 <CID> 是实际生成的内容标识符。使用上述 Bash 命令时,文件内容包含末尾换行,共 11 字节。将输出的 CID 保存下来,后续粘贴到浏览器输入框。
创建浏览器 Helia 工程
本例使用 Vite 的原生 JavaScript 模板,不依赖 React 或 Vue。推荐使用满足当前 Vite 要求的 Node.js 版本,例如 Node.js 22.12 或更新的受支持版本,并配合 Helia 7.x、@helia/http 4.x 和 @helia/unixfs 8.x。
在终端执行:
npm create vite@latest helia-browser-demo -- --template vanilla
cd helia-browser-demo
npm install
npm install helia@^7 @helia/http@^4 @helia/unixfs@^8 multiformats
预期结果:生成包含 index.html、main.js 和 package.json 的 Vite 工程,依赖安装成功。安装进度、包数量和耗时取决于本机环境。
本例采用以下模块分工:
| 模块 | 具体职责 |
|---|---|
helia |
创建和管理 Helia 节点,提供块存储与节点生命周期接口 |
@helia/http |
配置 HTTP 委托路由和 Trustless Gateway 区块获取能力 |
@helia/unixfs |
按 UnixFS 文件结构解析 CID,并以字节流读取文件 |
multiformats/cid |
将用户输入的 CID 字符串解析为 CID 对象 |
这里使用 createHeliaLight() 创建轻量节点,再通过 withHTTP() 配置 HTTP 检索能力。Helia 7.x 的节点创建函数返回尚未启动的实例,需要显式调用 .start();不要直接照搬旧版 createHeliaHTTP() 示例。具体接口可核对 Helia HTTP 官方示例。
编写前端 CID 读取页面
首先替换工程根目录的 index.html。页面只需要 CID 输入框、读取按钮和结果区域。结果使用文本节点显示,不将从 IPFS 读取的数据直接解释为 HTML。
<!doctype html>
<html lang="zh-CN">
  <head>
    <meta charset="UTF-8" />
    <meta name="viewport" content="width=device-width, initial-scale=1.0" />
    <title>Helia 内容检索实验</title>
  </head>
  <body>
    <main>
      <h1>Helia 内容检索</h1>
      <label for="cid">文件 CID</label>
      <input id="cid" placeholder="输入已发布的文件 CID" />
      <button id="load">读取内容</button>
      <pre id="result" aria-live="polite"></pre>
    </main>
    <script type="module" src="/main.js"></script>
  </body>
</html>
预期结果:页面包含一个 CID 输入框、一个读取按钮和一个用于展示文件内容的区域。接下来编写事件处理逻辑,使按钮真正执行检索。
将工程根目录的 main.js 完整替换为以下代码:
import { createHeliaLight } from 'helia'
import { withHTTP } from '@helia/http'
import { unixfs } from '@helia/unixfs'
import { CID } from 'multiformats/cid'

// 使用 HTTPS 路由服务和 Trustless Gateway,避免依赖浏览器不支持的原生 TCP 连接。
const helia = await withHTTP(createHeliaLight(), {
  delegatedRouters: ['https://delegated-ipfs.dev'],
  recursiveGateways: ['https://trustless-gateway.link']
}).start()

const fs = unixfs(helia)
const result = document.querySelector('#result')

// 只演示小型 UTF-8 文本文件,避免把任意大文件全部加载到页面内存。
document.querySelector('#load').addEventListener('click', async () => {
  result.textContent = '检索中...'

  try {
    const value = document.querySelector('#cid').value.trim()
    const cid = CID.parse(value)
    const decoder = new TextDecoder()
    let content = ''
    let size = 0

    // cat 返回异步字节流;流式解码可正确处理跨区块的 UTF-8 字符。
    for await (const chunk of fs.cat(cid, {
      signal: AbortSignal.timeout(20_000)
    })) {
      size += chunk.byteLength
      if (size > 65_536) {
        throw new Error('文件超过 64 KiB 演示上限')
      }
      content += decoder.decode(chunk, { stream: true })
    }

    content += decoder.decode()
    result.textContent = `已读取 ${size} 字节\n${content}`
  } catch (error) {
    result.textContent = `读取失败:${error.message}`
  }
})
预期结果:输入合法且可取回的文件 CID 后,页面显示实际读取的字节数与文本内容。输入无效 CID、遇到读取失败或超过 20 秒的超时限制时,页面显示相应错误。示例限制读取量为 65,536 字节,不适合直接用于大文件下载。
启动开发服务器:
npm run dev预期输出包含 Vite 开发服务器的本地访问地址,形式通常为 http://localhost:<PORT>/。其中 <PORT> 为实际端口,可能因占用情况而变化。
打开终端显示的地址,粘贴准备好的 CID,点击“读取内容”。如果使用前面生成的文件并且远端提供条件满足,页面预期显示:
已读取 11 字节
Hello IPFS
Hello IPFS 后仍有文件自带的换行。若使用其他 CID,字节数和内容应与对应文件实际数据一致。
观察浏览器内的内容检索路径
浏览器不能像普通 Kubo 节点那样直接使用任意原生 TCP 或 QUIC 连接。本实验的 HTTP 模式依赖浏览器支持的 HTTPS 请求,并将内容发现和实际区块获取分开处理。
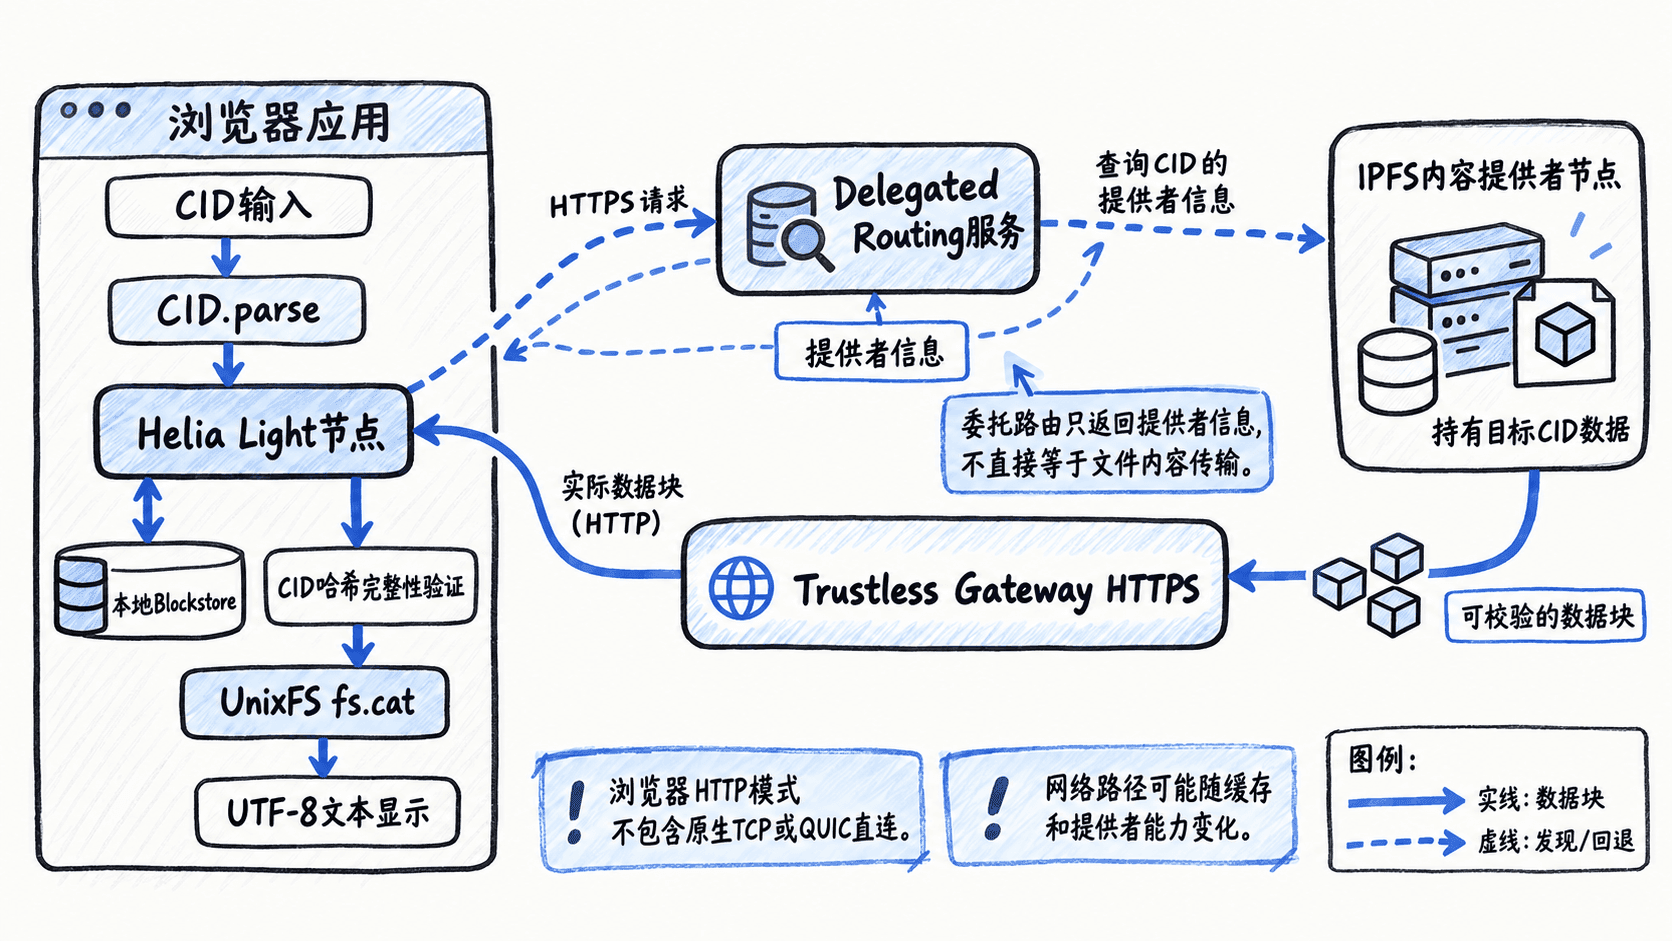
读取过程中主要发生以下工作:
CID.parse()解析输入标识符,fs.cat()请求对应的 UnixFS 文件内容。- Helia 检查本地块存储;缺少的区块需要通过已配置的网络获取能力寻找。
- 委托路由服务能够返回内容提供者信息,帮助客户端定位候选来源;它不负责直接返回完整文件。
- HTTP 区块获取模块尝试使用可通过 HTTPS 访问的来源,必要时由递归 Trustless Gateway 获取区块。
- 取得的数据按 CID 所包含的哈希信息验证,UnixFS 解析文件结构,最后由
TextDecoder还原文本。
注意:以上描述的是职责关系,而非每次读取都必须严格执行的网络请求序列。命中本地缓存、直接使用可访问的 HTTP 来源或者使用网关回退时,实际请求种类和顺序可能不同。本例也没有启用浏览器与远端节点之间的 libp2p Bitswap 直连。
打开浏览器开发者工具并观察:
- 在 Chrome 或 Edge 中按
F12,进入Network面板。 - 勾选
Disable cache,刷新页面以重新创建 Helia 节点。 - 保持
All或Fetch/XHR过滤器可见,输入 CID 并点击读取。 - 查看请求主机、请求状态和响应类型,重点观察
delegated-ipfs.dev、trustless-gateway.link或其他实际参与的 HTTPS 内容来源。 - 结合
Console面板中的错误信息,判断请求是否因跨域、安全策略、网络超时或缺少提供者而失败。
单次成功读取不保证必定出现两种服务的请求,也不能通过网关的 HTTP 200 状态单独证明客户端完成了 CID 验证。应结合 Helia 是否成功解析并返回目标文件,以及实际网络请求路径判断。
定位浏览器检索失败
排错时先区分输入错误、提供者发现失败和数据传输失败,再检查浏览器安全限制。不要只看到 Failed to fetch 就断定 CID 不存在。
| 现象 | 优先检查 | 修复方式 |
|---|---|---|
| 输入后立即提示 CID 无效 | CID 是否完整、是否混入路径或空格 | 输入纯 CID,不要粘贴完整网关 URL |
| 长时间检索后超时 | 提供者是否在线,数据是否可从独立节点读取 | 检查 Pin、提供者公告、网络连通性及网关是否能够获取目标内容 |
| Network 出现 CORS 错误 | 远端 HTTPS 服务的跨域响应头 | 换用允许浏览器跨域访问的路由服务或 Trustless Gateway |
| HTTPS 页面请求被阻止 | 是否使用 HTTP 服务或不受支持的地址 | 使用可访问的 HTTPS 端点,避免混合内容限制 |
| CID 可解析但读取失败 | CID 是否指向目录、数据是否完整、传输是否中断 | 换成具体文件 CID,检查缺失区块和来源可达性 |
| 页面显示超过大小限制 | 文件是否大于 65,536 字节 | 改用流式文件下载,不在页面中拼接完整文本 |
可以进行一个对照实验:先使用已知可取回的 CID 成功读取,再断开浏览器网络并刷新页面,重新读取同一 CID。由于刷新通常会重建本例的内存块存储,新页面无法再从网络取回尚未缓存的数据,应出现网络相关失败或超时。实验前后要保持 CID 不变,避免把内容变化误认为网络故障。
在实际应用中,可以按组件生命周期复用 Helia 实例,并在确定不再使用时调用 helia.stop() 释放资源。对于二进制文件,应保留原始字节并使用流式处理,不能一律通过 TextDecoder 当作文本展示;对于不可信 HTML 内容,应继续使用 textContent 或经过严格处理后再渲染。
本实验的验收标准是:输入公开可取回的文件 CID 后,浏览器显示与原文件一致的内容;开发者能够在 Network 面板识别实际 HTTP 请求来源,并能区分 CID 有效、提供者可发现和文件真正可取回这三个不同条件。