
P2P 与分布式存储 / 系统课时
通过 IPLD 解析跨块引用
通过 IPLD 解析跨块引用
当 IPFS 中的文件被拆成多个内容块时,仅查看单个 CID 无法知道这些块如何连接。本课使用 Kubo 的 IPLD 相关命令读取编码块、识别链接字段,并沿链接访问子节点,最终理解 UnixFS 文件结构与通用 Merkle DAG 数据模型之间的关系。
学习目标
- 区分 IPLD 数据模型、Codec、CID 与跨块链接的职责。
- 使用 Kubo 命令查看 DAG 节点及其子块引用。
- 识别 UnixFS 的文件元数据与 IPLD 链接,验证跨块引用的完整性。
IPLD 如何表示跨块引用
IPLD(InterPlanetary Linked Data)为内容寻址数据提供通用的数据模型。一个节点可以包含字符串、整数、列表、映射等数据,也可以通过 Link 类型引用另一个节点。链接目标由 CID 标识,而不是依赖某台服务器上的文件路径。
CID 标识内容块,并携带 Multicodec 等编码信息;Codec 决定如何把块字节解码为数据模型中的值。常见编码包括 dag-pb(Multicodec 代码 0x70)、dag-cbor(0x71)和 raw(0x55)。它们的结构与链接表示方式并不完全相同。
例如,一个 UnixFS 文件根节点可能是 dag-pb 编码的 PBNode,包含文件元数据和指向数据子块的 PBLink。读取根节点时只取得根节点自身的编码字节;要获取完整文件,还需要解析链接并读取相应子块。
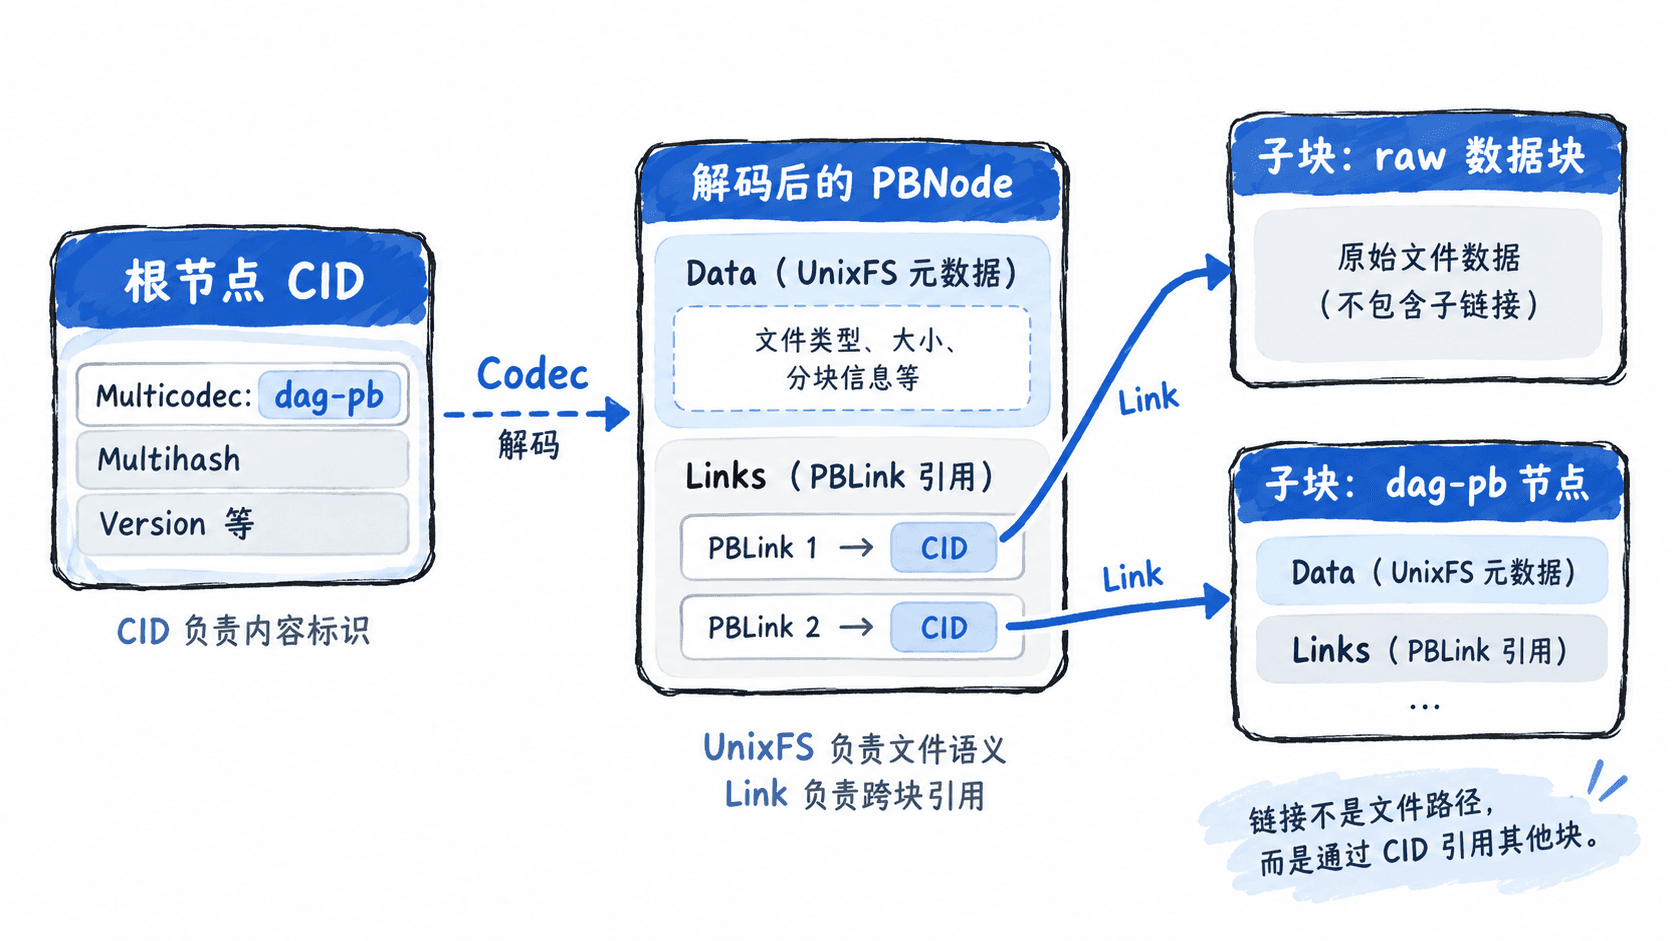
这里要区分两个层次:IPLD 解决内容数据及其链接如何表示和遍历的问题;UnixFS 则在具体编码结构上定义文件、目录、文件大小和数据块组织等文件系统语义。IPLD 本身不要求节点一定表示文件。
创建可供解析的多块文件
以下实验适用于安装了 Kubo CLI、已经执行 ipfs init 的环境。使用 Python 3 生成约 1 MiB 的确定性测试数据,再通过 Kubo 导入。为了让 DAG 结构可复现,指定 CIDv1、256 KiB 分块和 balanced 布局。
python3 -c 'from pathlib import Path; Path("ipld-demo.bin").write_bytes(bytes(range(256)) * 4096)'
ipfs add --cid-version=1 --chunker=size-262144 --trickle=false ipld-demo.bin
预期结果:输出一行 added 记录,包含实际生成的根 CID 和文件名,例如:
added <CID> ipld-demo.bin其中 <CID> 代表实际输出的 CID,并非字面值。该文件大小为 1048576 字节,固定分块大小为 262144 字节,因此文件数据对应四个叶子块。默认 balanced 布局会构建包含这些数据块引用的文件 DAG;根节点的具体编码与链接数量应以实际输出为准。
后续命令使用真实根 CID。可以先在终端执行 ipfs add 并复制其输出中的 CID,再替换示例里的 <CID>。如需通过 RPC 查询本地节点,请先在另一个终端执行 ipfs daemon;上述本地仓库操作通常不要求守护进程持续运行。
读取节点并识别链接
使用 ipfs dag get 可以按 IPLD 路径读取节点,默认输出 JSON 形式的数据表示。对于 dag-pb 节点,通常能够看到 Data 与 Links 字段,其中 Links 保存 PBLink 的目标 CID、名称和大小信息。
ipfs dag get <CID>预期结果:返回一个 JSON 对象,包含根节点的数据字段及链接数组。具体 CID、链接数量、编码字节表示随导入结果和 Kubo 版本而异。对于本实验生成的非空 UnixFS 文件根节点,重点检查 Links 是否包含子块引用。
接着使用 ipfs ls 查看 UnixFS 解释后的链接信息:
ipfs ls <CID>预期结果:列出文件 DAG 根节点下的链接条目及其大小。普通文件分块的链接名称可能为空,因此不能把链接名称当成文件名,也不能仅凭链接名称判断块的用途。
两个命令的观察层次不同:ipfs dag get 面向编码后的 IPLD 节点数据,ipfs ls 则面向 UnixFS 文件结构。ipfs dag get 展示的 Data 字段不等于完整文件内容;在 dag-pb 文件节点中,它可能包含序列化的 UnixFS protobuf 元数据。
沿 CID 访问子块
跨块引用的实际用途是从父节点取得子节点 CID,再读取子节点内容。对于上述默认 balanced 文件布局,可以使用 ipfs dag get 的路径语法访问链接数组中的第一个目标。
ipfs dag get <CID>/Links/0/Hash预期结果:显示第一个链接所引用的 CID。路径中的 Links/0/Hash 是针对 dag-pb 节点结构的字段访问,不是所有 IPLD Codec 都通用的路径。
也可以直接使用 ipfs block stat 检查一个实际存在的块:
ipfs block stat <CID>预期结果:返回根块的 Key 和 Size 信息。这里的 Size 是根块编码后的字节数,不是整个文件的逻辑大小;对多块文件而言,两者通常不同。
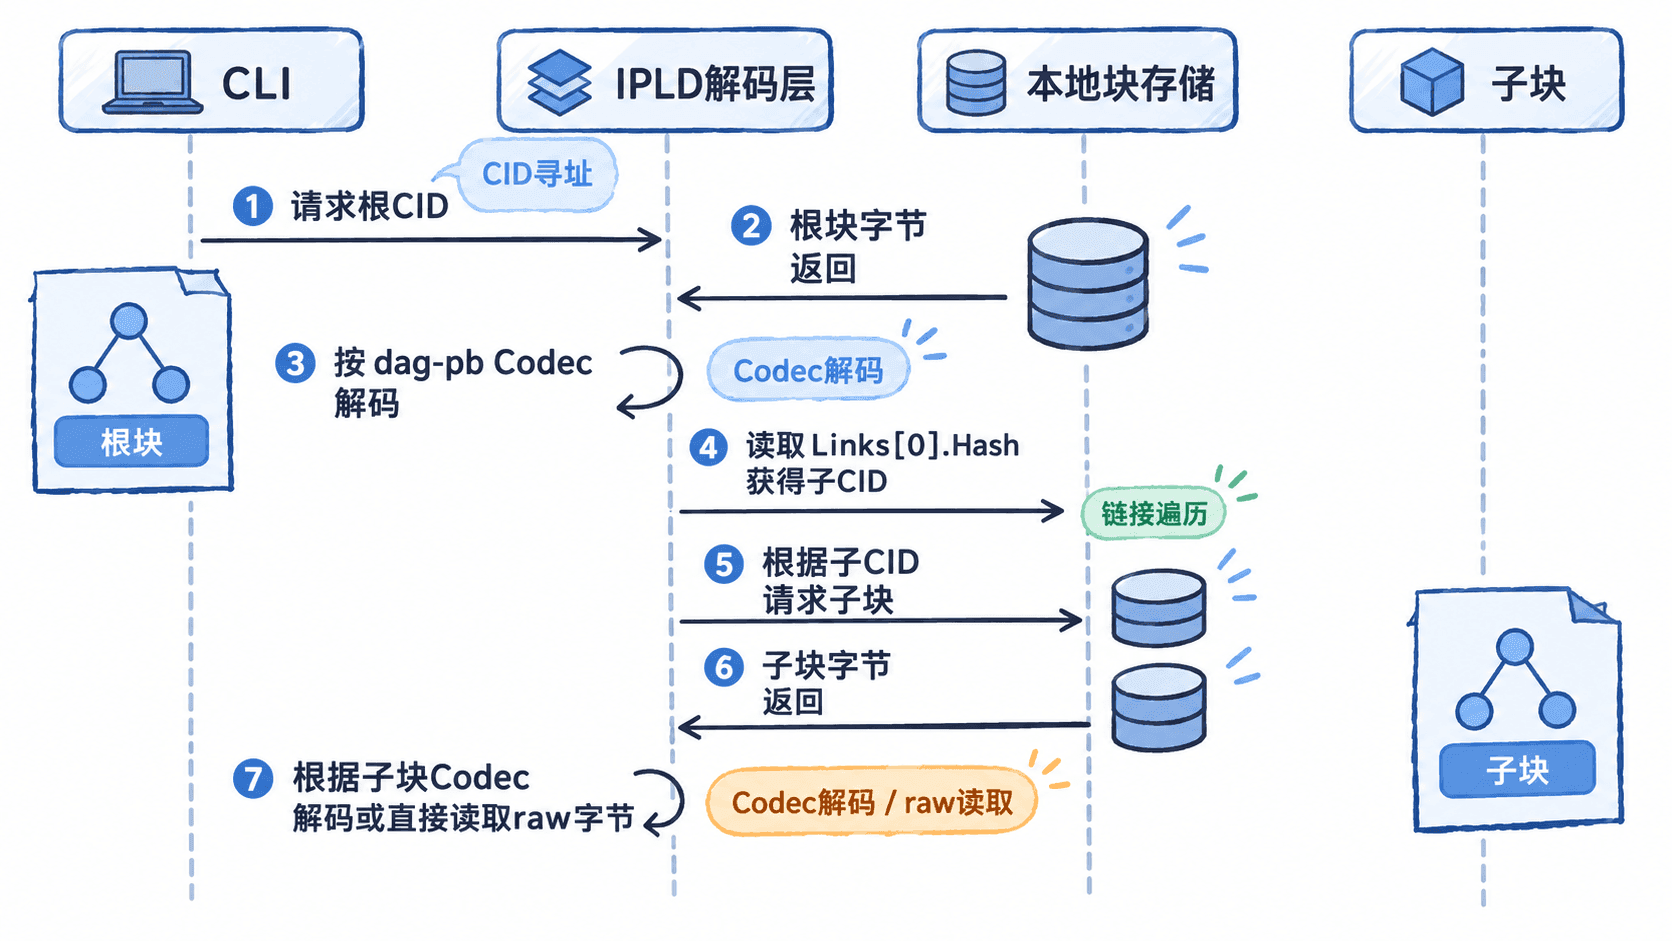
在实际应用中,读取链接目标可能先检查本地块存储;如果本地没有该块,支持网络获取的 IPFS 操作还可能尝试从其他节点检索。IPLD 数据模型只规定链接语义,并不保证链接目标一定可用,也不负责规定网络发现和传输策略。
验证 UnixFS 文件与原始数据一致
最后使用 ipfs cat 按 UnixFS 语义遍历文件 DAG,并把结果重组为连续字节流。与读取单个块不同,这个命令会按照文件结构处理相关子块。
ipfs cat <CID> > ipld-restored.bin
python3 -c 'import hashlib; from pathlib import Path; a=Path("ipld-demo.bin").read_bytes(); b=Path("ipld-restored.bin").read_bytes(); print("bytes:",len(b)); print("sha256_equal:",hashlib.sha256(a).digest()==hashlib.sha256(b).digest())'
预期输出:
bytes: 1048576
sha256_equal: True
如果 ipfs dag get 能读取根节点,但 ipfs cat 失败,应检查链接目标块是否存在、是否能够获取,以及 UnixFS 元数据是否有效。根节点可读取不代表所有后代块均已保存;只有完成必要的链接遍历与文件重组,才能确认整个文件可用。
本实验中,IPLD 提供了从根节点到子节点的内容链接机制,dag-pb 负责节点编码,UnixFS 负责解释文件分块与重组规则。理解这三层的区别后,便能判断读取的是单个编码块、一个 DAG 节点,还是完整的文件内容。