
P2P 与分布式存储 / 系统课时
按 CID 构建应用检索接口
按 CID 构建应用检索接口
业务系统通常按文件 ID 查找附件,而 IPFS 使用 CID 标识不可变内容。本课实现一个从业务文件 ID 到 CID 的检索接口,完成元数据查询、文件读取和版本更新,并验证旧版本仍可按原 CID 访问的条件。
学习目标
- 设计业务文件 ID、版本号与 CID 的映射关系。
- 使用 FastAPI 和 Kubo HTTP RPC 实现文件检索接口。
- 验证文件更新后的索引切换、内容完整性与错误处理。
设计业务索引与内容寻址的边界
CID 由内容块及其编码结构决定,不能当作会自动更新的业务文件 ID。例如用户上传合同后,业务系统分配 contract-001,首次内容对应 CID A;合同修改后产生 CID B,但业务 ID 保持不变。
建议将当前版本索引与历史版本分开保存:
| 数据字段 | 示例 | 用途 |
|---|---|---|
| file_id | contract-001 | 稳定的业务标识 |
| current_version | 2 | 当前版本号 |
| cid | bafy... | 当前版本内容地址 |
| version | 1、2 | 历史版本编号 |
| size_bytes | 1024 | 业务侧记录的文件字节数 |
生产环境可使用 files(file_id, current_version) 与 file_versions(file_id, version, cid, size_bytes) 两张表,其中历史表以 (file_id, version) 为联合主键。当前版本切换和历史记录写入应在同一个数据库事务中完成,避免索引指向不存在的版本记录。
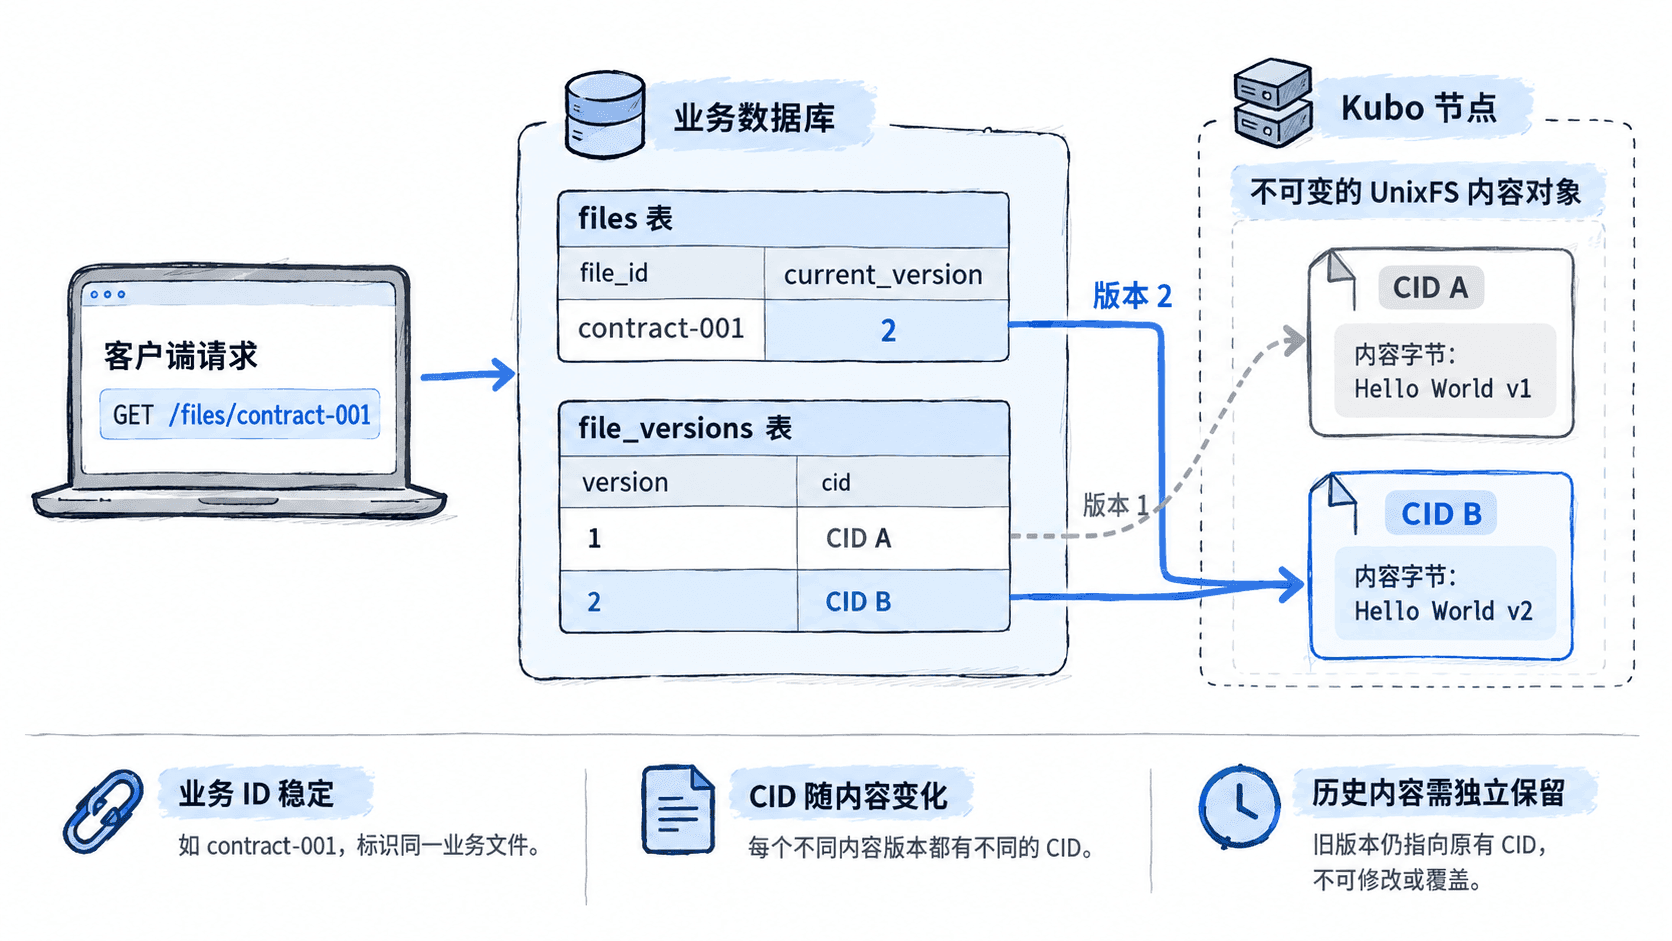
这里需要区分三个操作:按业务 ID 获取当前版本、按业务 ID 与版本号获取历史版本、直接按 CID 获取内容。业务权限应绑定用户和文件记录,而不是仅依赖 CID 的不可猜测性。
实现按业务 ID 检索文件
下面使用 Python 3.11+、FastAPI、Uvicorn 和本地 Kubo 节点构建最小示例。假设 Kubo HTTP RPC 监听 127.0.0.1:5001,示例只供本机开发使用,不要将 RPC 端口直接暴露到公网。
安装依赖并确认 Kubo 已启动:
python -m pip install fastapi uvicorn httpx
ipfs id预期结果:依赖安装成功,ipfs id 返回包含 ID、Addresses 等字段的节点信息。节点标识和地址因环境不同而变化;如果命令无法连接守护进程,应先在另一个终端运行 ipfs daemon。
创建 app.py,使用内存字典模拟数据库,重点展示检索路径和错误边界。示例中的 CID 由后续实际导入文件得到,不使用虚构的固定哈希。
import os
from urllib.parse import quote

import httpx
from fastapi import FastAPI, HTTPException
from fastapi.responses import Response

app = FastAPI()
RPC = os.getenv('IPFS_RPC_URL', 'http://127.0.0.1:5001')
files = {}
versions = {}

@app.get('/files/{file_id}')
async def get_file(file_id: str, version: int | None = None):
    record = files.get(file_id)
    if record is None:
        raise HTTPException(404, 'file not found')

    target = record['current_version'] if version is None else version
    item = versions.get((file_id, target))
    if item is None:
        raise HTTPException(404, 'version not found')

    # CID来自服务端版本索引,不接受任意路径拼接。
    cid = item['cid']
    try:
        async with httpx.AsyncClient(timeout=30.0) as client:
            result = await client.post(
                f'{RPC}/api/v0/cat',
                params={'arg': cid},
            )
            result.raise_for_status()
    except httpx.HTTPError:
        raise HTTPException(502, 'IPFS retrieval failed')

    # 演示使用内存响应;大文件应改为流式传输。
    return Response(
        content=result.content,
        media_type='application/octet-stream',
        headers={'X-Content-CID': cid},
    )
启动服务:
uvicorn app:app --host 127.0.0.1 --port 8000预期结果:终端显示 Uvicorn 已启动并监听 http://127.0.0.1:8000。此时尚未建立文件索引,请求 /files/contract-001 会返回 HTTP 404,响应体为 {"detail":"file not found"}。
真实应用应将字典替换为数据库查询,并在读取 CID 前执行身份认证和文件访问授权。/api/v0/cat 使用 POST 调用 Kubo RPC,不能把它误写成普通 HTTP GET 网关请求。
更新 CID 映射并验证检索
为了让示例可以独立跟做,在同一个 app.py 中继续添加一个仅用于开发环境的索引登记接口。它接收已经导入 IPFS 的 CID,建立当前版本与历史版本记录。
以下为片段示例,依赖前面定义的 app、files 和 versions,并需要补充 BaseModel 导入:
from pydantic import BaseModel

class RegisterFile(BaseModel):
    cid: str

@app.post('/files/{file_id}/versions')
async def register_version(file_id: str, data: RegisterFile):
    # 单进程演示;生产环境应使用数据库事务和并发控制。
    current = files.get(file_id, {}).get('current_version', 0)
    new_version = current + 1
    versions[(file_id, new_version)] = {'cid': data.cid}
    files[file_id] = {'current_version': new_version}
    return {'file_id': file_id, 'version': new_version, 'cid': data.cid}
将这段代码加入 app.py 后重启 Uvicorn。先在本地创建两个内容不同的文件,再通过 Kubo 导入。以下命令适用于 Bash 环境:
printf 'contract version 1\n' > contract-v1.txt
printf 'contract version 2\n' > contract-v2.txt
CID_A=$(ipfs add -Q contract-v1.txt)
CID_B=$(ipfs add -Q contract-v2.txt)
printf 'CID_A=%s\nCID_B=%s\n' "$CID_A" "$CID_B"
预期结果:输出两个不同的 CID,具体值随 Kubo 导入配置和文件内容变化。两次导入应采用相同的导入参数,便于比较。
使用 Bash 和 curl 登记两个版本,再读取当前版本及历史版本:
curl -sS -X POST http://127.0.0.1:8000/files/contract-001/versions \
  -H 'Content-Type: application/json' \
  -d "{\"cid\":\"$CID_A\"}"
curl -sS -X POST http://127.0.0.1:8000/files/contract-001/versions \
  -H 'Content-Type: application/json' \
  -d "{\"cid\":\"$CID_B\"}"
curl -sS http://127.0.0.1:8000/files/contract-001
curl -sS 'http://127.0.0.1:8000/files/contract-001?version=1'
预期结果:前两个请求分别返回包含 version: 1 和 version: 2 的 JSON;第三个请求返回 contract version 2,第四个请求返回 contract version 1,均带有对应的换行符。实际响应中的 CID 为本机导入得到的值。
处理版本变化与完整性边界
IPFS 的内容寻址允许客户端依据 CID 校验收到的原始块,但应用接口返回的业务文件字节并不等于直接返回一个可供验证的原始块。UnixFS 文件可能由多个块组成,应用若需要端到端验证,应通过可信的 IPFS 实现验证 DAG,或额外保存文件级 SHA-256 摘要供客户端下载后校验。
生产环境建议采用以下更新顺序:
- 上传新内容到 Kubo,获得新 CID,并记录文件大小及 SHA-256。
- 确认新 CID 可以读取,同时建立 Pin 或其他持久化保障,避免后续垃圾回收删除所需内容。
- 在数据库事务内插入新版本记录,并通过版本号条件更新当前版本指针。
- 提交事务后返回新版本号;若数据库提交失败,保留旧版本索引并清理无主的临时资源。
- 为历史版本保留独立引用与保留策略;只有业务确认不再需要时才考虑解除 Pin。
例如两个请求同时基于版本 2 上传新内容,如果都直接写入版本 3,可能发生覆盖。数据库可执行条件更新:只有 current_version = 2 时才允许切换到版本 3;受影响行数为 0 时返回 HTTP 409,要求客户端重新读取当前版本后再提交。
还需要明确错误响应:业务文件不存在返回 404,指定版本不存在返回 404,版本冲突返回 409,Kubo 连接失败或读取失败返回 502,未通过授权检查返回 403。不要将所有失败都包装成文件不存在,否则无法区分索引错误与底层内容不可用。
对于较大文件,当前示例的 result.content 会将整个响应读入内存。正式服务应使用受控的流式响应、读取超时、最大文件大小限制和客户端断开处理;如需允许用户直接按 CID 查询,还应先完成授权校验和资源限制,避免将服务变成无限制的公共 IPFS 代理。
验收时至少检查三个条件:当前版本返回 CID B 对应内容,指定版本 1 返回 CID A 对应内容,删除或无法获取底层内容时接口明确返回读取失败而不是错误的业务文件。这样业务 ID 可以持续指向最新文件,而每个历史 CID 仍保持不可变的内容身份。