
P2P 与分布式存储 / 系统课时
沿 DAG 链接验证数据完整性
沿 DAG 链接验证数据完整性
拿到 IPFS 文件的根 CID,并不代表所有文件内容已经保存在本地。本课使用 Kubo 创建一个跨越多个数据块的文件,从根节点追踪子块引用,验证每个块的内容完整性,并通过缺失块实验区分内容损坏、数据不可用与引用不完整三种情况。
学习目标
- 理解根 CID、DAG-PB 节点、UnixFS 文件数据与子块 CID 之间的关系。
- 使用 Kubo 命令检查 DAG 链接并验证原始块的内容哈希。
- 通过离线缺块实验判断文件无法恢复的原因及处理方法。
根 CID 如何约束整张数据图
IPFS 的 Merkle DAG 是一种以内容标识符连接节点的有向无环图。每个块的 CID 包含内容编解码类型与多哈希信息,父节点保存子节点的 CID,因此子块内容改变后,父节点中记录的引用也必须相应改变。
以 Kubo 常见的 UnixFS 文件布局为例,大文件可以由一个 DAG-PB 根节点和多个叶子数据块组成。根节点包含文件布局信息及子块链接,叶子块保存文件内容。具体结构取决于导入参数、分块策略与 UnixFS 编码方式,不能假定每个文件都有相同的树高。
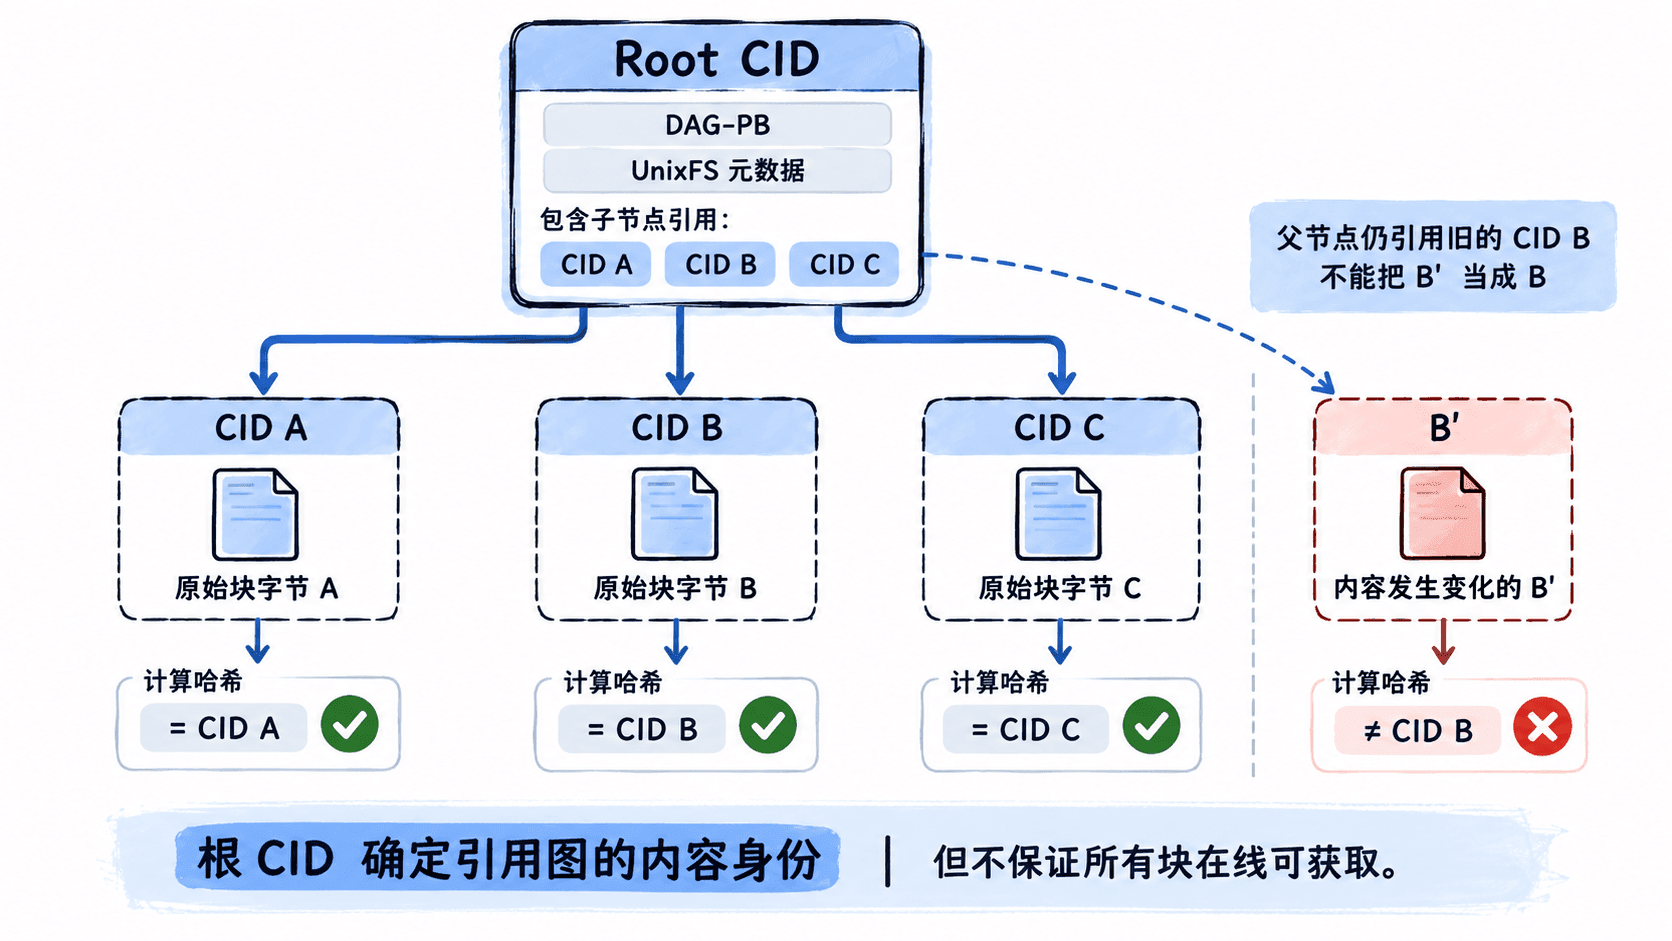
这里需要区分两层校验:第一层是获取某个块后,按照 CID 指定的哈希算法计算其内容摘要并比较;第二层是按照已验证的父节点链接继续获取子块,直到收集到恢复文件所需的全部数据。
例如根节点 R 引用 A、B、C,验证 R 成功只说明 R 的原始块字节符合 R 的 CID,并不能证明 A、B、C 已经下载。只有这些子块都可获取且校验通过,文件内容才具备完整恢复的条件。
创建可追踪的多块文件
以下实验适用于安装并初始化了 Kubo 的环境,使用支持 ipfs add、ipfs dag、ipfs block 和 ipfs refs 的常见 Kubo 版本。先启动本地守护进程,并确保命令行能够连接本地 API。实验使用 CIDv1、固定大小分块与默认的平衡布局,以便观察 DAG 链接。
在 Linux、macOS 或具有 Python 3 的 Bash 环境中执行:
# 在另一个终端保持 ipfs daemon 运行
ipfs daemon
预期结果:终端最终出现类似以下就绪提示,其他启动日志及地址因环境而异。
Daemon is ready另开终端执行:
# 创建约1 MiB的确定性测试内容,避免依赖外部下载
python3 -c 'from pathlib import Path; Path("dag-test.bin").write_bytes(bytes(range(256)) * 4096)'

# 固定分块大小与布局,关闭进度输出便于记录CID
ipfs add --cid-version=1 --chunker=size-262144 --trickle=false --progress=false dag-test.bin
预期输出的格式如下,CID 由实际导入结果决定,不应复制示意值作为真实 CID:
added <CID> dag-test.bin文件大小为 1,048,576 字节,即 1 MiB;按 262,144 字节分块,文件数据可划分为四个完整数据块。默认 UnixFS 导入器可能在叶子块之外创建用于链接的 DAG-PB 节点,因此 DAG 块总数不一定等于四。
将输出中的实际 CID 记录为根 CID。以下命令中的 <CID> 均表示替换为该真实值,尖括号不是命令参数的一部分。
从根节点逐层检查链接
首先读取根节点的 DAG 表示,确认其编解码类型及子块引用。ipfs dag get 输出解码后的结构,而 ipfs block get 取得用于哈希验证的原始块字节,两者用途不同。
# 用实际根CID替换占位符
ipfs dag get <CID>
ipfs refs -r <CID>
预期结果:第一条命令返回根节点的 JSON 表示;对于本实验的 DAG-PB 根节点,可观察到 Data 和 Links 等字段。第二条命令逐行输出递归遍历得到的子块 CID,具体数量和顺序取决于实际 DAG 布局。
ipfs refs -r 用于列出可遍历的后代引用,不代表所有内容都已通过独立的端到端文件校验。若只希望查看直接子节点,可使用 ipfs refs <CID>,并将其输出与根节点中的链接对应起来。
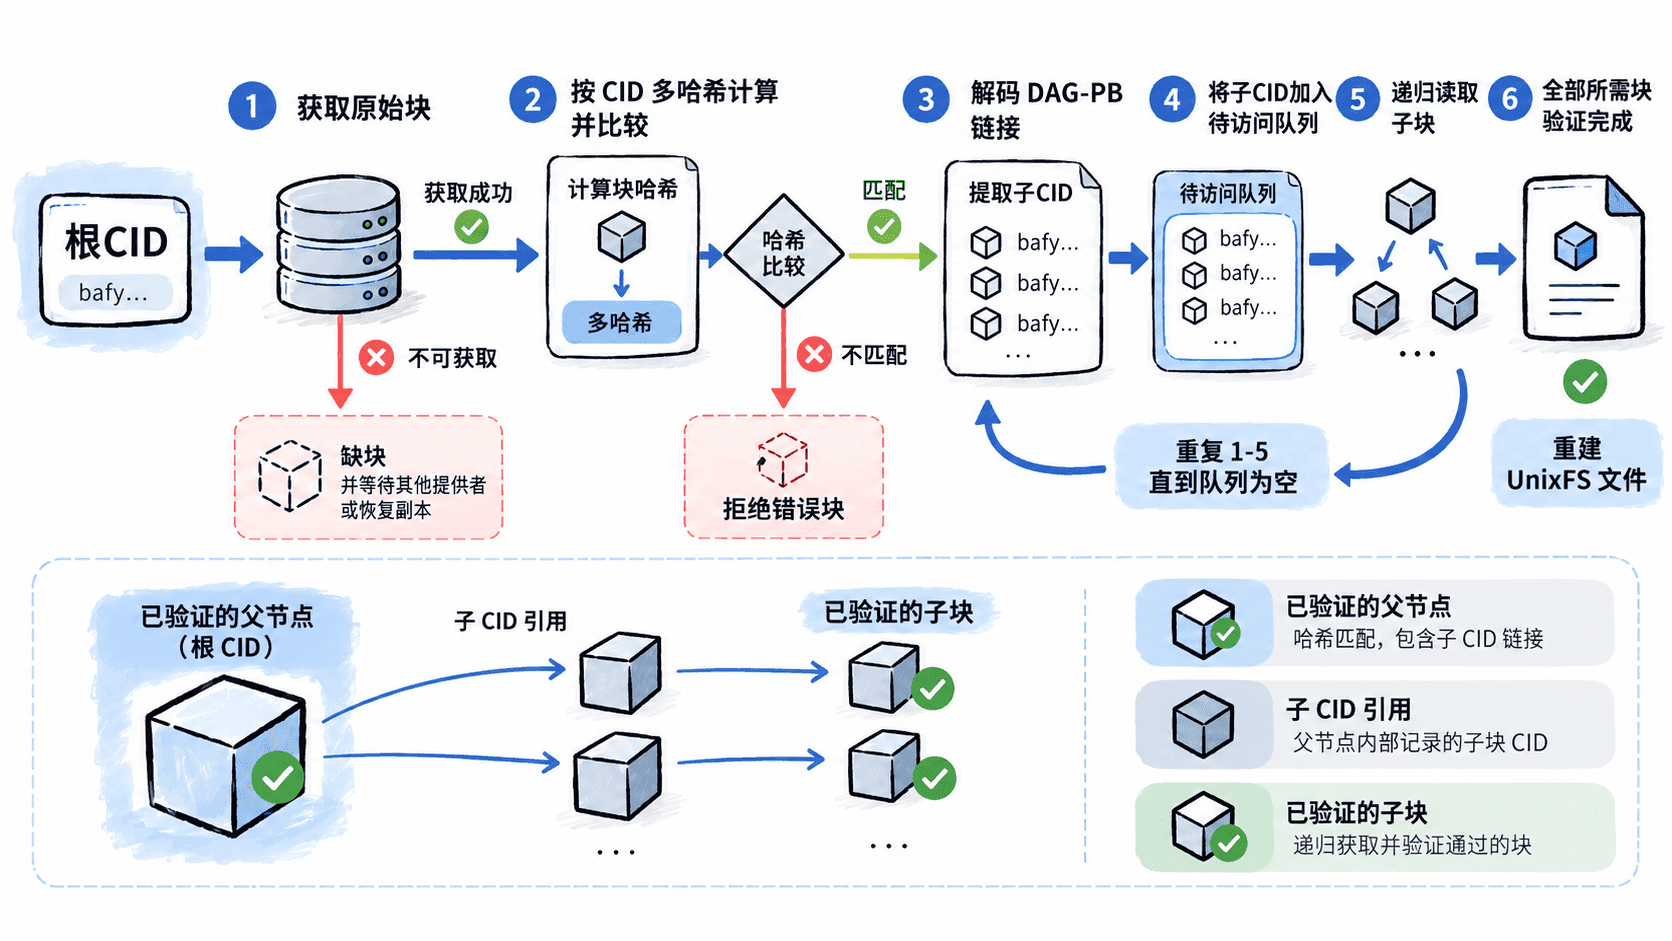
需要注意,DAG-PB 节点中的 Data 是经过编码的 UnixFS 数据,不应直接将其当成整个文件的原始字节。UnixFS 读取器会依据文件布局、链接及块内容完成重组。
独立验证块哈希与文件恢复
Kubo 的 ipfs block stat 可以检查块是否可获取以及原始块大小,但不能单独作为内容完整性测试的全部证据。为了独立验证 CID,应该获取原始块字节并使用与 CID 一致的哈希算法。
下面使用 Python 3 标准库和 Kubo CLI,对实验根 CID 执行独立 SHA-256 检查。由于实验生成的是 CIDv1,且使用默认 SHA2-256 多哈希,脚本会解析 CIDv1 的二进制表示并验证多哈希字段;不适用于任意其他哈希算法的 CID。
import base64
import hashlib
import subprocess
import sys


def read_varint(data, pos):
    value = 0
    shift = 0
    while True:
        if pos >= len(data):
            raise ValueError("不完整的varint")
        byte = data[pos]
        pos += 1
        value |= (byte & 0x7F) << shift
        if byte < 128:
            return value, pos
        shift += 7
        if shift > 63:
            raise ValueError("varint过长")


def verify(cid):
    # 本实验使用CIDv1的base32文本形式
    if not cid.startswith("b"):
        raise ValueError("需要base32编码的CIDv1")
    encoded = cid[1:].upper()
    raw = base64.b32decode(encoded + "=" * (-len(encoded) % 8))
    version, pos = read_varint(raw, 0)
    codec, pos = read_varint(raw, pos)
    hash_code, pos = read_varint(raw, pos)
    digest_size, pos = read_varint(raw, pos)
    expected = raw[pos:]
    if version != 1 or hash_code != 0x12 or digest_size != 32 or len(expected) != 32:
        raise ValueError("仅支持本实验的CIDv1 SHA2-256")

    # 必须读取原始块,不能哈希dag get的JSON表示
    block = subprocess.check_output(["ipfs", "block", "get", cid])
    actual = hashlib.sha256(block).digest()
    if actual != expected:
        raise ValueError("块内容与CID不匹配")
    print(f"验证通过 codec={codec} bytes={len(block)}")


if __name__ == "__main__":
    verify(sys.argv[1])
保存为 verify_block.py,将 <CID> 替换为实际根 CID 后运行:
python3 verify_block.py <CID>预期输出格式如下,codec 与 bytes 来自真实根块,不能预先固定其值:
验证通过 codec=<CODEC> bytes=<SIZE>脚本只验证指定 CID 对应的单个块。要验证整个 DAG,必须对所有可达的子块分别执行相同校验,并确认不存在遗漏的必需引用。生产实现还应限制遍历节点数、深度和累计数据量,防止恶意 DAG 消耗过多资源。
随后使用 UnixFS 文件读取命令验证能否恢复完整文件:
ipfs cat <CID> > restored.bin
sha256sum dag-test.bin restored.bin预期结果:sha256sum 输出两行记录,哈希摘要相同,文件名分别为 dag-test.bin 和 restored.bin。如果运行环境没有 sha256sum,可以改用 Python 的 hashlib 比较两个文件。
根 CID 验证、递归块验证和文件哈希比较分别覆盖不同层面:单块内容身份、整张引用图的完整获取,以及重建结果是否与原始文件相同。
缺失块与错误块如何影响恢复
缺失块、错误块与引用不完整的表现并不相同,排查时应先确认根节点能否读取,再逐层定位失败的子 CID。
| 故障类型 | 典型现象 | 判断与处理 |
|---|---|---|
| 缺失块 | 根节点可读取,某个子 CID 无法获取 | 检查本地块存储、在线提供者与网络连接,从其他持有正确块的节点恢复 |
| 错误块 | 收到的字节与请求 CID 的哈希不匹配 | 拒绝该块,重新从其他来源获取;不能用错误字节继续组装 |
| 引用不完整 | 父节点未包含预期数据的链接 | 如果父节点本身哈希正确,说明其内容就是这样定义的;需要找到正确的根 CID 或重新导入完整文件 |
可以通过两个相互隔离的 Kubo 仓库模拟缺块。第一个仓库已经拥有完整文件,第二个仓库只导入根节点原始块,且不连接第一个仓库或其他可能持有子块的节点。此时第二个仓库可能成功读取根节点结构,却无法恢复完整文件。
下面的 Bash 实验使用独立的临时仓库,并在离线模式下读取,避免网络自动补齐缺失块。执行前需确保根 CID 来自前述多块文件。
# 从原仓库导出根节点原始块
ipfs block get <CID> > root.block

# 新建隔离仓库并初始化
export IPFS_PATH="$(mktemp -d)"
ipfs init

# 离线导入根块;根CID应与原值相同
ipfs block put --format=protobuf --mhtype=sha2-256 --mhlen=32 root.block

# 只具备根块时尝试离线读取整个文件
ipfs --offline cat <CID> > incomplete.bin预期结果:ipfs block put 返回与原根 CID 对应的标识;最后的 ipfs cat 在缺少必需子块时失败,并输出块不可获取一类的错误。具体错误文字取决于 Kubo 版本,不应将 incomplete.bin 当成成功恢复的文件。实验结束后退出当前终端或恢复原来的 IPFS_PATH,避免后续命令误操作隔离仓库。
若收到内容被篡改的块,正确实现应依据请求 CID 拒绝不匹配的字节,而不是把它保存为原 CID 对应的有效内容。若发布者原本就生成了包含错误数据的 DAG,哈希仍然可能完全匹配,这属于内容来源与正确性问题,不属于传输完整性失败。
按层定位失败并恢复内容
实际排查时,建议遵循以下顺序:
- 用
ipfs block stat <CID>确认根块能否获取;失败时先检查根 CID 是否正确、仓库是否包含该块,以及是否有可连接的提供者。 - 用
ipfs refs -r <CID>递归检查引用;若遍历中断,记录最后能够访问的节点及失败的子 CID。 - 对已获取的关键块运行独立哈希校验,排除本地缓存、传输或非标准存储实现造成的内容错误。
- 使用
ipfs cat <CID>恢复文件,并与已知可信的原始文件哈希比较;没有可信原件时,只能证明与该 DAG 所定义内容的一致性。 - 对缺失的块,从仍然持有正确 CID 内容的节点重新获取;恢复后重新执行递归读取与文件比较。
例如,一个根节点引用四个数据块,其中三个可获取、一个不可获取,即使当前已有 75% 的文件数据,也不能认为整个文件恢复成功。普通 UnixFS 文件没有默认的跨块纠删码冗余,缺少必需块时无法凭其他块自动推导出缺失字节。
对于需要长期分发的内容,应在导入后使用 ipfs pin add <CID> 保留本地所需块,并在其他独立节点保存完整副本。Pin 主要约束本地垃圾回收行为,不等于自动创建远端备份,也不保证节点始终在线。
沿 DAG 验证完整性的最终判据是:从可信的根 CID 出发,所有恢复文件所需的引用都能解析,所有获取的块都与各自 CID 匹配,并且 UnixFS 能够成功重建文件。根块存在只是验证的起点,不是完整文件可用的证明。