
区块链原理 / 系统课时
验证者规模为何影响投票开销
验证者规模为何影响投票开销
同一套 BFT 共识规则,验证者从 100 个增加到 1000 个,消息传输和签名验证成本可能增长近百倍。本课通过两阶段投票的具体算例,比较全互发、领袖收票与签名聚合的成本,并判断验证者规模扩大后真正的性能瓶颈。
学习目标
- 根据验证者数量计算投票消息量、单节点验签次数与网络负载。
- 比较全互发、领袖收票和分组聚合的扩展性及瓶颈位置。
- 使用可运行的估算脚本评估验证者规模变化,并识别模型与实际部署的差异。
投票开销从哪里产生
以 Tendermint 风格的 BFT 共识为例,一个正常轮次通常包含区块提议、Prevote 和 Precommit。验证者在两个投票阶段分别签名并传播投票,收到其他验证者的投票后,还需要检查高度、轮次、区块标识和签名有效性。
先建立一个便于计算的理想化模型:
- 验证者数量为 ,每个验证者参与两个投票阶段。
- 每阶段所有验证者都产生一份投票,且每份投票都送达其他 个验证者。
- 每份投票假设占 96 B,其中 Ed25519 签名占 64 B,其余 32 B 是人为设定的简化票据开销。
- 暂不计算区块提议、消息重传、协议封装、节点连接维护及额外轮次。
这种全互发模型下,两阶段的逻辑消息发送次数为:
每个验证者需要执行的远端投票签名验证次数为:
例如,100 个验证者需要发送 次投票消息,每个节点验证 198 份远端签名。按每次发送 96 B 计算,全网投票载荷约为 1.81 MiB。
这里的全互发是用于成本分析的逻辑模型,不代表所有协议都建立完全互联的物理网络。例如,CometBFT 共识规范采用 Gossip 传播投票,实际链路发送次数取决于邻居连接、去重和传播调度。
三种传播结构怎样改变消息数量
网络拓扑决定每一份投票需要经过多少次传输,也决定验签工作分散在所有验证者上,还是集中到少数收集节点。
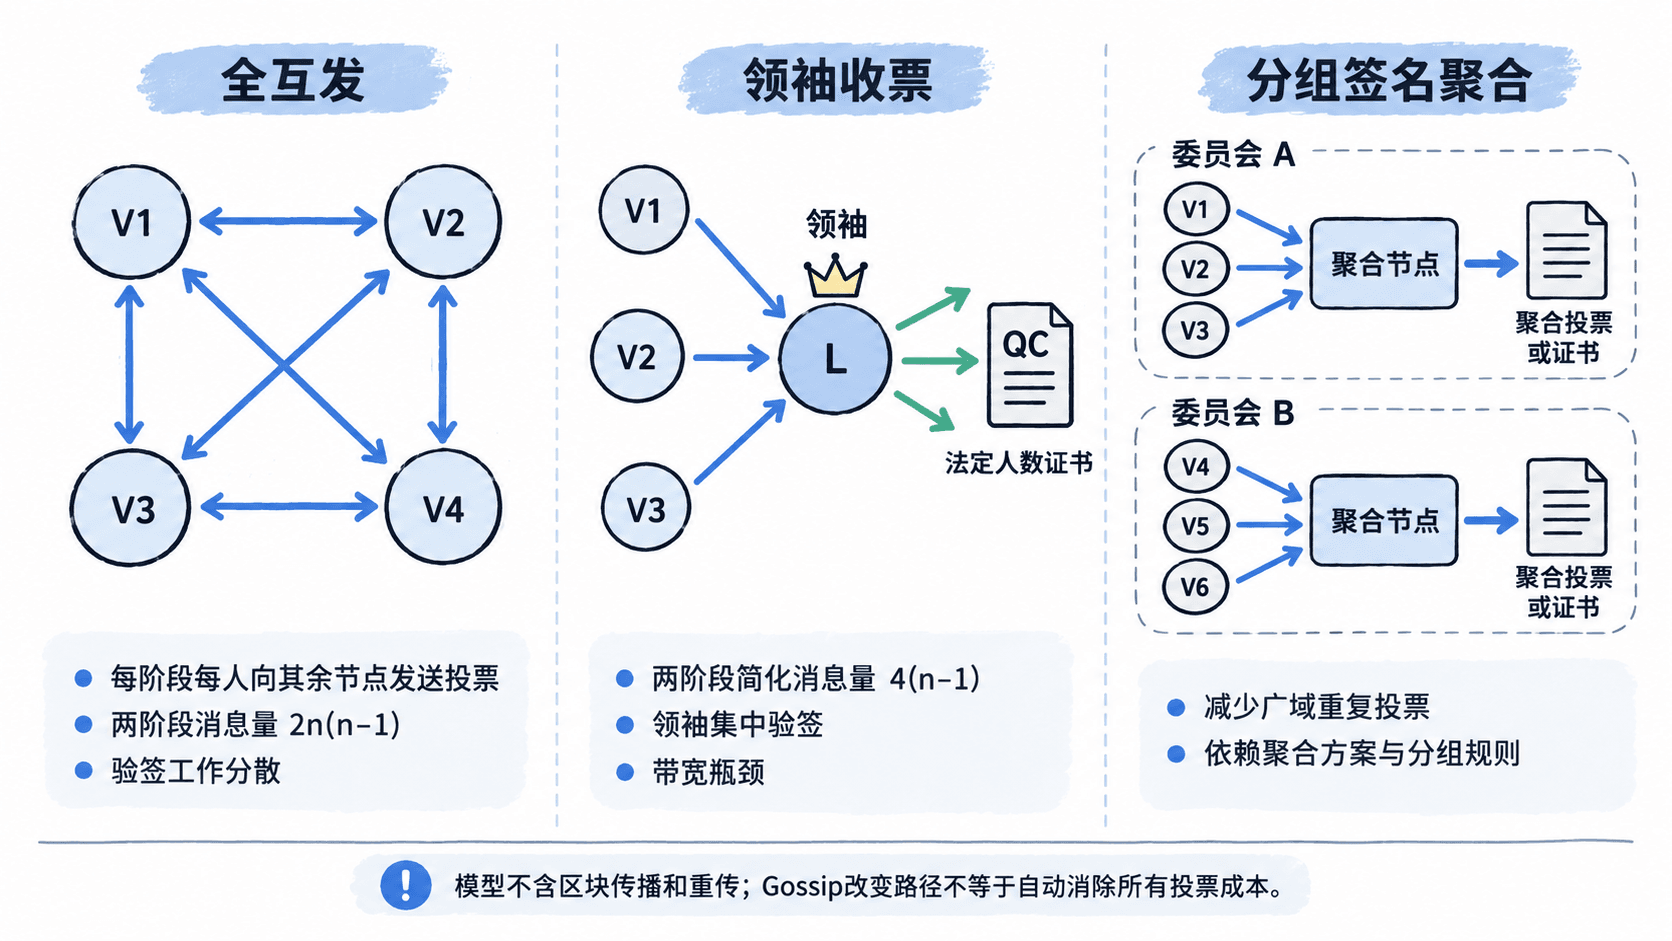
为了公平比较,假设所有验证者在两个阶段均提交投票,领袖每阶段收集其他 份投票,再向其他 个节点广播一份可验证的法定人数证书(QC)。
| 传播结构 | 两阶段简化发送次数 | 主要成本 |
|---|---|---|
| 全互发 | 总发送量和总验签量随规模平方增长 | |
| 领袖收票并广播 QC | 消息次数线性增长,但领袖集中收票、验签和发送证书 | |
| 分组收票与签名聚合 | 取决于分组、聚合树及广播方式 | 分组节点负责收票和聚合,额外承担分组协调与证书验证 |
以 1000 个验证者为例,全互发需要 1,998,000 次发送;上述领袖收票模型只需 3996 次。后者的消息次数明显更少,但领袖仍可能需要验证两个阶段各 999 份投票。
领袖收票还存在重要前提:其他验证者必须能够独立验证 QC,不能仅相信领袖声称已经获得足够投票。对于按质押权重投票的协议,QC 还必须证明签名者的有效投票权重达到法定门槛,而不是只计算签名数量。
签名聚合为什么不能简单等同于免费压缩
消息次数减少后,还要检查每条消息有多大。假设 1000 个验证者具有相同投票权重,严格超过三分之二的法定人数至少需要 667 票。
如果 QC 直接附带 667 份独立的 Ed25519 签名,仅签名就占 B。把这份证书发送给其他 999 个节点,单阶段仅证书签名部分就需要约 40.7 MiB 的累计发送量。
这说明领袖模型即使只有线性数量的消息,如果每份广播证书包含线性数量的独立签名,整体字节量仍可能呈平方增长。
支持同一投票消息聚合的 BLS 方案可以改变这个结果。以使用 96 B 聚合签名的方案为例,1000 个验证者的参与者位图至少需要 125 B,因此不计其他字段时,一份聚合证书的签名与参与者位图合计约为 221 B。
不过,BLS 聚合不是把任意 Ed25519 签名拼接起来。它要求协议采用匹配的签名体系、正确的公钥与参与者身份验证机制,并安全处理恶意公钥等问题。验证聚合签名仍会消耗计算资源,聚合者也需要收集和处理原始投票。
以太坊 Attestation 文档中的 aggregation_bits 和聚合签名,就是实际协议中记录参与者并减少重复证明数据的例子。
另外,验签时间必须单独测量。假设单次普通签名验证耗时 0.2 ms,那么全互发模型中,100 个验证者对应单节点约 39.6 ms 的串行验签计算量,1000 个验证者则约为 399.6 ms。这个 0.2 ms 是演示参数,不是任何硬件或密码算法的固定性能指标。
用 Python 估算扩容成本
下面使用 Python 3 标准库计算两种传播结构的消息次数、全互发投票载荷,以及单节点串行验签耗时。脚本不依赖区块链节点,可以直接保存为 vote_cost.py 运行。
# 两个投票阶段,假设所有验证者都投票且消息全部送达

def estimate(n: int, vote_bytes: int = 96, verify_ms: float = 0.2):
    if n < 2:
        raise ValueError("n must be >= 2")

    mesh_messages = 2 * n * (n - 1)
    leader_messages = 4 * (n - 1)
    mesh_mib = mesh_messages * vote_bytes / (1024 * 1024)
    node_verify_ms = 2 * (n - 1) * verify_ms
    return mesh_messages, leader_messages, mesh_mib, node_verify_ms


for n in (100, 1000):
    mesh, leader, mib, cpu = estimate(n)
    print(f"n={n} mesh={mesh} leader={leader} "
          f"MiB={mib:.2f} verify_ms={cpu:.1f}")
预期输出:
n=100 mesh=19800 leader=396 MiB=1.81 verify_ms=39.6
n=1000 mesh=1998000 leader=3996 MiB=182.92 verify_ms=399.6
验证者数量增加十倍,全互发消息量从 19,800 增至 1,998,000,增长约 100.9 倍;领袖收票模型则从 396 增至 3996,增长约 10.1 倍。
注意:MiB 是全网逻辑投票发送载荷之和,不是某一台节点的带宽需求;verify_ms 是全互发场景下每节点的串行验签计算量,不包含签名生成、聚合验证或并行优化。领袖模型的 QC 尺寸也没有计入这份脚本。
选型时怎样判断规模上限
协议选择不能只比较消息次数,还需要把网络、计算、密码证明和故障恢复放在同一组性能预算中。
| 检查指标 | 测量方式 | 需要识别的问题 |
|---|---|---|
| 投票传播延迟 | 分别记录 Prevote、Precommit 的 P50/P95 耗时 | 验证者增加是否导致投票传播超过轮次预算 |
| 网络负载 | 记录各节点入站、出站 MiB/s 和重复消息比例 | 是全网重复传播过多,还是领袖出口拥塞 |
| 验签与聚合 | 统计每轮验签次数、CPU 时间、聚合耗时 | 计算瓶颈集中于普通节点还是聚合节点 |
| QC 尺寸 | 记录证书字节数与参与者数量 | 减少消息次数后是否仍在重复传输大量签名 |
| 轮次切换 | 统计超时、重试、视图切换和未及时收到法定票数的比例 | 正常网络波动是否导致额外轮次放大成本 |
例如,目标是每 2 秒完成一次共识提交时,可以先在 100、300、1000 个验证者规模下进行压力测试。分别记录两阶段的 P95 延迟和最大节点 CPU 占用,再观察加入 5% 丢包或部分慢节点时是否出现明显的轮次切换增加。这里的规模、时限和丢包率是测试场景,不是协议承诺的性能。
对于几十个受许可验证者,较直接的投票传播结构可能更容易部署与审计。规模扩大至数百或数千后,可评估委员会、聚合签名或领袖收集证书,但必须重新分析法定人数、投票权重、聚合者故障和委员会抽样的安全假设。
最终选型应同时满足两项要求:合法投票仍能构成可独立验证的法定人数证据,且在目标验证者规模与网络故障条件下,实际测得的投票传播、验签和证书分发耗时不会持续超过共识轮次预算。