
多人游戏与网络同步 / 系统课时
把重连过程做成可观测事件
把重连过程做成可观测事件
自动重连如果只在客户端“悄悄重试”,出了问题就只能靠猜。本课把一次重连拆成结构化事件,记录尝试次数、退避等待、失败原因与最终结果,再从事件聚合出可用于排障和容量判断的基础指标。
学习目标
- 设计一组能还原重连过程的最小事件与字段。
- 用可运行示例记录失败、再次等待和最终成功。
- 区分单次日志与聚合指标,避免只看“成功率”失去上下文。
先定义能还原过程的事件
一条有用的重连记录不应只是 reconnect failed。至少要回答:这是第几次尝试、之前等了多久、为什么失败、之后是否继续,以及整轮重连最后成功还是放弃。可以把生命周期收敛为五类事件:reconnect_scheduled、reconnect_attempt、reconnect_failed、reconnect_succeeded、reconnect_giveup。
每条事件建议携带同一组关联字段,例如 reconnectId、attempt、delayMs、reason 和 result。其中 reconnectId 只负责把同一轮重连串起来,不要把访问令牌、Cookie 或其他凭据写入日志。
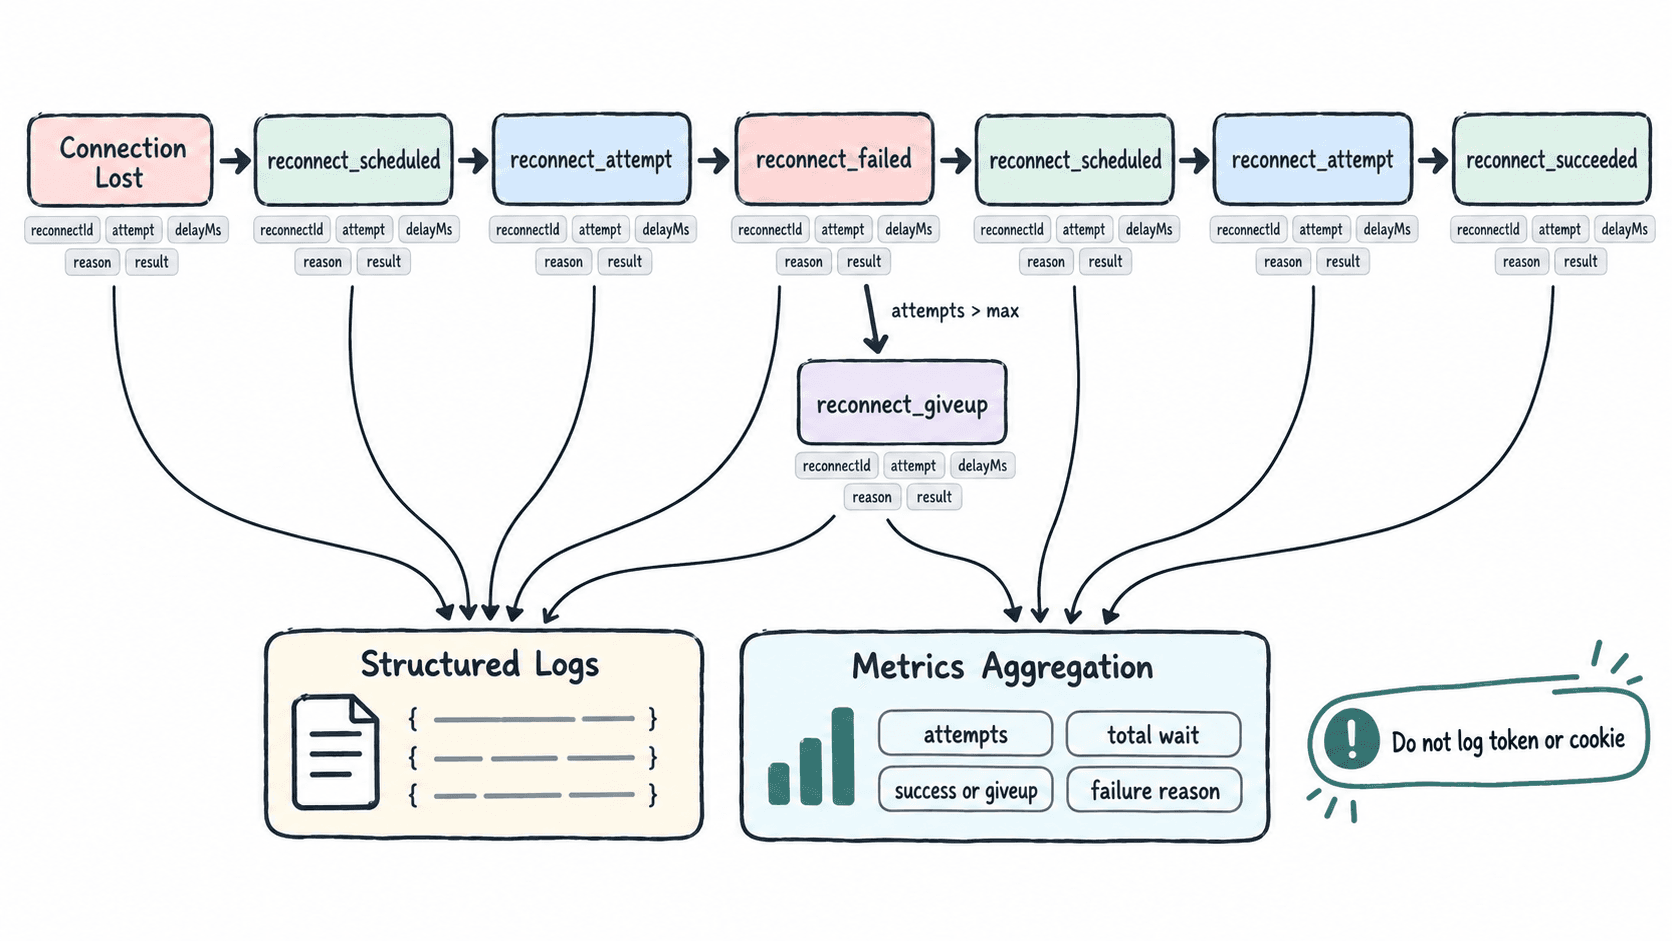
用结构化事件记录一次重连
下面的 Node.js 示例不依赖网络库,只模拟“一次失败后再次等待并成功”的过程。重点是事件结构稳定,而不是把日志文本拼成人类句子;这样后续才能可靠聚合。
const events = [];

function emitReconnectEvent(type, data) {
  events.push({ type, ...data });
}

function simulateReconnect() {
  const reconnectId = "rc-001";

  emitReconnectEvent("reconnect_scheduled", {
    reconnectId,
    attempt: 1,
    delayMs: 500,
    reason: "heartbeat_timeout"
  });

  emitReconnectEvent("reconnect_attempt", {
    reconnectId,
    attempt: 1
  });

  emitReconnectEvent("reconnect_failed", {
    reconnectId,
    attempt: 1,
    reason: "transport_timeout",
    result: "retry"
  });

  emitReconnectEvent("reconnect_scheduled", {
    reconnectId,
    attempt: 2,
    delayMs: 1000,
    reason: "retry_after_failure"
  });

  emitReconnectEvent("reconnect_attempt", {
    reconnectId,
    attempt: 2
  });

  emitReconnectEvent("reconnect_succeeded", {
    reconnectId,
    attempt: 2,
    result: "resumed"
  });

  return events;
}

console.log(JSON.stringify(simulateReconnect(), null, 2));
预期输出:
[
  {
    "type": "reconnect_scheduled",
    "reconnectId": "rc-001",
    "attempt": 1,
    "delayMs": 500,
    "reason": "heartbeat_timeout"
  },
  {
    "type": "reconnect_attempt",
    "reconnectId": "rc-001",
    "attempt": 1
  },
  {
    "type": "reconnect_failed",
    "reconnectId": "rc-001",
    "attempt": 1,
    "reason": "transport_timeout",
    "result": "retry"
  },
  {
    "type": "reconnect_scheduled",
    "reconnectId": "rc-001",
    "attempt": 2,
    "delayMs": 1000,
    "reason": "retry_after_failure"
  },
  {
    "type": "reconnect_attempt",
    "reconnectId": "rc-001",
    "attempt": 2
  },
  {
    "type": "reconnect_succeeded",
    "reconnectId": "rc-001",
    "attempt": 2,
    "result": "resumed"
  }
]
真实客户端还可以加入网络类型、客户端版本、区域或服务器节点等维度,但要控制基数。玩家 ID、房间 ID 等高基数字段适合留在结构化日志中,不宜直接作为监控指标标签。
从事件得到真正可用的指标
事件是明细,指标是聚合。最基础的一组指标可以包括:每轮重连尝试次数、累计等待时长、最终成功或放弃、按失败原因统计的失败次数,以及从断线到恢复可玩的总耗时。仅统计“重连成功率”会掩盖一种常见退化:成功率没变,但用户要等更久、重试更多次。
失败原因也要稳定枚举,例如 transport_timeout、auth_rejected、session_expired、server_unavailable。不要把原始异常文本直接当指标标签,否则不同错误字符串会迅速制造高基数。
用日志回答“为什么”,用指标回答“多严重”
结构化日志适合还原一名玩家某一轮重连的完整路径;指标适合判断问题是否普遍、是否在某版本或区域突然恶化。两者通过同一个 reconnectId 或追踪上下文关联,就能从“成功率下降”继续钻取到具体失败链路。
上线前至少验证三种路径:首次尝试即成功、一次失败后成功、达到上限后放弃。只要这三条路径都能生成完整事件并聚合出一致指标,重连就从不可见的客户端行为变成了可定位、可比较、可告警的系统信号。