
多人游戏与网络同步 / 系统课时
固定间隔为什么会形成重连风暴
固定间隔为什么会形成重连风暴
当一批玩家因机房抖动、网关重启或运营商故障同时掉线时,固定间隔重试会让客户端在相同时间点反复冲击服务器。本篇用时间线解释这种同步效应,并把重试策略改成带上限的指数退避,先降低失败期间的请求密度。
学习目标
- 解释固定间隔重试为什么会形成周期性请求尖峰
- 用带上限的指数退避计算连续重连的等待时间
- 区分降低重试频率与打散客户端时间点这两个不同问题
重连风暴来自同步而不是单个客户端太快
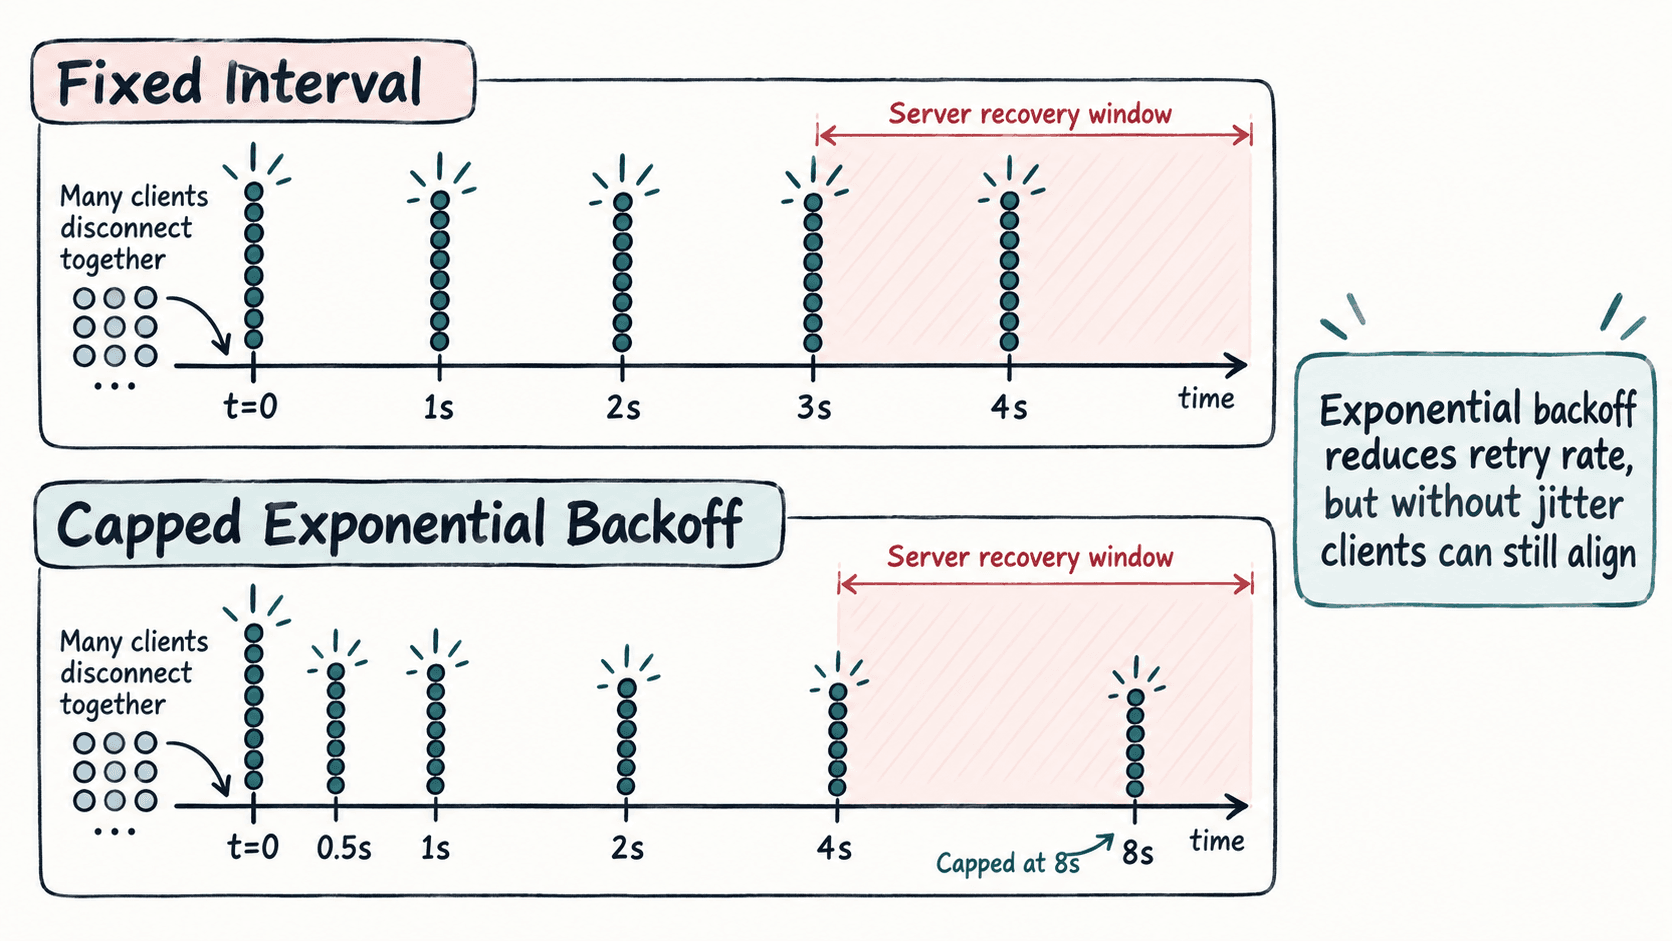
假设 1000 个客户端都在 12:00:00 失去连接,并统一采用每 1 秒重试一次。第一次失败后,它们会在 12:00:01 一起重试;如果服务器仍未恢复,12:00:02、12:00:03 还会继续出现近似同规模的尖峰。服务器刚恢复时,这种整齐的请求波峰反而最容易把认证、会话恢复和房间查询压垮。
固定间隔的问题是客户端之间没有任何时间差。即使单个客户端每秒只发一次请求,乘上大量同时掉线的连接后,也会形成周期性的瞬时高并发。失败响应越快,下一轮客户端越容易继续保持同步。
用指数退避让失败越久等待越长
指数退避的核心规则是:第 0 次重试等待较短时间,之后每失败一次就扩大等待,并设置最大值防止间隔无限增长。例如基准等待 0.5 秒、上限 8 秒时,各次等待可以是 0.5、1、2、4、8、8 秒。
下面的程序同时计算固定间隔和指数退避的累计重试时刻。累计时刻比单次等待更接近真实客户端调度,因为下一次重连通常从上一次失败之后开始计时。
from itertools import accumulate

BASE_DELAY = 0.5
MAX_DELAY = 8.0
ATTEMPTS = 6
FIXED_DELAY = 1.0

# 固定间隔始终等待相同时间;指数退避随失败次数增长并受上限约束。
fixed_waits = [FIXED_DELAY] * ATTEMPTS
backoff_waits = [min(MAX_DELAY, BASE_DELAY * (2 ** attempt)) for attempt in range(ATTEMPTS)]

fixed_times = list(accumulate(fixed_waits))
backoff_times = list(accumulate(backoff_waits))

print("fixed waits:", fixed_waits)
print("fixed retry times:", fixed_times)
print("backoff waits:", backoff_waits)
print("backoff retry times:", backoff_times)
预期输出
fixed waits: [1.0, 1.0, 1.0, 1.0, 1.0, 1.0]
fixed retry times: [1.0, 2.0, 3.0, 4.0, 5.0, 6.0]
backoff waits: [0.5, 1.0, 2.0, 4.0, 8.0, 8.0]
backoff retry times: [0.5, 1.5, 3.5, 7.5, 15.5, 23.5]
从累计时间可以看到,指数退避会迅速降低故障持续期间的请求频率。服务器恢复越慢,客户端产生的新连接尝试越稀疏,认证服务、网关和游戏服就更有机会完成恢复。
上限、次数与停止条件要一起设计
退避不能只写一个倍增公式。客户端还需要明确最大等待、最大尝试次数或总恢复时限,否则玩家可能在后台无限重试。实践中可以把策略拆成三个约束:基准等待决定第一次恢复速度,上限控制最差等待体验,总时限决定何时停止自动重连并提示玩家手动处理。
例如实时对战可以把较短的总恢复时限交给会话保留窗口:只要仍可能恢复原房间,就继续自动尝试;超过服务器允许的会话恢复时间后,再转成重新登录或回到大厅。这样重连策略和服务器状态生命周期是一致的,而不是客户端独自无限循环。
什么时候固定间隔还能用
固定间隔并非永远错误。只在客户端数量很少、目标服务容量明确充足,或测试工具需要稳定复现某个时间节奏时,它才比较合适。面向公网的大规模多人游戏,只要故障可能同时影响一批玩家,就应至少采用带上限的指数退避,并进一步加入随机抖动来打散同一轮客户端的实际重试时刻。