
多人游戏与网络同步 / 系统课时
完成一个可回归的恢复演练
完成一个可回归的恢复演练
一次真正有价值的重连演练,不是手动断网后看到角色回来就结束,而是把断线、恢复会话、重新绑定房间、同步权威状态、补放增量和重新进入战斗逐段断言,并保存同一组输入与证据,使它能在每个版本中重复执行。
学习目标
- 把从断网到重新进入战斗的恢复链路拆成可验证检查点
- 用固定输入和故障注入构造可重复的回归场景
- 验证状态连续性、序列连续性以及重放操作的幂等性
固定一条标准演练
先只设计一条最小但完整的标准场景:客户端已在同一场战斗中处于 READY,随后网络中断一段固定时间;服务端继续推进权威状态;网络恢复后客户端恢复原会话和房间,应用快照与缺失增量,最后重新允许战斗输入。
为了让结果可比较,至少固定以下输入:客户端与服务端构建版本、地图、玩家数、随机种子、断线发生时刻、断线持续时间和恢复后要执行的第一条业务或战斗操作。随机选择断线点会让失败难以复现。
把恢复链路变成检查点
不要只断言最终的 READY。中间阶段应留下可观察事件和时间戳,例如 transport_connected、session_resumed、room_bound、snapshot_applied、delta_replayed。这样失败时可以直接判断恢复停在连接、认证、房间还是状态同步阶段。
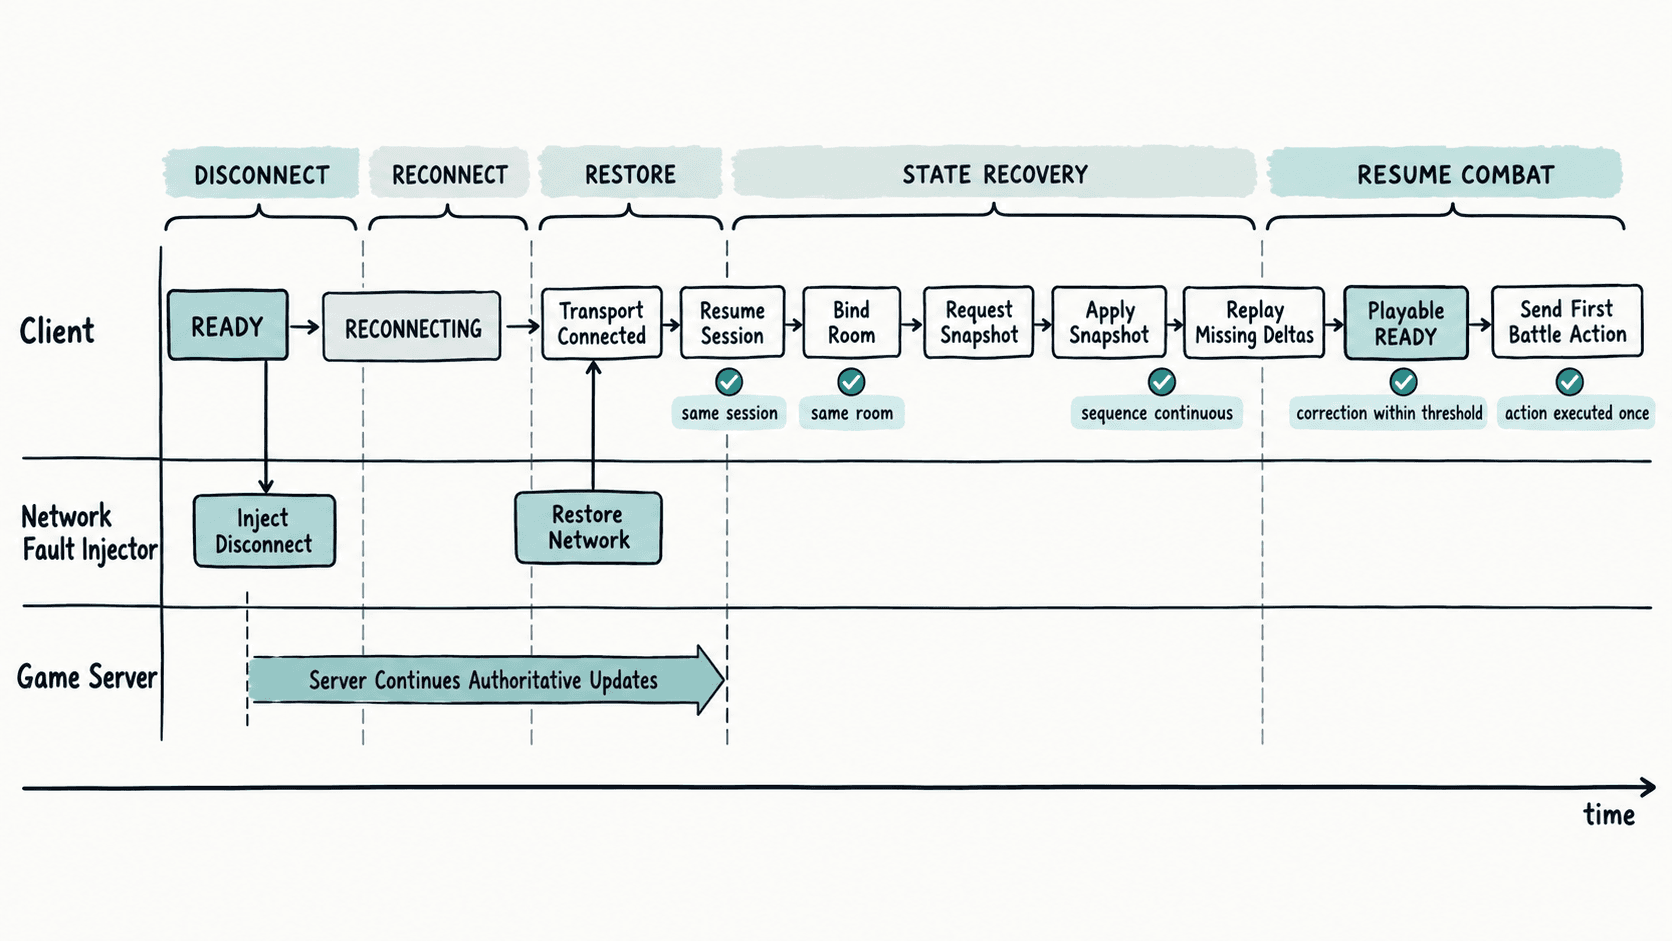
检查点应同时覆盖“身份连续”“房间连续”“状态连续”和“操作安全”。例如恢复后虽然房间 ID 正确,但快照序列停在旧值,仍然不能判定成功;同样,状态已经恢复却把断线前的幂等操作再次执行,也属于回归失败。
用可执行模型跑通完整链路
下面的 Python 程序用一个最小客户端和服务端模型演练完整恢复。它不是某个引擎的网络 API,而是可直接运行的测试模型;接入真实项目时,将各阶段方法替换成项目已有的连接、会话、房间、快照和增量观测钩子即可。
class FakeServer:
    def __init__(self):
        self.session_token = 'session-ok'
        self.room_id = 'room-7'
        self.snapshot_data = {'seq': 101, 'x': 11.0}
        self.delta_log = [{'seq': 102, 'dx': 0.5}]
        self.processed = {}
        self.action_exec_count = 0

    def resume_session(self, token):
        return token == self.session_token

    def bind_room(self, room_id):
        return room_id == self.room_id

    def get_snapshot(self):
        return dict(self.snapshot_data)

    def get_deltas_after(self, seq):
        return [item for item in self.delta_log if item['seq'] > seq]

    def execute_action(self, request_id):
        if request_id not in self.processed:
            self.action_exec_count += 1
            self.processed[request_id] = {'accepted': True, 'action_seq': 103}
        return self.processed[request_id]


class Client:
    def __init__(self):
        self.state = 'READY'
        self.history = ['READY']
        self.predicted_x = 12.0
        self.x = 10.0
        self.last_seq = 100

    def set_state(self, value):
        self.state = value
        self.history.append(value)

    def disconnect(self):
        self.set_state('RECONNECTING')

    def recover(self, server):
        self.set_state('TRANSPORT_CONNECTED')
        assert server.resume_session('session-ok')
        self.set_state('SESSION_RESUMED')

        assert server.bind_room('room-7')
        self.set_state('ROOM_BOUND')

        snapshot = server.get_snapshot()
        self.x = snapshot['x']
        self.last_seq = snapshot['seq']
        self.set_state('SNAPSHOT_APPLIED')

        for delta in server.get_deltas_after(self.last_seq):
            assert delta['seq'] == self.last_seq + 1
            self.x += delta['dx']
            self.last_seq = delta['seq']
        self.set_state('DELTA_REPLAYED')

        correction = abs(self.predicted_x - self.x)
        self.set_state('READY')
        return correction


server = FakeServer()
client = Client()

client.disconnect()
correction = client.recover(server)

first = server.execute_action('shot-001')
retry = server.execute_action('shot-001')

assert client.state == 'READY'
assert client.last_seq == 102
assert correction <= 0.50
assert first == retry
assert server.action_exec_count == 1
action_seq = first['action_seq']

print('state_path=' + '>'.join(client.history))
print(f'snapshot_and_delta_seq={client.last_seq}')
print(f'correction_m={correction:.2f}')
print(f'battle_action_seq={action_seq}')
print(f'executed_action_count={server.action_exec_count}')
print('regression=PASS')
预期输出
state_path=READY>RECONNECTING>TRANSPORT_CONNECTED>SESSION_RESUMED>ROOM_BOUND>SNAPSHOT_APPLIED>DELTA_REPLAYED>READY
snapshot_and_delta_seq=102
correction_m=0.50
battle_action_seq=103
executed_action_count=1
regression=PASS
这里同时验证了三件事:客户端按预期状态顺序回到 READY,快照后的增量序列连续推进到 102,同一个 requestId 重试两次仍只执行一次战斗操作。真实系统还应把每个断言绑定到日志或遥测字段,而不是只依赖测试进程内状态。
把一次通过固化成回归场景
回归记录至少应保存 scenarioId、构建版本、地图、种子、断线参数、恢复阶段时间戳、最终序列号、状态校正幅度、重连尝试次数、失败原因和重复操作次数。测试平台只要能够读取这些字段,就可以稳定比较两个版本。
同一场景可以逐步扩展为短断线、长断线、延迟抖动、丢包和服务端迁移等变体,但每个变体一次只改变少量条件。若同时修改网络模型、地图、玩家数和输入脚本,即使失败也很难判断是哪一个条件触发。
失败时保留足够证据
演练失败后不要立即重跑覆盖现场。客户端需要保留状态迁移与序列日志,服务端保留同一 sessionId 或 connectionId 的恢复日志,测试框架保存故障注入起止时间和最终断言;必要时再附加抓包文件。
稳定的验收标准应是:客户端恢复原会话与房间,权威状态成功应用,增量序列无缺口,状态校正在阈值内,重新进入 READY 后第一条战斗操作可执行且不会重复生效。达到这些条件,这条演练才真正具备持续回归价值。