
多人游戏与网络同步 / 系统课时
多次重连后玩家状态被覆盖
多次重连后玩家状态被覆盖
玩家连续重连几次后,常见现象不是“恢复失败”,而是先恢复正确、随后又被旧状态覆盖。根因通常来自并发连接、旧会话迟到消息或多个恢复请求同时写入。排查关键是给每次连接建立明确代次,并让服务端只接受当前有效代次的写入。
学习目标
- 识别旧连接迟到消息覆盖新状态的竞态
- 用连接代次和恢复请求标识阻止过期写入
- 验证多次重连后只有当前会话能修改玩家状态
先还原谁覆盖了谁
不要只盯最终错误值。先按 playerId 汇总一次完整时间线,至少包含 connectionId、连接代次 generation、恢复请求 requestId、写入前版本和写入后版本。
典型故障是:新连接 generation=42 已恢复到版本 v210,旧连接 generation=41 的迟到消息随后到达,并按旧基线写回 v198。如果日志只记录玩家 ID,而不记录代次,很难证明这是“旧消息覆盖新状态”。
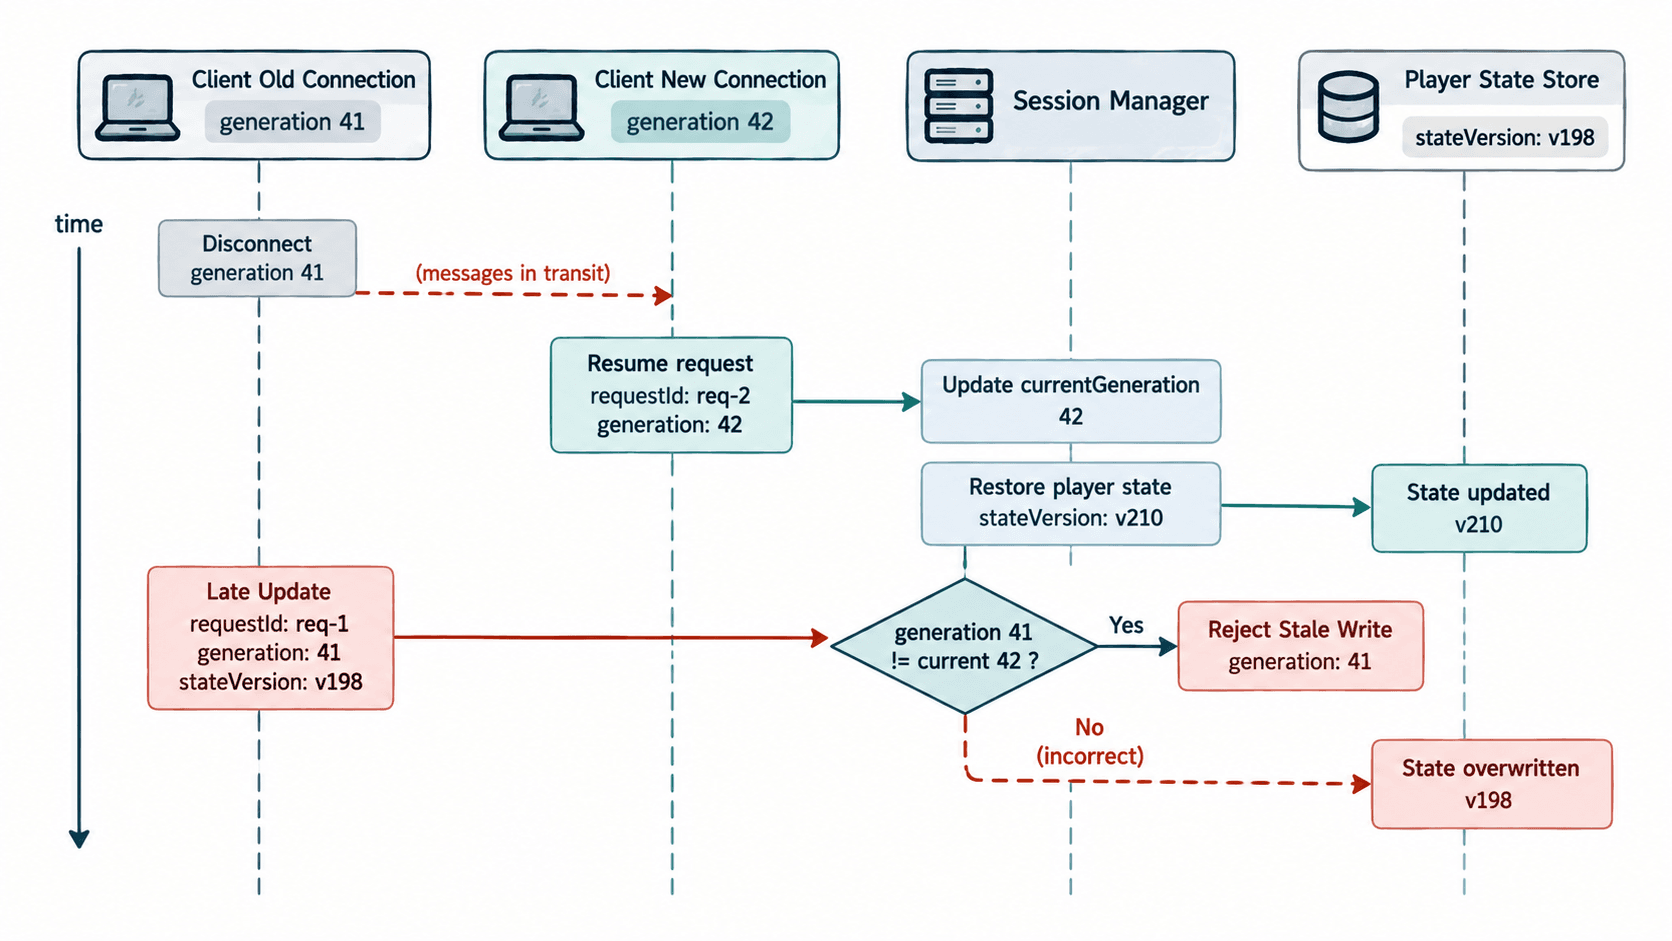
用最小模型复现旧写入
下面示例模拟服务端状态存储。每次成功重连都会提升 current_generation;任何来自旧代次的写入都直接拒绝。
from dataclasses import dataclass

@dataclass
class PlayerState:
    current_generation: int
    version: int
    hp: int

def apply_update(state: PlayerState, generation: int, version: int, hp: int) -> bool:
    # 只有当前连接代次可以提交状态,先挡住旧会话迟到消息。
    if generation != state.current_generation:
        return False
    if version <= state.version:
        return False

    state.version = version
    state.hp = hp
    return True

state = PlayerState(current_generation=42, version=210, hp=80)

print(apply_update(state, generation=41, version=198, hp=20))
print(apply_update(state, generation=42, version=211, hp=75))
print(state)
预期输出
False
True
PlayerState(current_generation=42, version=211, hp=75)这里有两层门禁:generation 防旧连接,version 防同一连接内的重复或回退写入。只做其中一层都不够稳妥。
给恢复请求加幂等边界
多次点击重连、网络抖动或超时重试,可能让同一个恢复请求到达两次。服务端应把 requestId 与玩家当前恢复结果关联:同一个 requestId 再次到达时返回已完成结果,而不是重复执行“恢复房间、恢复状态、注册连接”这一整套副作用。
如果两个不同 requestId 几乎同时发起恢复,则需要在玩家或会话维度串行化关键更新。常见做法是数据库行锁、单线程 actor、按玩家键分区的队列,或带条件更新的乐观并发控制。关键不是具体机制,而是保证“只有一个请求能推进当前代次”。
用日志验证竞态是否被封住
修复后做一次可重复的压力验证:连续触发三次重连,并人为延迟第一代连接的状态更新。日志应看到新代次先成为当前会话,旧代次迟到消息被明确拒绝,而不是静默丢弃。
建议每条关键日志同时记录 playerId、generation、requestId、stateVersion 和处理结果。验收条件是:状态版本只能单调前进;旧代次不能再写;同一恢复请求重复到达不产生第二次副作用。
如果最终状态仍会回退,就沿着“谁最后一次写入”继续追踪。只要每次写入都带连接代次和状态版本,覆盖问题就能从偶发竞态收敛为一条可以被日志直接证明的过期写入。