
多人游戏与网络同步 / 系统课时
重连循环时先看哪几个指标
重连循环时先看哪几个指标
重连循环最容易被“网络不好”这个模糊结论带偏。本篇用连接状态、重试次数、退避时间和服务端拒绝原因组成最短诊断路径,先判断客户端是否正常重试,再确认失败发生在状态机、传输层还是服务端业务层。
学习目标
- 用四类核心指标区分正常重试与异常重连循环
- 按固定顺序发现状态机卡死、退避失效和终止型拒绝
- 用结构化事件快速找出第一处异常信号
先确认重连循环是否正常推进
排查时不要先盯某一条 socket 错误,而要观察完整的一次重连周期。至少应关联记录 connectionState、attempt、backoffMs 和 rejectReason,并为同一次恢复过程附带统一的连接代次或恢复 ID。
正常情况下,连接状态会从断开进入重连,attempt 随实际连接尝试递增,失败后按照退避策略等待;恢复成功后,重试计数应被重置。如果状态长期停在 RECONNECTING,而 attempt 没有变化,通常说明状态机没有真正启动下一次连接。
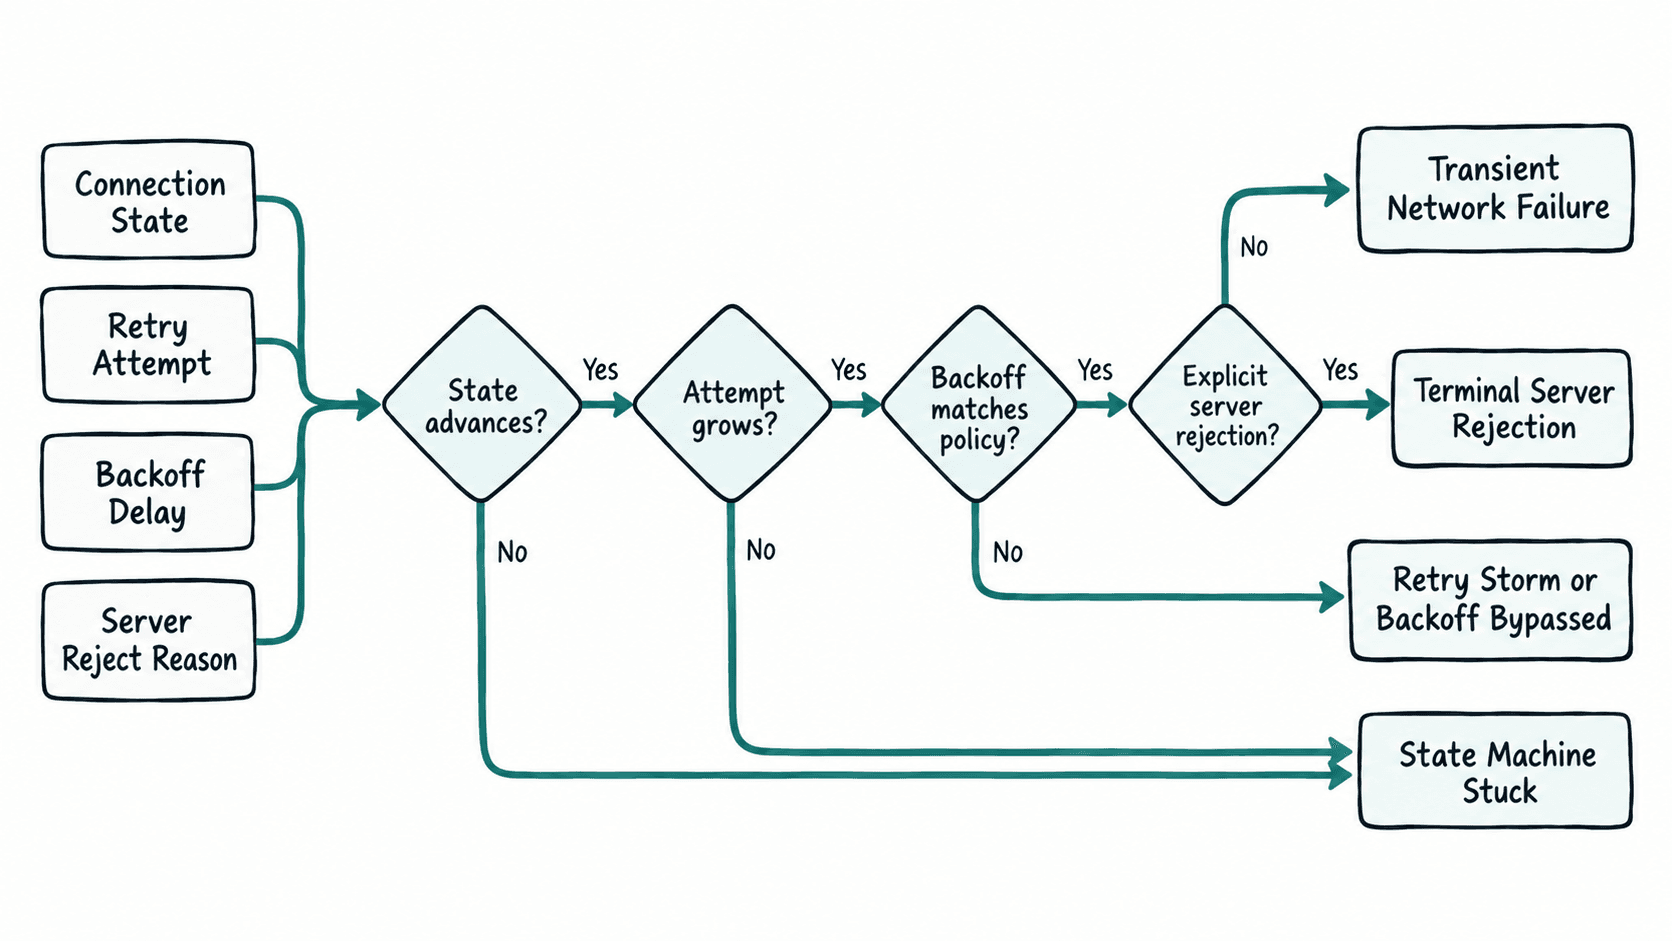
四个指标要组合起来看
connectionState 用于确认状态机到底走到了哪里。UI 显示“正在重连”并不能证明内部真的从 DISCONNECTED 进入了新的连接尝试,因此应记录实际状态迁移事件。
attempt 用来判断尝试是否持续发生。次数完全不增长通常指向调度或状态迁移问题;次数在很短时间内高速增长,则要继续查看退避是否被绕过。
backoffMs 表示下一次尝试前的等待时间。使用随机抖动时它不一定严格翻倍,但连续失败后不应长期接近 0。大量客户端无等待地重试会把局部故障放大成重连风暴。
rejectReason 则回答“服务端为什么不让恢复”。凭据失效、客户端版本不支持、房间已经关闭等终止型原因出现后,继续自动重试通常没有意义,应转到登录、更新或返回大厅等明确流程。
用结构化事件发现异常模式
下面的 Python 程序演示怎样检查三个高价值信号:重试次数是否递增、退避是否被绕过,以及出现终止型拒绝后是否应该停止重试。示例数据可以替换为测试环境导出的结构化事件。
events = [
    {'state': 'RECONNECTING', 'attempt': 1, 'backoffMs': 500, 'rejectReason': None},
    {'state': 'RECONNECTING', 'attempt': 2, 'backoffMs': 1000, 'rejectReason': None},
    {'state': 'RECONNECTING', 'attempt': 3, 'backoffMs': 2000, 'rejectReason': 'AUTH_INVALID'},
]

terminal_reasons = {'AUTH_INVALID', 'VERSION_UNSUPPORTED', 'ROOM_CLOSED'}

for current, nxt in zip(events, events[1:]):
    if nxt['attempt'] <= current['attempt']:
        print('attempt_not_increasing')
    if nxt['backoffMs'] == 0 and nxt['attempt'] > 1:
        print('backoff_bypassed')

last = events[-1]
if last['rejectReason'] in terminal_reasons:
    print('stop_retry:' + last['rejectReason'])
预期输出
stop_retry:AUTH_INVALID这个结果表明客户端此前的尝试次数和退避没有明显异常,真正需要处理的是服务端已经给出的认证终止原因。此时继续研究退避算法不会解决问题。
固定排查顺序缩小范围
建议始终按照同一顺序检查。先确认状态是否真正迁移;再确认 attempt 是否随每次真实连接尝试增长,并在恢复后清零;随后核对 backoffMs 是否符合当前退避策略;最后查看服务端是否给出了明确的 rejectReason。
如果前三项异常,应优先修复客户端状态机、并发重连任务、计时器或取消逻辑。如果前三项正常而服务端返回终止型原因,应停止自动重试并执行相应业务动作。只有这四项都正常但连接仍持续失败时,才值得继续深入 DNS、TLS、代理、负载均衡或服务端容量等网络与基础设施指标。