
多人游戏与网络同步 / 系统课时
用故障注入验证恢复边界
用故障注入验证恢复边界
重连方案在正常网络下通过测试并不代表可靠,真正容易出错的是边界:服务端刚重启、网络从 Wi-Fi 切到蜂窝、同一请求被重复发送,或客户端离线到增量日志已经过期。本篇用四类可重复的故障注入建立验收用例,并把每种故障对应到明确的恢复结果和不变量。
学习目标
- 为服务端重启、网络切换、重复请求和长时间离线设计可重复的故障场景。
- 用“注入故障 → 触发重连 → 检查恢复路径 → 校验不变量”的顺序验证边界。
- 区分哪些场景应增量恢复,哪些必须全量同步或依赖幂等结果。
先定义恢复不变量
故障注入不是随机把连接弄坏,而是验证系统在故障之后仍满足关键不变量。至少应覆盖三类结果:玩家最终看到的权威状态一致;同一个 requestId 不会产生两次业务副作用;当服务端无法保证增量日志连续时,客户端会回退到全量快照,而不是继续应用有缺口的数据。
测试环境还要固定构建版本、地图或房间、初始数据和输入脚本。否则一次测试失败时,很难区分是恢复逻辑变化还是测试负载本身不同。
把四类故障放进同一验证链路
四种故障对应不同的风险点。服务端重启验证会话和快照是否能重建;网络切换验证连接变化时逻辑会话是否保持;重复请求验证幂等;长时间离线验证增量窗口过期后的降级路径。
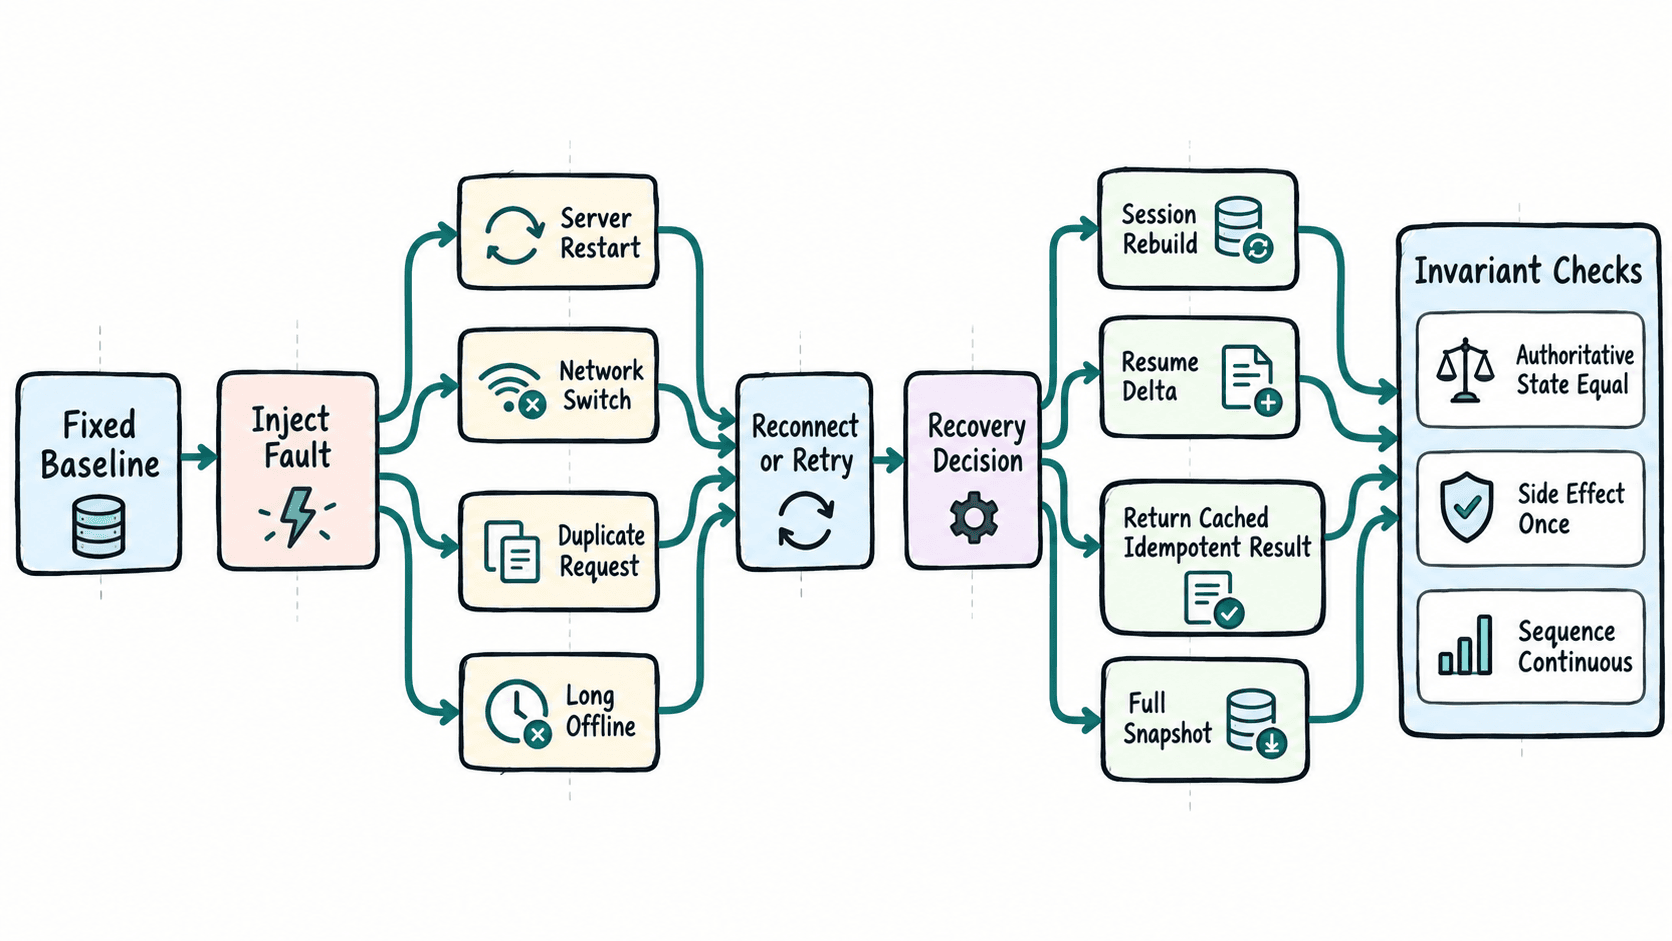
建议先把预期结果写成测试表,再实现自动化。这样测试失败时能直接判断是“恢复路径选错”还是“路径正确但状态不一致”。
| 故障 | 注入方式 | 期望恢复路径 | 必查不变量 |
|---|---|---|---|
| 服务端重启 | 清空进程内会话后重建服务 | 会话失效则全量快照 | 最终状态与权威端一致 |
| 网络切换 | 断开旧连接再建立新连接 | 会话仍有效则增量恢复 | 序列号连续,无旧连接残留写入 |
| 重复请求 | 同一 requestId 连续提交两次 |
返回已保存结果 | 业务副作用只发生一次 |
| 长时间离线 | 客户端序列落后到日志窗口之外 | 全量快照 | 不从不可用的增量起点继续 |
用确定性脚本跑四个边界
下面的 Python 脚本不依赖网络框架,而是把恢复策略做成确定性的测试模型。它的价值不是模拟真实延迟,而是把四类边界的期望判定固定下来,适合作为更高层集成测试的先验规则。
from dataclasses import dataclass

@dataclass(frozen=True)
class Case:
    name: str
    session_alive: bool
    gap_within_log_window: bool
    duplicate_request: bool

def recover(case: Case) -> tuple[str, int]:
    if case.duplicate_request:
        return "CACHED_RESULT", 1
    if not case.session_alive:
        return "FULL_SNAPSHOT", 0
    if not case.gap_within_log_window:
        return "FULL_SNAPSHOT", 0
    return "RESUME_DELTA", 0

def main() -> None:
    cases = [
        Case("server_restart", False, False, False),
        Case("network_switch", True, True, False),
        Case("duplicate_request", True, True, True),
        Case("long_offline", True, False, False),
    ]

    expected = {
        "server_restart": ("FULL_SNAPSHOT", 0),
        "network_switch": ("RESUME_DELTA", 0),
        "duplicate_request": ("CACHED_RESULT", 1),
        "long_offline": ("FULL_SNAPSHOT", 0),
    }

    for case in cases:
        result = recover(case)
        assert result == expected[case.name]
        print(f"{case.name}: {result[0]} side_effect_count={result[1]}")

if __name__ == "__main__":
    main()
预期输出:
server_restart: FULL_SNAPSHOT side_effect_count=0
network_switch: RESUME_DELTA side_effect_count=0
duplicate_request: CACHED_RESULT side_effect_count=1
long_offline: FULL_SNAPSHOT side_effect_count=0
这里的 side_effect_count=1 表示重复业务请求最终只保留一次副作用。真实集成测试中应把它替换成数据库订单数、资产变更次数或幂等记录计数,而不是只检查接口返回了成功。
把故障注入落到真实测试环境
服务端重启应在测试环境真正终止并重新启动目标进程,然后让客户端携带旧 sessionId、lastAppliedSeq 和 snapshotVersion 重连。网络切换可以通过测试代理、容器网络规则或平台提供的网络条件工具中断旧链路,再建立新链路;关键是记录故障发生前后的连接 ID 和会话 ID,确认“传输连接变了,但逻辑会话是否延续”符合设计。
重复请求不要只快速点击两次按钮,而要在第一次请求结果可能已经落库、响应却尚未被客户端确认的窗口再次发送同一 requestId。长时间离线则要显式推进服务端状态,直到旧客户端的 lastAppliedSeq 早于可保留日志的最小序列号,验证服务端明确返回全量恢复路径。
验收时同时看路径与最终状态
只看“重新进入游戏了”会漏掉很多问题。每个用例至少应记录故障类型、旧连接 ID、新连接 ID、sessionId、恢复起始序列、使用的 snapshotVersion、requestId 以及最终校验结果。日志里出现了正确分支,但最终状态仍不一致,说明问题发生在快照应用、增量重放或业务幂等执行阶段。
当四类故障都能稳定复现,并且每次都落到预期恢复路径、序列连续、权威状态一致、业务副作用不重复时,恢复方案才算覆盖了常见边界。任何依赖“多试几次通常能回来”的路径,都还没有达到可发布的验证标准。