
多人游戏与网络同步 / 系统课时
检查上线前的重连指标
检查上线前的重连指标
上线前不能只验证“能重新连上”。这一步要把重连是否成功、多久恢复、为什么失败、是否重复执行操作,以及恢复后状态校正幅度统一量化,最终形成可重复执行的发布门禁,而不是靠几次人工体验判断。
学习目标
- 为重连成功率、恢复耗时和失败原因定义可统计口径
- 用重复操作与状态校正指标发现“表面成功、实际异常”的恢复
- 把指标阈值、样本条件和发布结论固化为可回归的门禁
先把指标绑定到恢复阶段
一条完整恢复链路通常经历断线识别、传输层重连、会话恢复、房间或比赛重新绑定、快照应用、增量补放,最后进入可操作状态。指标必须绑定到这些阶段,否则“连接成功”会掩盖房间未恢复、快照未应用等后续故障。
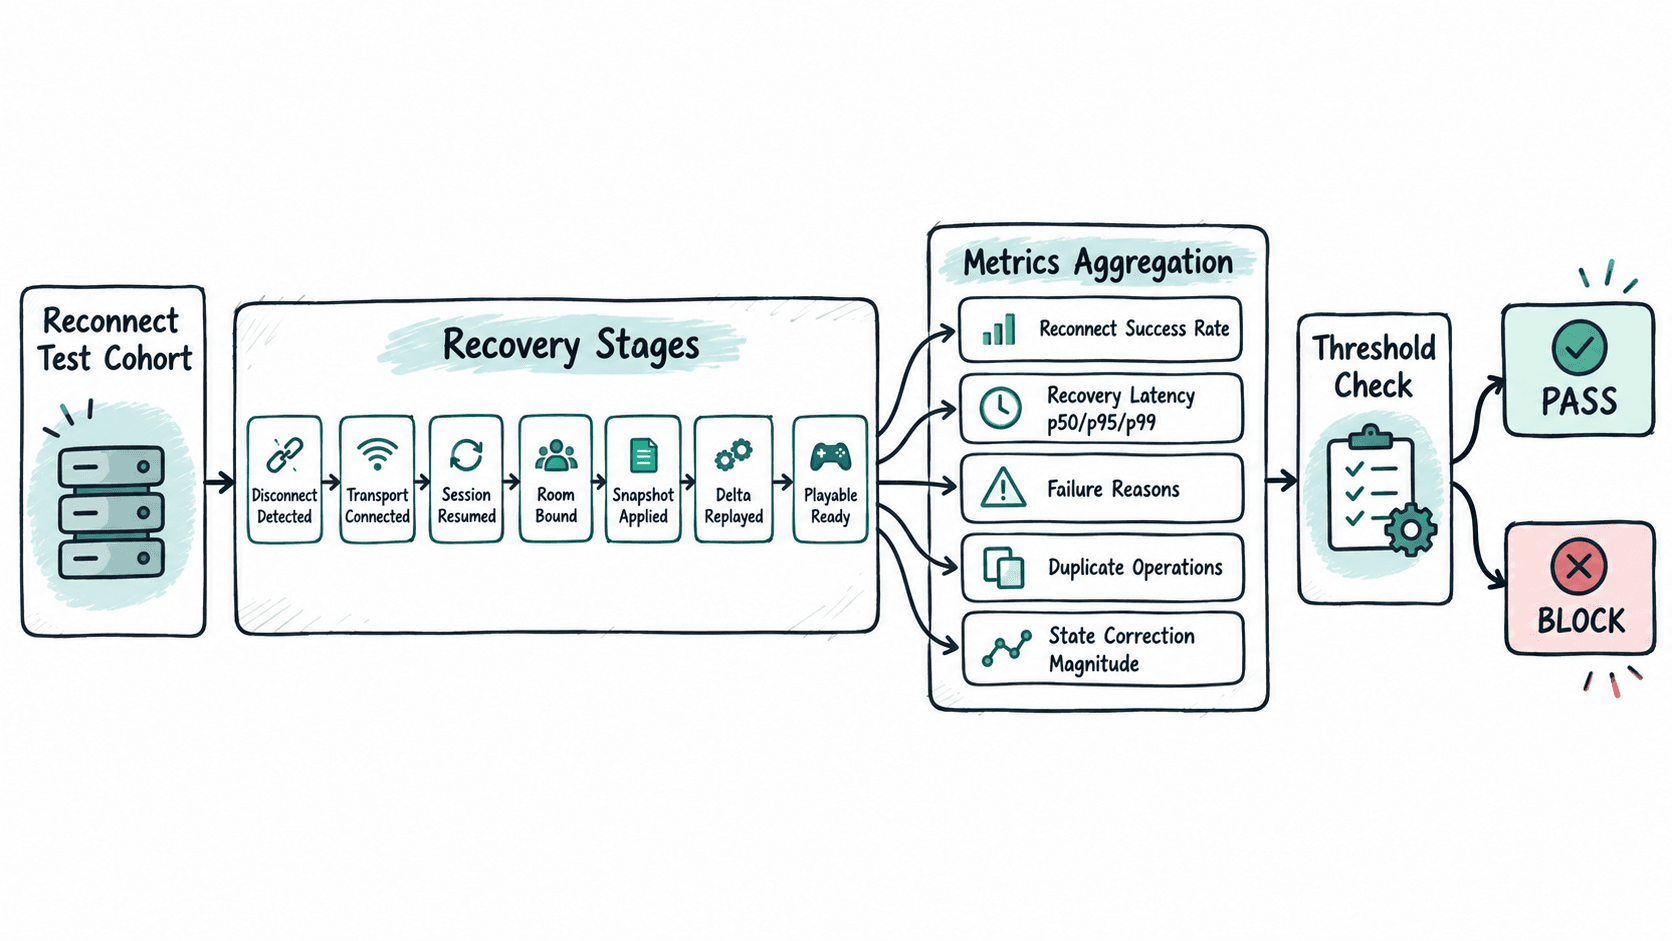
成功率的分母要先定义“哪些尝试理论上应该恢复”。例如主动退出、封禁、会话明确过期属于策略性终止,不应和网络抖动后的技术恢复失败混在同一分母里。否则版本之间即使行为没变,成功率也会因样本构成变化而失真。
统一五类发布指标
建议至少保留下表中的五类信号。阈值不要照搬示例数字,而应来自稳定版本基线、产品目标和真实网络分布;发布比较时必须保证版本、地图、玩家数、弱网条件和演练脚本一致。
| 指标 | 推荐口径 | 主要发现的问题 |
|---|---|---|
| 重连成功率 | 可恢复尝试中最终进入 READY 的比例 |
重连链路整体退化 |
| 恢复耗时 | 从 disconnectDetectedAt 到 playableReadyAt 的 p50/p95/p99 |
长尾卡顿、重试过多 |
| 失败原因 | 终止阶段与稳定枚举 failureReason 的计数 |
凭据、房间、快照等集中故障 |
| 重复操作 | 同一 requestId 被业务层实际执行超过一次的次数 |
幂等失效、重放副作用 |
| 状态校正 | 权威状态应用后的位置、资源或序列差异分布 | 预测漂移、快照或增量缺口 |
failureReason 应使用稳定枚举,例如 transport_timeout、session_invalid、room_not_found、snapshot_timeout、sequence_gap,不要直接把自由文本错误消息当聚合维度。自由文本可留作诊断详情,但不适合跨版本统计。
用同一批样本计算门禁
下面的 Python 示例用三次演练记录计算成功率、p95 恢复耗时、失败原因、重复操作和位置校正 p95,并给出一个示例门禁结论。真实项目应把输入替换为测试平台导出的结构化记录。
from collections import Counter
from math import ceil

runs = [
    {'outcome': 'success', 'recovery_ms': 1200, 'failure_reason': None,
     'duplicate_ops': 0, 'correction_m': 0.12},
    {'outcome': 'failed', 'recovery_ms': None, 'failure_reason': 'session_invalid',
     'duplicate_ops': 0, 'correction_m': None},
    {'outcome': 'success', 'recovery_ms': 2400, 'failure_reason': None,
     'duplicate_ops': 1, 'correction_m': 0.75},
]

def percentile_nearest_rank(values, percent):
    values = sorted(values)
    index = max(0, ceil(percent / 100 * len(values)) - 1)
    return values[index]

attempts = len(runs)
successes = [run for run in runs if run['outcome'] == 'success']
recovery = [run['recovery_ms'] for run in successes]
corrections = [run['correction_m'] for run in successes]
reasons = Counter(run['failure_reason'] for run in runs if run['failure_reason'])

success_rate = len(successes) / attempts * 100
recovery_p95 = percentile_nearest_rank(recovery, 95)
correction_p95 = percentile_nearest_rank(corrections, 95)
duplicate_ops = sum(run['duplicate_ops'] for run in runs)

passed = (
    success_rate >= 95
    and recovery_p95 <= 3000
    and duplicate_ops == 0
    and correction_p95 <= 0.50
)
gate = 'PASS' if passed else 'BLOCK'

print(f'attempts={attempts}')
print(f'success_rate={success_rate:.1f}%')
print(f'recovery_p95_ms={recovery_p95}')
print(f'failure_reasons={dict(reasons)}')
print(f'duplicate_ops={duplicate_ops}')
print(f'correction_p95_m={correction_p95:.2f}')
print(f'release_gate={gate}')
预期输出
attempts=3
success_rate=66.7%
recovery_p95_ms=2400
failure_reasons={'session_invalid': 1}
duplicate_ops=1
correction_p95_m=0.75
release_gate=BLOCK
这组样本被阻断并不是因为恢复耗时超限,而是成功率、重复操作和校正幅度都未达到示例阈值。发布门禁应同时输出失败的具体条件,避免只留下一个 BLOCK 而无法快速定位是哪类指标退化。
避免被平均值和混合样本误导
恢复耗时只看平均值很容易漏掉少数极慢重连,因此至少保留 p95,样本足够大时再看 p99。失败原因还要按客户端版本、平台、网络类型和服务器区域分组,先确认退化是否集中在某个切片。
重复操作应以服务端“实际执行次数”为准,而不是客户端“发送次数”。断线期间客户端重试同一请求并不一定是错误;真正需要阻断的是相同幂等键导致扣款、领奖、匹配提交等业务动作被执行两次。
状态校正也不能只看是否发生。多人游戏恢复后出现小幅位置纠正可能正常,但突然出现长距离拉回、资源回滚或序列号大跳,通常说明预测状态、快照基线或增量补放存在缺口,应单独设分布阈值和异常样本上限。
让门禁能够稳定复现
每次发布检查都要冻结测试条件,并记录 build、地图、玩家数、随机种子、断网持续时间、延迟与丢包配置,以及服务端版本。若这些输入变化,指标差异就不能直接归因于本次代码修改。
最终的发布判断应同时满足:核心恢复成功率不低于基线或目标、恢复耗时长尾未退化、未知失败原因没有异常增长、重复业务执行为零、状态校正分布处于可接受范围。只要任一关键门禁失败,就保留该次演练证据并阻断发布,而不是用其他指标的改善抵消。